iFeeling Daily
每天精选值得关注的 AI 动态
GKE 新增原生缩容至零能力
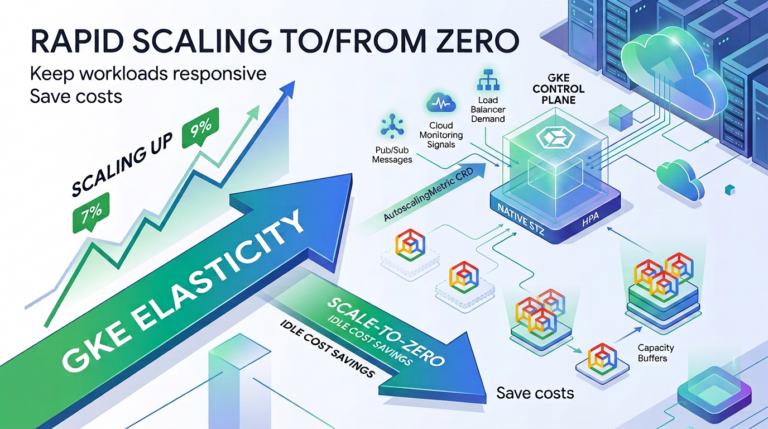
GKE 1.37 原生支持缩容至零,用容量缓冲区把冷启动从分钟级降到瞬间,配置比 KEDA 简单得多。
GPT-6的提示缓存改进
GPT-6的提示缓存升级了,默认命中率更高,新增仪表盘和诊断工具帮你快速定位缓存未命中原因,开发者最高能省下90%的输入token费用。
transformers 正式支持 GGUF 量化模型,本地推理性能逼近 llama.cpp
Hugging Face 让 transformers 直接跑 GGUF 量化模型,性能逼近 llama.cpp,在 Mac 上本地跑大模型的门槛又低了一截。
OpenAI Academy 新增多种角色的学习路径
OpenAI Academy 新增面向开发者、领导者、教育者和学生的四类课程,按岗位设计学习路径,鼓励带着真实任务练习并通过考核获得官方徽章。
用弹性 VM 提升 Apache Spark 集群可用性
Spark 集群怕型号断货?用 flexible VMs 按优先级列机器清单,Google 给出了从 n2d 落到 e2 的回退策略,还顺带讲清了配额、折扣和 AutoZone 的配合。
tokenizers v1:编码、解码与扩展性能实测
Hugging Face 重写 tokenizers v1,用位流分割替代正则、加缓存和并行化,实测单线程编码速度比 v0.23 快 3-30 倍,文章给出完整方法。
DevFest 工作坊体验:构建真实 Agent
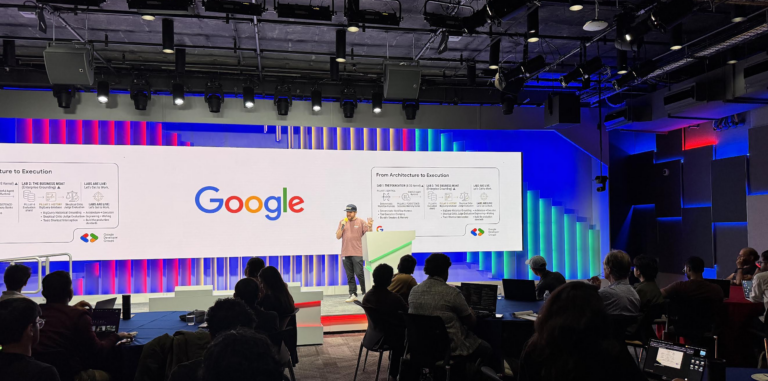
谷歌 DevFest 纽约站现场:80 名工程师用 Workbench 亲手构建自进化多智能体,放弃死记语法,聚焦状态分离、自修复与评估门控管线。
REVERSAL-BENCH:可逆性轴与重置预言机,衡量无重置 RL 的悬崖
一个专门测试无重置强化学习的基准,用可调参数卡出可逆性悬崖,发现智能体一旦进入不可逆状态就永久卡死,安全盾也难救。
DACA-GRPO:为扩散语言模型强化学习注入去噪感知信用分配
扩散语言模型强化学习的两大缺陷——时序信用缺失和似然偏差,被一个轻量插件式方法解决,在数学、代码、约束满足等七项基准上全面领先。