iFeeling Daily
每天精选值得关注的 AI 动态
使用gcs-analytics-core优化Iceberg和Spark工作负载
新开源库通过并行读取和智能预取,大幅提升GCS上Iceberg查询性能,TPC-DS测试扫描时间降低最高71.5%。
Skill Distillation:让大模型当老师,小模型当学生
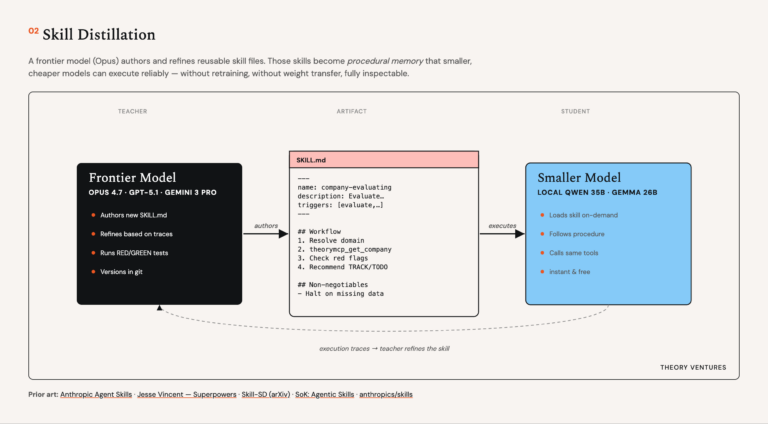
现在的大模型越来越贵,但很多任务其实不需要最强的模型来处理。这篇文章的核心痛点是:**怎么把大模型的能力迁移到本地小模型上,同时保持可维护性和可替换性**。 作者设计了一套三层架构。第一层是 QMD,一个本地…
A2UI 协议与 Gemini Enterprise 集成指南
大模型 Agent 的输出长期被困在”返回文字”的牢笼里:订餐场景要反复多轮问答而不是一个日期选择器,餐厅列表只能返回地址而不是地图,选项只能罗列文字而不能交互。这种体验瓶颈的根源在于:旧方案让 A…
PyTorch Profiling 入门:用最简单的例子学会读懂 profiler trace
PyTorch 训练和推理慢得像玄学,问题很可能出在你根本不知道时间花在了哪里。这篇文章直击这个痛点——profiler 的学习曲线太陡峭,trace 图看起来像一堵彩色的墙,大多数教程默认你已经是专家了。作者决定从最基础的…
Cloud Run 上 AI 冷启动优化实战指南
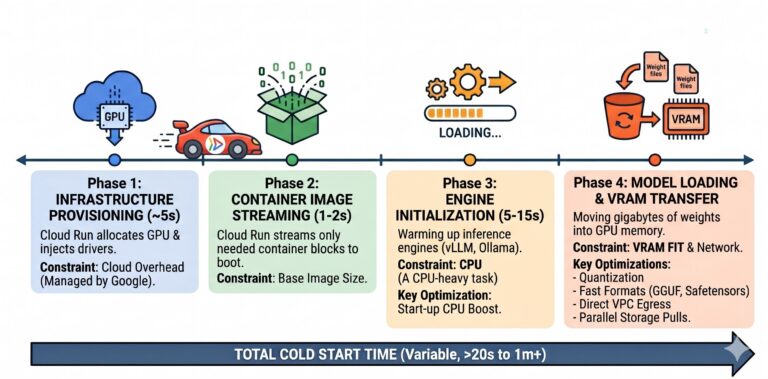
在 Cloud Run 上跑 AI 模型,冷启动 20 秒的延迟足以让用户流失。问题的根源不在模型本身,而在于对 GPU 基础设施的处理方式。 AI 冷启动分为四个阶段:基础设施配置(约 5 秒)、容器镜像流式传输(1-2 秒)、引擎…
Google SRE如何用Agentic AI改进运维
随着微服务架构普及和AI代码生成能力增强,Google内部的系统复杂度已远超过去。跨地域分布、硬件多样性、持续部署带来的频繁变更,以及开发团队交付代码量级的增长,都让传统的SRE方法面临更大压力。但AI本身也在提…
通过Hub Bucket传输万亿参数:TRL中的Delta权重同步
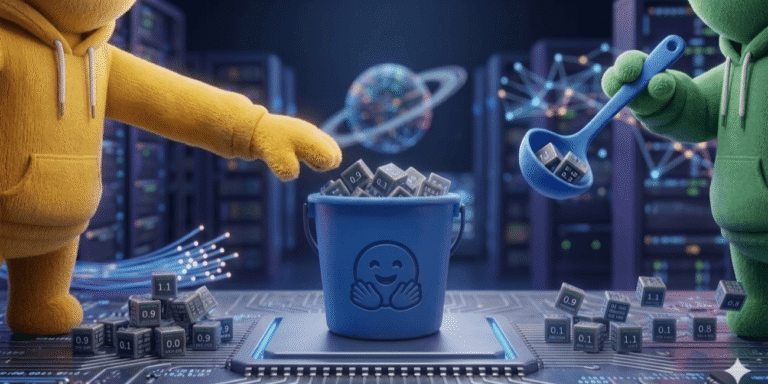
异步RL训练有个脏秘密:每一步训练器都要把整个模型发给推理引擎。一个7B模型在bf16下是14 GB,一个1T前沿模型则高达1 TB。但这篇文章证明你其实不需要这么做。核心发现来自bf16的数学特性:bf16只有7位尾数,相邻…