iFeeling Daily
每天精选值得关注的 AI 动态
OpenAI工程师拆解Codex:模型迭代周期6周,成本降至$1/百万token
OpenAI工程师用真实数据告诉你:模型发布周期从15个月缩到6周,推理成本降到$1/百万token,速度750 tokens/s。他们分享Codex如何从台上祈祷模型别崩溃进化到全自动测试验证,还抛出一个观点——未来的瓶颈是人的注意力,不是模型能力。
Runway推出AI模型路由器,应对生成式媒体拥挤市场
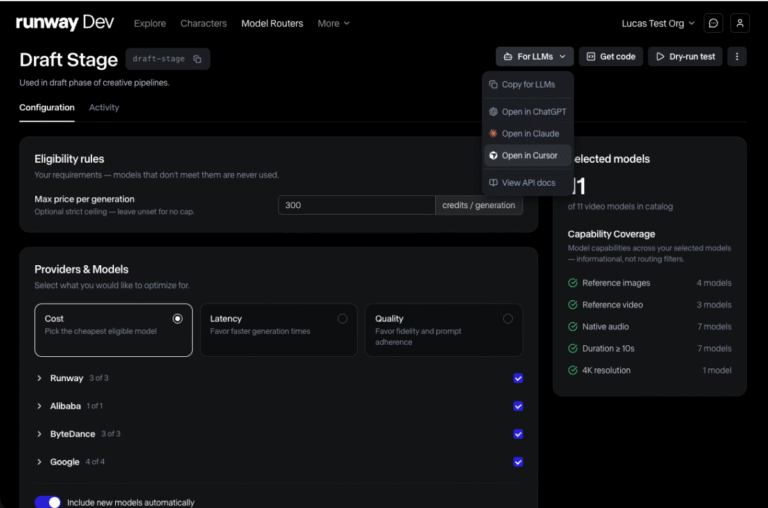
生成式媒体模型太多选不过来?Runway 推出首个媒体路由器,基于质量、速度或成本自动选择最优模型,并支持设置模型来源国偏好。
llm-d项目引入协同时间切片提升RL训练效率
分布式RL训练中GPU闲置率达60%,llm-d的协同时间切片将占空比从40%提升至70%,无需修改模型框架即可实现硬件利用率接近翻倍。
AI工程生产力的三个层级:从20%到8x
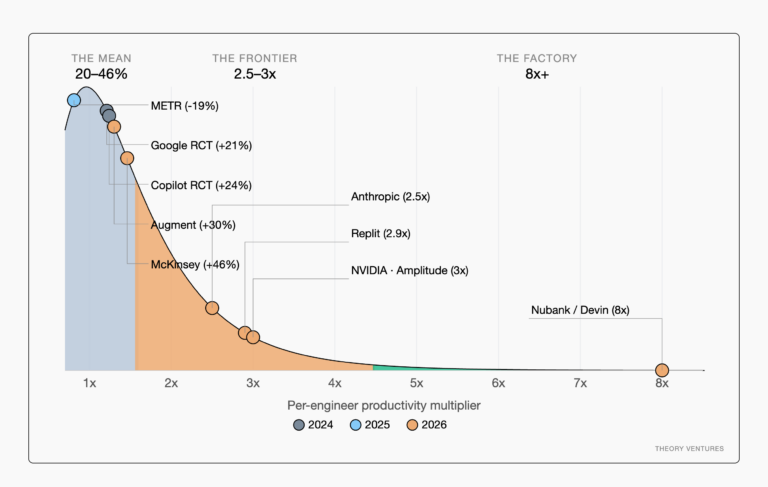
AI工程生产力实测数据:IDE仅提升20-46%,构建Agent层达3x,工厂级8x+。差距不在模型而在运营纪律。
13个Gemini企业代理平台演示
Google一口气发布了13个Agent开发实战演示,从基础搭建到生产级治理全覆盖。每个demo都能直接用,配合Agents CLI让IDE自动帮你写代码、评估、部署,省掉大量手工配置。
用BigQuery桥接SQL与Python
BigQuery的%%bqsql魔法让你在笔记本里直接用SQL查询本地pandas DataFrame,结果自动存为BigQuery DataFrame,实现零拷贝的SQL-Python链式处理。从此不用再手动搬运数据,迭代效率直接翻倍。
单层足矣:适配预训练视觉编码器用于图像生成
预训练视觉编码器跟生成模型latent空间不对付?FAE用单层注意力层就把这事搞定了,还在ImageNet上刷出FID 1.29的SOTA。核心思路是解耦特征提取和生成,用两个解码器各自干各自的事,简单又高效。
AI应用在生产环境失败的真相
YouTube工程师用“丢弃代码”策略解决了AI原型落地难题:搭建只读数据层和隔离注入通道,让95%的失败率成为设计,验证周期从季度缩短到周。不是不犯错,而是让犯错变快变安全。
GKE Autopilot集群托管DRANET:GPU和TPU集成
Google把GPU/TPU的网络配置也扔进了Kubernetes的声明式管理里。以后跑大模型,你只需要写YAML描述要什么加速器和网络类型,集群和网络自己搭好,不用手动配复杂的RDMA拓扑了。