iFeeling Daily
每天精选值得关注的 AI 动态
DeepSWE: 抗污染的编码基准测试详解
DeepSWE 基准测试用 113 个原创任务彻底区分了模型真实编码能力。James Shi 展示了 Claude 和 GPT 在任务上的显著行为差异,并解释了怎样设计验证器才能防止作弊。适合关心模型评估和编码 agent 的开发者。
Loop Engineering 从第一性原理:Kyle Mistele 的实战方法
Kyle Mistele 提出用控制理论设计智能体循环,每次只做一个小改动,产生可审查的 PR,而不是 40,000 行无人能读的代码。以迁移代码库为例,讲解如何用 ast-grep 传感器、CI 调度和反馈文件实现增量式工程。适合厌恶“盲扫”循环的工程师。
视频评估不靠打分:成对比较才是出路
Character.ai 的 Maor Bril 揭秘 AI 视频评估的坑:CLIP 评分抓不住帧间漂移,人工看片不靠谱。他们放弃打分、改用成对比较,训练 Qwen3-VL 裁判在 CI 管道里拦 slop,比跑完再修便宜得多。
Google团队分享Agent行为调教:Evals比Prompt更重要
Google 团队用真实广告素材案例告诉你,别迷信 prompt —— Agent 行为靠 eval 循环调教,trace 日志才是 debug 利器。
从研究到现实:DeepMind VP谈代码生成与模型推理
Benoit Schillings 在 DeepMind 演讲中直指核心:代码生成不再是瓶颈,架构和验证才是。他揭秘 DeepMind 正在用自对弈训练更聪明的模型,并提出未来模型需要具备规划和迁移知识的能力。如果你关心 AI 如何从研究走向真实应用,这 20 分钟干货满满。
Simon Willison 对话 Claude Code 团队:Agent 编程重塑开发
Simon Willison 和 Anthropic 的 Claude Code 团队聊透了 Agent 编程如何改变日常开发:从写每一行代码到管理模型输出,Slack 里的 Claude Tag 已经能搞定 65% 的产品 PR。顺便还讨论了为什么重写不再是罪、开发者应该更敢想。
不要构建你无法负责的Agent
Addy Osmani 在 keynote 里直接挑战了 AI 代碼狂潮:别盲目堆 Agent,先想清楚你能不能为自己的系统负责。他给出了一个简单粗暴的规则——“解释不了就别发布”,并重新定义了工程师的核心竞争力是判断力而非代码量。
代码行动,证明信任:Erik Meijer的AI Agent形式化安全方案
Erik Meijer(Haskell/LINQ/Rx 之父)说现在的 AI agent 就像没系安全带的跑车。他正在用形式化证明给 agent 加装刹车——Automind 框架要求 agent 在执行任何操作前提交机器可验证的证明,从根源杜绝删库、乱报价、装木马。硬核但极度务实。
AI 模型进化后,我们到底该建什么
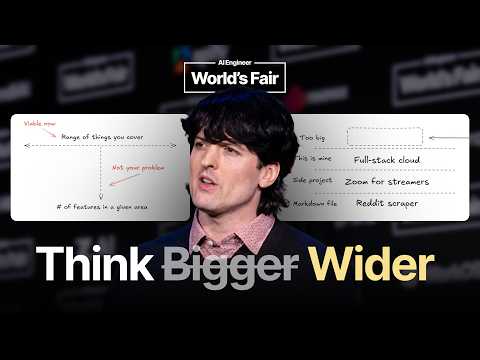
Theo Browne 在 AI Engineer World's Fair 闭幕 keynote 里喊话:模型都能编排了,你还搁那折腾 Git 和终端?他拿 iOS 拟物化转型做对比,提出新分层法——小需求用 Markdown+cron 搞定,大项目直接对标 AWS。不换思路就别玩了。