微调Nemotron,同一模型家族拿下IOI与IMO双金牌
国际信息学奥赛(IOI)和国际数学奥赛(IMO)考察的能力截然不同:前者要求算法代码在严格时间与提交限制下通过隐藏测试;后者要求严谨的自然语言证明。单一领域登顶已很难,同时达到金牌水平说明模型具备更强的可塑性。新结果表明,以Nemotron为基础模型,用监督微调(SFT)、强化学习(RL)和反馈驱动推理,分别拿下了IMO 2026和IOI 2026的金牌级成绩。
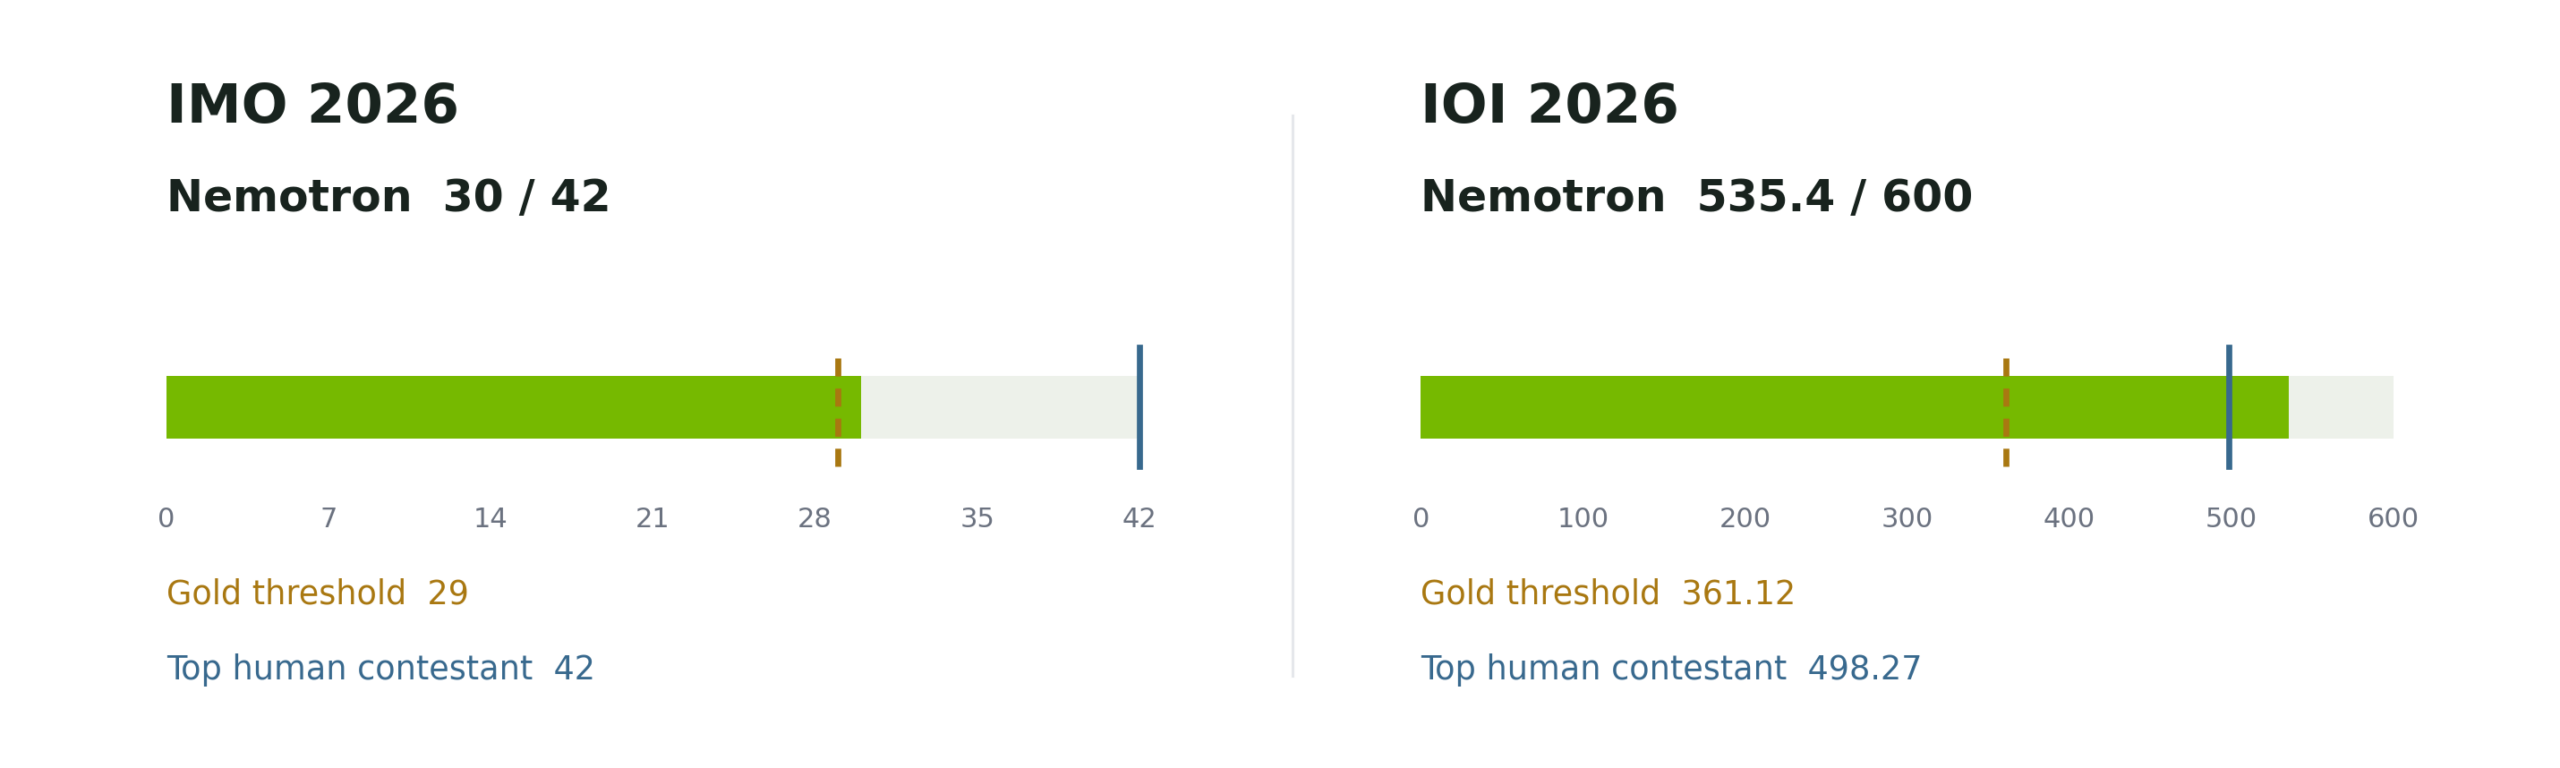
具体成绩上,IOI 2026中,Nemotron-3-Ultra-CC 使用SFT加GenCorrect拿到 535.4/600,远超金牌线361.12,也高于人类最高分498.27。IMO 2026中,由通用模型、SFT和RL检查点组成的生成-验证-细化系统获得 30/42,超过官方金牌线29分。IOI成绩来自一次实时前瞻性运行,与人类选手相同的时限、网络和提交限制,但属于非官方、无监督基准,未进入官方排名;IMO提交的证明由官方评分员评定。
作者强调,易微调不应只意味着能训练,还意味着有清晰可复用的配方。两个项目共享同一套四步方法:从强大的Nemotron基座出发;整理领域问题与高质量推理轨迹;使用SFT、RL等标准后训练;将专用模型与生成-评估-改进的推理循环结合。训练和推理计算量不小,但基础步骤是熟悉且可复现的,不需要为每个挑战重新构建基座模型。
编程竞赛部分,团队整理了22,000道题,并生成合成推理轨迹,训练了两个专家模型。Nemotron-3-Nano-CC(300亿总参数、30亿激活参数)接受SFT和RL;Nemotron-3-Ultra-CC(5500亿总参数、550亿激活参数)只做SFT。IOI 2025的进度清晰展示了专业化的价值:Nano从后训练前的130分,经SFT到280分,RL后到291分;加上GenCorrect的迭代生成-评估-改进,达到468分,跨过438.3的金牌线。Ultra-CC用同样的测试时策略拿到502分。实验还显示,不同规模的最优适配路径不同:Nano的收益主要来自SFT,RL带来较小但一致的提升;而更强的Ultra模型只用一个SFT epoch,就能在IOI、ICPC和LiveCodeBench Pro上超过完全后训练的Nano。基于这一发现,用于IOI 2026的Ultra-CC系统拿到 535.4/600。
IMO项目沿用同一思路。从Nemotron 3 Ultra出发,分别训练了一个SFT专家和一个RL专家。SFT语料包含 414,890 个质量过滤示例,覆盖 15,818 道唯一证明题;数据覆盖证明生成、细化、验证和元验证,让模型学会构造论证、识别缺口、回应批评和判断证明完整性。RL模型在 9,597 道靠近能力边界的证明题上训练。开发实验中,两个后训练检查点都优于通用模型,SFT检查点在第一轮搜索最强,RL检查点整体最佳,二者互补,最终系统同时使用两个专家和通用模型。对每道题,系统生成候选证明、打分、提出批评、改进最有希望的版本,再由高计算阶段选出最终提交。整个流程完全在自然语言中进行,没有形式化证明器、外部工具或互联网访问,最终得分 30/42,其中四道题获满分,超过金牌线。
这些结果的关键在于微调与测试时计算的协同。此前IOI 2025的帖子已展示测试时计算能把开放权重模型推到金牌水平;新结果补上了另一块:更强的专用化给推理系统提供更好的候选、批评者和细化结果。在IOI,GenCorrect把微调收益通过多轮反馈放大;在IMO,使用互补的SFT和RL检查点比单纯从一个检查点采样更多更有效。奖牌不是只靠微调,也不是只靠暴力采样,而是模型、数据和推理循环共同设计的结果。
所有资源已公开。IMO 2026的Nemotron Labs集合包含SFT/RL检查点、两个训练数据集和新基准 Nemotron-IMO-Bench(200道奥林匹克级题目);论文描述训练方法和生成-验证-细化系统,NeMo-Skills仓库提供推理流程、提示、提交证明和快速入门。编程竞赛方面,Nemotron-3-Ultra-CC模型可在Hugging Face获取,IOI论文给出训练配方与GenCorrect方法,评估和推理流程也在NeMo-Skills中。这些结果共同指向一个简单判断:Nemotron能被微调成世界级领域专家,并与透明推理工作流组合,解决人类竞赛前沿的问题。