iFeeling Daily
每天精选值得关注的 AI 动态
为什么人人都能找到反对数据中心建设的理由
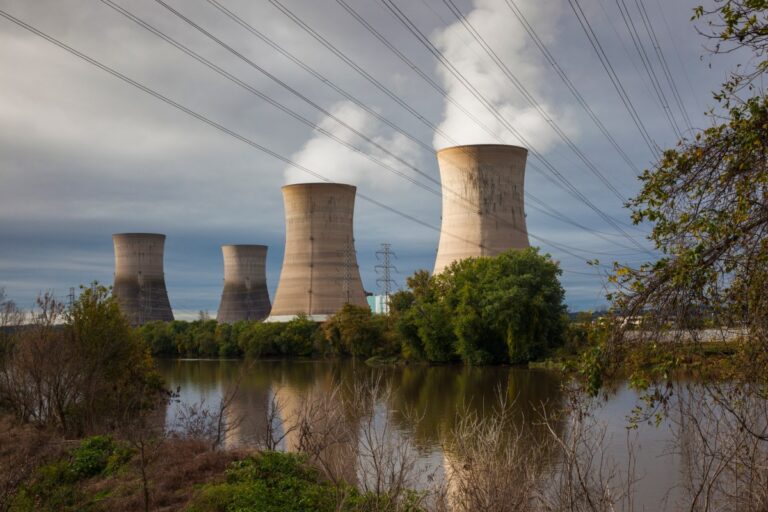
一份基于18个月访谈的研究揭示,反对数据中心的动机远超想象:电费、房价、环保甚至信任危机,不是简单的外部势力煽动。
Nscale的IPO将再度考验华尔街对集中型AI押注的胃口
英国云厂商Nscale携1030亿美元合同冲刺IPO,但85%收入来自微软和Anthropic两家客户,这种集中押注能通过华尔街检验吗?
transformers 正式支持 GGUF 量化模型,本地推理性能逼近 llama.cpp
Hugging Face 让 transformers 直接跑 GGUF 量化模型,性能逼近 llama.cpp,在 Mac 上本地跑大模型的门槛又低了一截。
oMLX 创建者加入 Hugging Face,助力 MLX 生态
oMLX 创建者 Jun 加入 Hugging Face,项目转正全职维护,转换 transformers 到 MLX 的路径将更快推进。
GKE 多集群推理网关,如何把全球 GPU 池当成一台机器?
如何用 GKE Inference Gateway 全局路由推理流量,实现跨三地域近线性吞吐扩展,且路由开销低于 1%,让全球算力池化。
用弹性 VM 提升 Apache Spark 集群可用性
Spark 集群怕型号断货?用 flexible VMs 按优先级列机器清单,Google 给出了从 n2d 落到 e2 的回退策略,还顺带讲清了配额、折扣和 AutoZone 的配合。
GKE Pod 快照:把 AI 推理冷启动最多缩短 89%
AI 推理冷启动又慢又贵?Google 新出的 GKE Pod 快照能直接保存 CPU/GPU 内存状态,70B 模型 37 秒启动,8B 只要 15 秒,客户实测从 1 分钟降到 8 秒。
V7 如何给 AI 代理赋予机构记忆
V7 用 Context Graph 把散落文档变成可查询的机构记忆,让 AI 代理几分钟跑完上百步工作流,准确率99.9%。
tokenizers v1:编码、解码与扩展性能实测
Hugging Face 重写 tokenizers v1,用位流分割替代正则、加缓存和并行化,实测单线程编码速度比 v0.23 快 3-30 倍,文章给出完整方法。