iFeeling Daily
每天精选值得关注的 AI 动态
DeepSWE: 抗污染的编码基准测试详解

DeepSWE 基准测试用 113 个原创任务彻底区分了模型真实编码能力。James Shi 展示了 Claude 和 GPT 在任务上的显著行为差异,并解释了怎样设计验证器才能防止作弊。适合关心模型评估和编码 agent 的开发者。
poolside 合成数据与预训练的真实挑战

poolside 团队亲述合成数据管道设计和预训练基础设施的踩坑实录:坏 GPU 导致曲线炸裂,BF16 精度让模型停止收敛,FP8 内核的 race condition 悄悄损坏梯度——他们的应对方案和 118B 模型早期结果。
视频评估不靠打分:成对比较才是出路

Character.ai 的 Maor Bril 揭秘 AI 视频评估的坑:CLIP 评分抓不住帧间漂移,人工看片不靠谱。他们放弃打分、改用成对比较,训练 Qwen3-VL 裁判在 CI 管道里拦 slop,比跑完再修便宜得多。
模型压缩与Agent奖励欺骗:Daniel Han详解工程陷阱

Daniel Han 用实测数据说明模型缩小 86% 仅降智 14%,并直言强化学习虽糟但不可替代。他还警告 Agent 的 Reward Hacking 问题正在让基准测试失效,未来关键在 harness 而非模型本身。
从研究到现实:DeepMind VP谈代码生成与模型推理

Benoit Schillings 在 DeepMind 演讲中直指核心:代码生成不再是瓶颈,架构和验证才是。他揭秘 DeepMind 正在用自对弈训练更聪明的模型,并提出未来模型需要具备规划和迁移知识的能力。如果你关心 AI 如何从研究走向真实应用,这 20 分钟干货满满。
OpenAI 竞赛中 AI Agent 是如何成为第一贡献者的
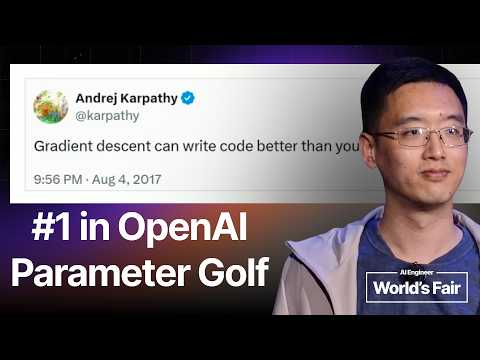
Weco AI 的自主 Agent Aiden 在 OpenAI 的模型训练竞赛中狂揽 7 项记录,成为社区被引用最多的贡献者。Zhengyao Jiang 现场拆解了 Agent 如何靠「暴力搜索+人工定义奖励」碾压千人团队,以及人类在 AI 时代的真正价值在哪。
递归模型改进:Cursor 与 AI 原生软件开发

Lee Robinson 分享了 Cursor 在递归模型改进上的实践,包括双循环训练框架、如何避免奖励黑客,以及 Agent 自动化如何改变 AI 开发效率。有实际案例和内部视角。
OpenAI工程师拆解Codex:模型迭代周期6周,成本降至$1/百万token
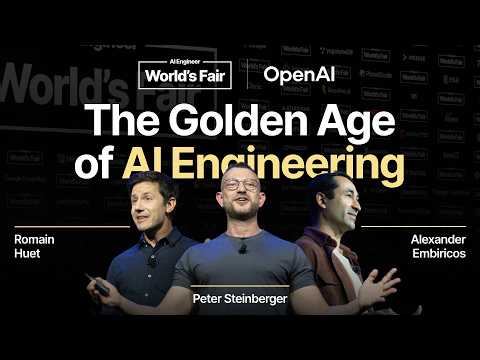
OpenAI工程师用真实数据告诉你:模型发布周期从15个月缩到6周,推理成本降到$1/百万token,速度750 tokens/s。他们分享Codex如何从台上祈祷模型别崩溃进化到全自动测试验证,还抛出一个观点——未来的瓶颈是人的注意力,不是模型能力。
Prentis AI实验室融资1亿美元,估值10亿美元

新AI实验室Prentis估值10亿美元,专注电脑操控自动化办公,声称模型成本低10倍,已签5000万美元合同。