LFM2.5-DSpark:推理提速最高3.2倍
Liquid AI 今天发布了 LFM2.5 家族三个模型的 DSpark 草稿模型 checkpoint:LFM2.5-1.2B-Instruct、LFM2.5-2.6B 和 LFM2.5-8B-A1B。这些草稿模型为原有模型增加了一条推测解码路径,用极小的内存开销换取大幅解码加速,且不改变输出质量。在 GPU 上最高获得 3.18 倍吞吐提升,在设备端最高 2.87 倍。其中 LFM2.5-2.6B 的函数调用延迟平均降低 57%,为端侧 Agent 推理铺路。DSpark 集成已以 day-one 支持的方式上游开源到 llama.cpp 和 SGLang。
DSpark 的工作原理:LLM 推理的解码阶段通常是内存瓶颈,大部分延迟来自将权重从 DRAM 流到 SRAM,而非计算本身。推测解码先用轻量草稿模型生成候选 token,再由目标模型在单次前向传播中验证所有候选,从而将权重加载成本分摊到多个 token 上。DSpark 结合了三个组件:DFlash 风格的并行主干,基于目标模型的上下文特征在单次前向传播中生成所有草稿 token 的隐藏状态;轻量顺序头,建模相邻 token 间的马尔可夫链,增加 token 间依赖,提高后段位置的接受率;一个置信度调度验证器,预测每个 token 的存活概率,当验证成本大于节省时剪除低置信度后缀。
训练与架构:Liquid AI 遵循 DSpark 配方,使用了更大更多样的数据混合,涵盖 SFT、chat、代码和函数调用数据。根据消融实验,草稿模型简化为仅注意力的模型,共 5 层,block 大小为 9。每个草稿模型在整个数据集上训练 15 个 epoch,并选择接受率最高的 epoch,而非损失最低的 epoch。草稿模型约 3 亿参数,具体参数分解:解码器主干 241.2M,隐藏状态投影 21.0M,马尔可夫头 33.6M 或 65.5M(依模型而定),归一化和置信度头 27.5k。
质量对齐:在贪婪解码下,草稿 token 只有与目标模型分布一致才被接受,拒绝时由目标模型自身的 token 替代。因此生成的序列与基线贪婪解码逐字相同,基准准确率(pass@1 或精确匹配)不变。
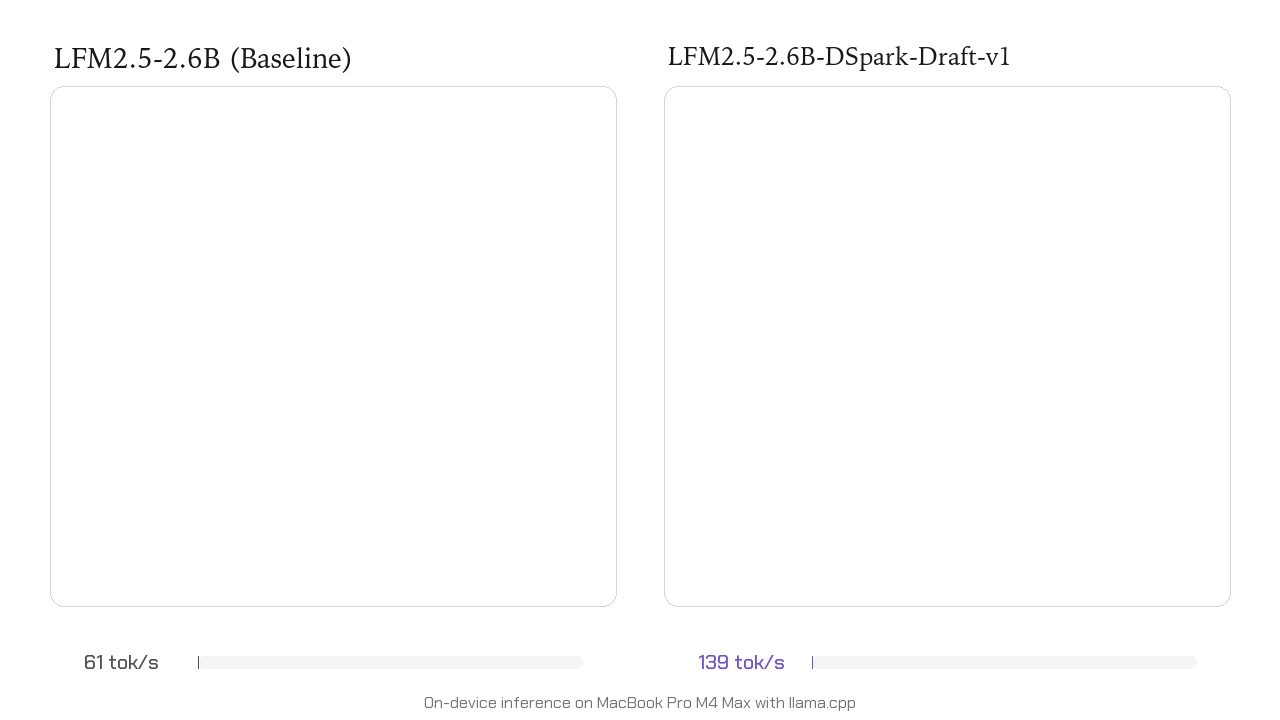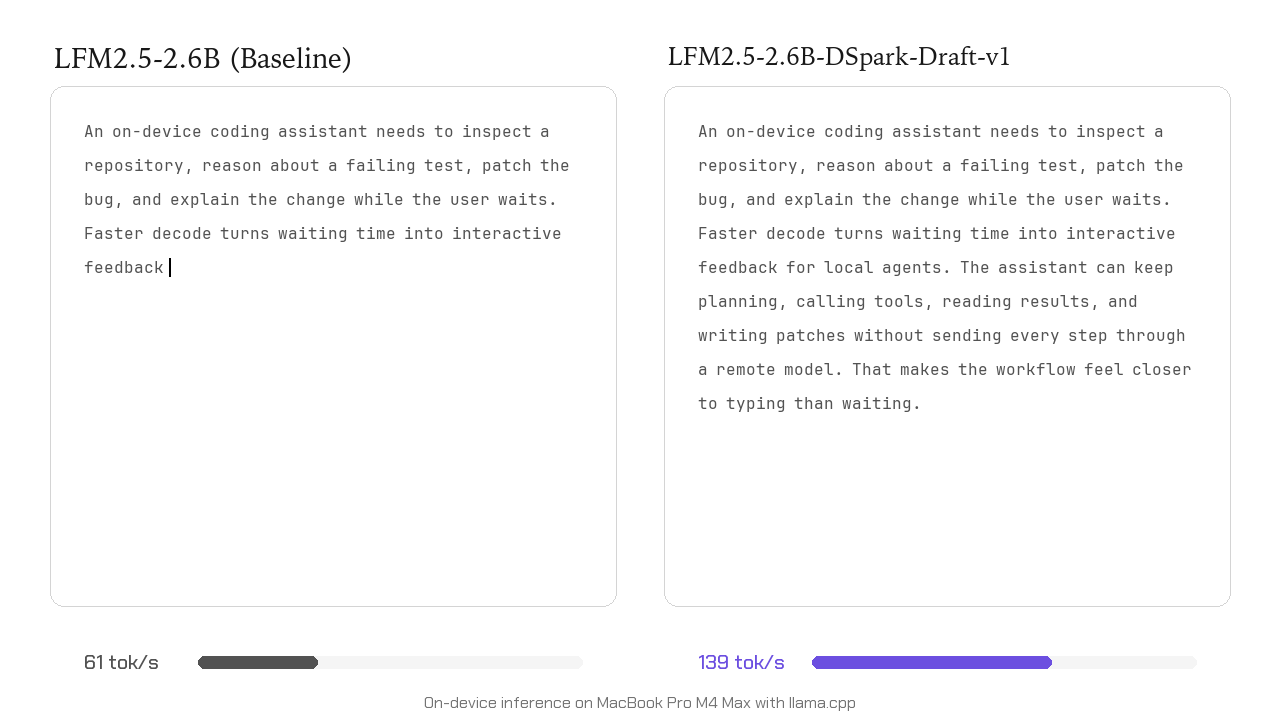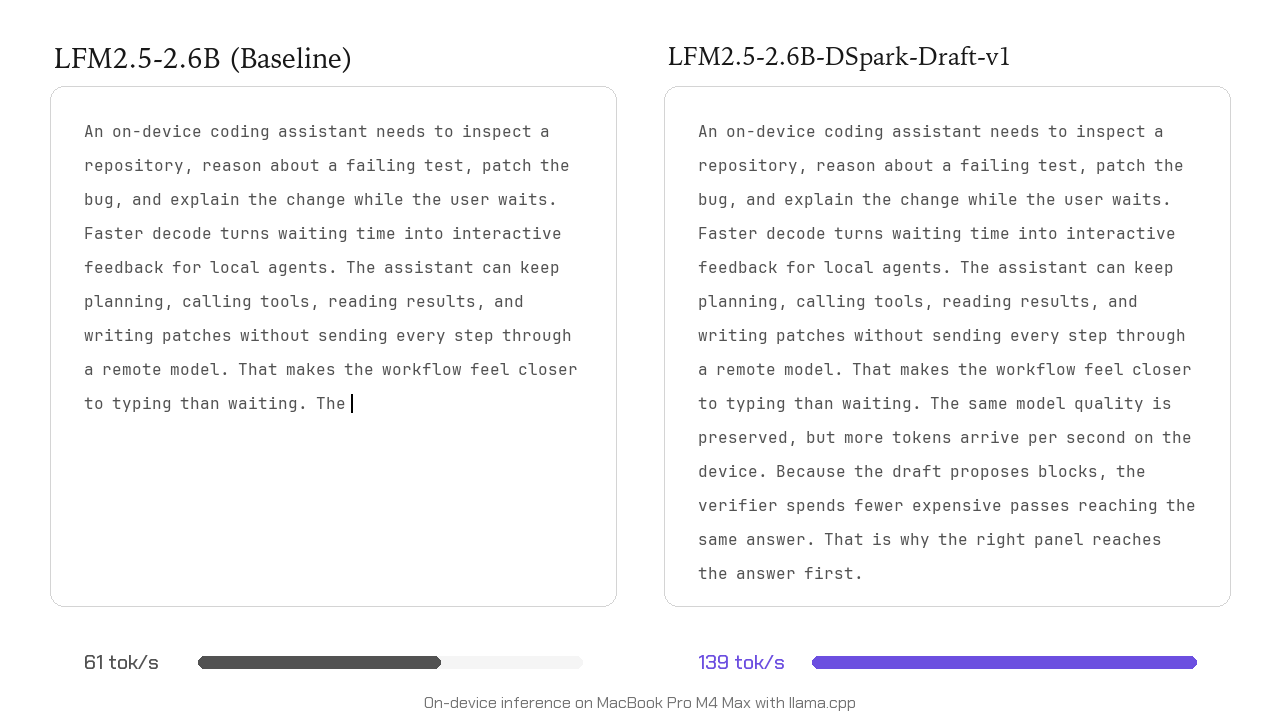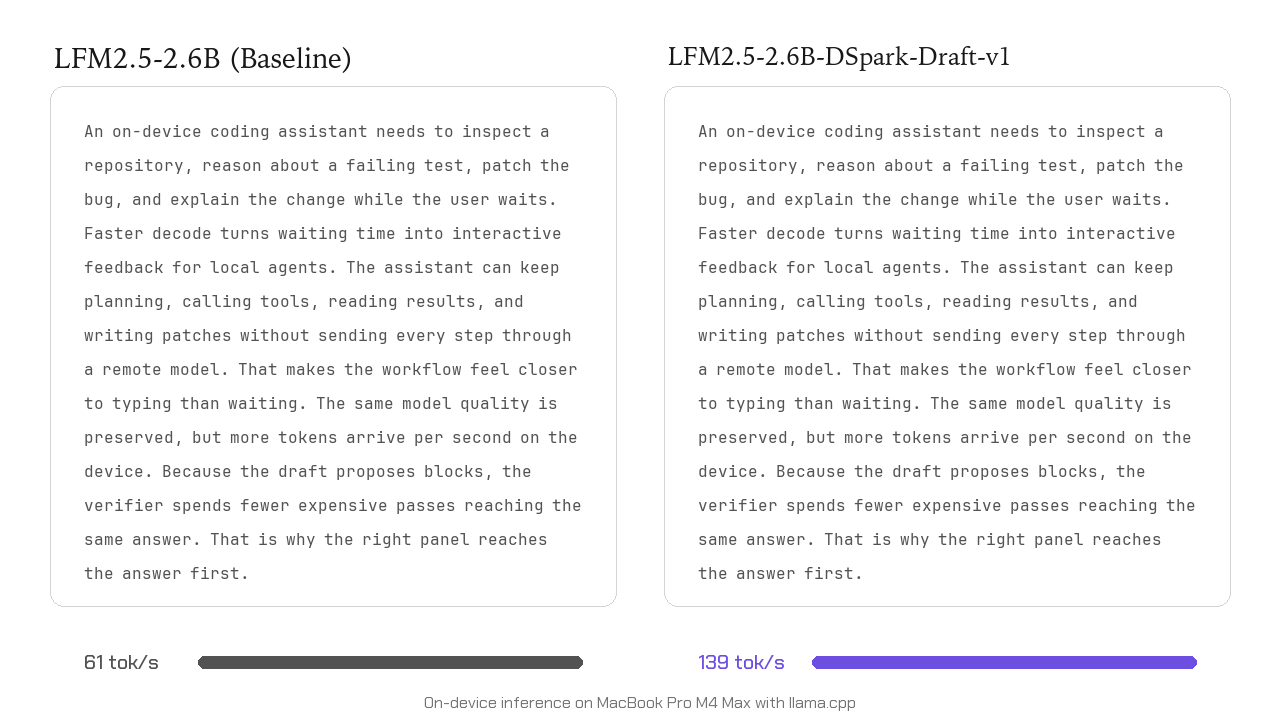
性能实测:在 H100 80GB 和 M4 Max MacBook Pro 上分别使用 SGLang 和 llama.cpp(Metal 前端)测量,FP16/BF16,block size 9,batch size 1,温度 0,五个基准数据集。对 LFM2.5-2.6B,H100 上平均接受率 4.81/10,平均加速 2.67 倍(323→864 tok/s);M4 Max 上平均加速 2.27 倍(61→139 tok/s)。在 MacBook 上该模型的交互性已超过多数专有云模型(约 140 tok/s)。对于 LFM2.5-1.2B-Instruct,接受率方差大,加速变化幅度可达 52%;H100 平均加速 2.10 倍,M4 Max 平均加速 2.54 倍。对于 LFM2.5-8B-A1B,接受率更高(平均 6.95/10),H100 上平均加速 2.54 倍,但设备端仅平均提升 18%,原因是 llama.cpp Metal 后端目前的 MoE 实现,以及验证 k 个 token 会激活更多专家,权重流量比单步解码更大。
使用方法:SGLang 需要支持 DSpark 的构建(PR #31041),启动时加上 –speculative-algorithm DSPARK 和草稿模型路径;llama.cpp 需要对应构建(PR #27383),使用 -md 指定草稿 GGUF。block size 从草稿模型的配置读取。草稿模型已发布为 Safetensors 和 GGUF 格式,可在 Hugging Face 上获取。