Vals 获 a16z 领投 4000 万美元,欲重塑 AI 基准测试标准
AI 基准测试正面临一个尴尬的局面:多数现有测试体系诞生较早,设计时并未考虑现代模型的能力,而公司又很容易针对公开测试题做针对性训练,让分数失真。Vals 这家 2024 年成立的初创公司,试图把这个体系重新做一遍。创始人 Rayan Krishnan 观察到,学术界的老基准跟不上前沿模型的迭代速度,而业内又急需一种能真实反映模型能力、可信度高的评估方式。
Vals 的核心做法有两层。第一,测试材料不公开。与很多公开题库不同,Vals 不披露具体测试题,这能在一定程度上防止公司针对题目“刷分”。第二,评估重点从抽象知识转向具体行业任务。它不只考模型懂多少知识,而是看模型能否在特定行业(如法律、金融、编程)里产出与人类同等质量的工作成果。同时,它也会评估模型的负面风险,比如如果模型不受控地运行,可能带来哪些危害。
公司还在扩展评估的边界,已经涉及递归自我改进、心理健康、网络安全、生物安全乃至武装冲突法(如如何应用日内瓦公约)等更特殊的领域。商业模式是向模型公司收费,让他们来测试自己的模型。这听起来有点反直觉——为什么要花钱听别人说自己不好?但 Krishnan 将其类比为学生付钱参加 SAT 考试:有效的测评能帮公司定位问题、持续改进。这些评估结果正在成为企业采购模型时的关键决策依据。
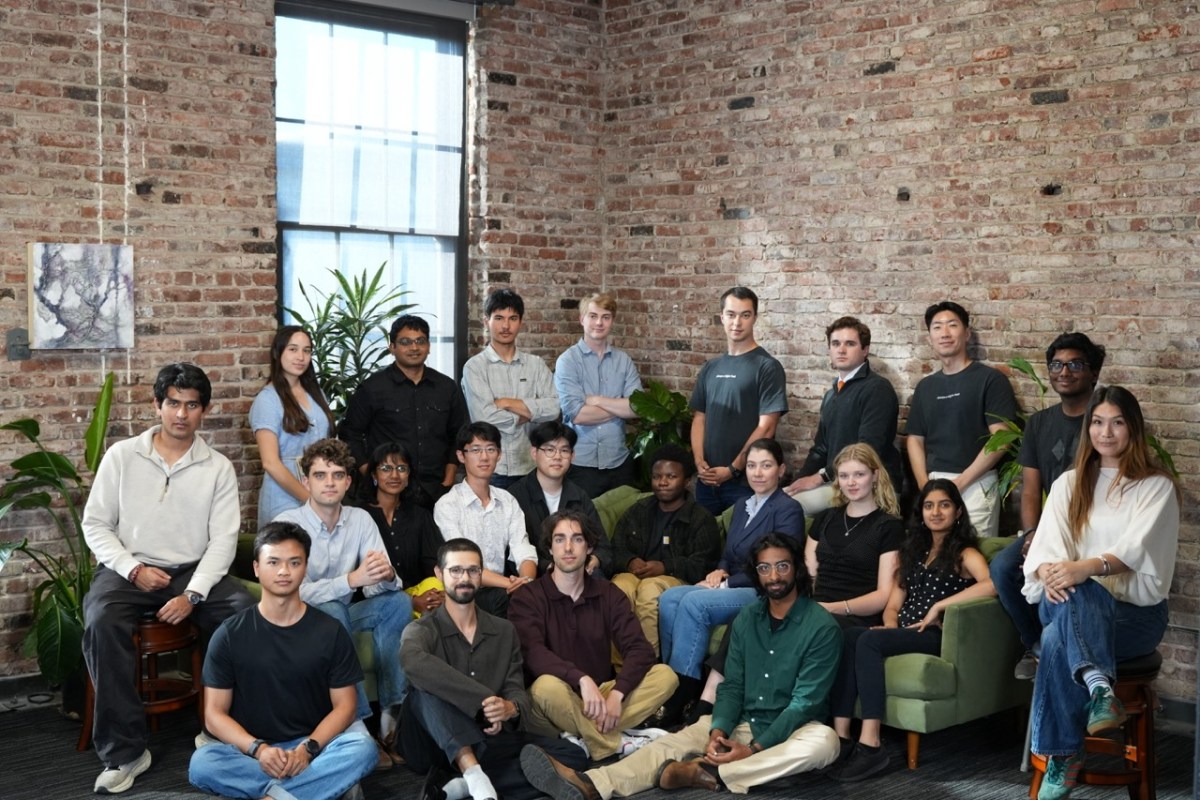
Vals 的增长数据相当直接:目前营收已是去年同期的八倍,团队从年初的 8 人扩到 25 人,还计划再招 10-15 人并搬进更大的办公室。本月早些时候,它刚拿到由 Andreessen Horowitz 领投的 4000 万美元 A 轮融资,此前还获得过 8VC 和 Bloomberg Beta 领投的种子轮。近期它还启动了面向联邦机构的模型评估项目。
在 Krishnan 看来,随着 AI 公司陆续上市(他提到 Anthropic 年内有上市计划,OpenAI 也可能跟进),基准测试和评估将成为这些公司提交公开文件、讲述投资逻辑的核心部分。当模型成为经济基础设施,评估就不只是技术工具,而是建立公共信任和商业叙事的关键环节。