IBM发布Granite时序基础模型PatchTST-FM-r2,商用许可开放
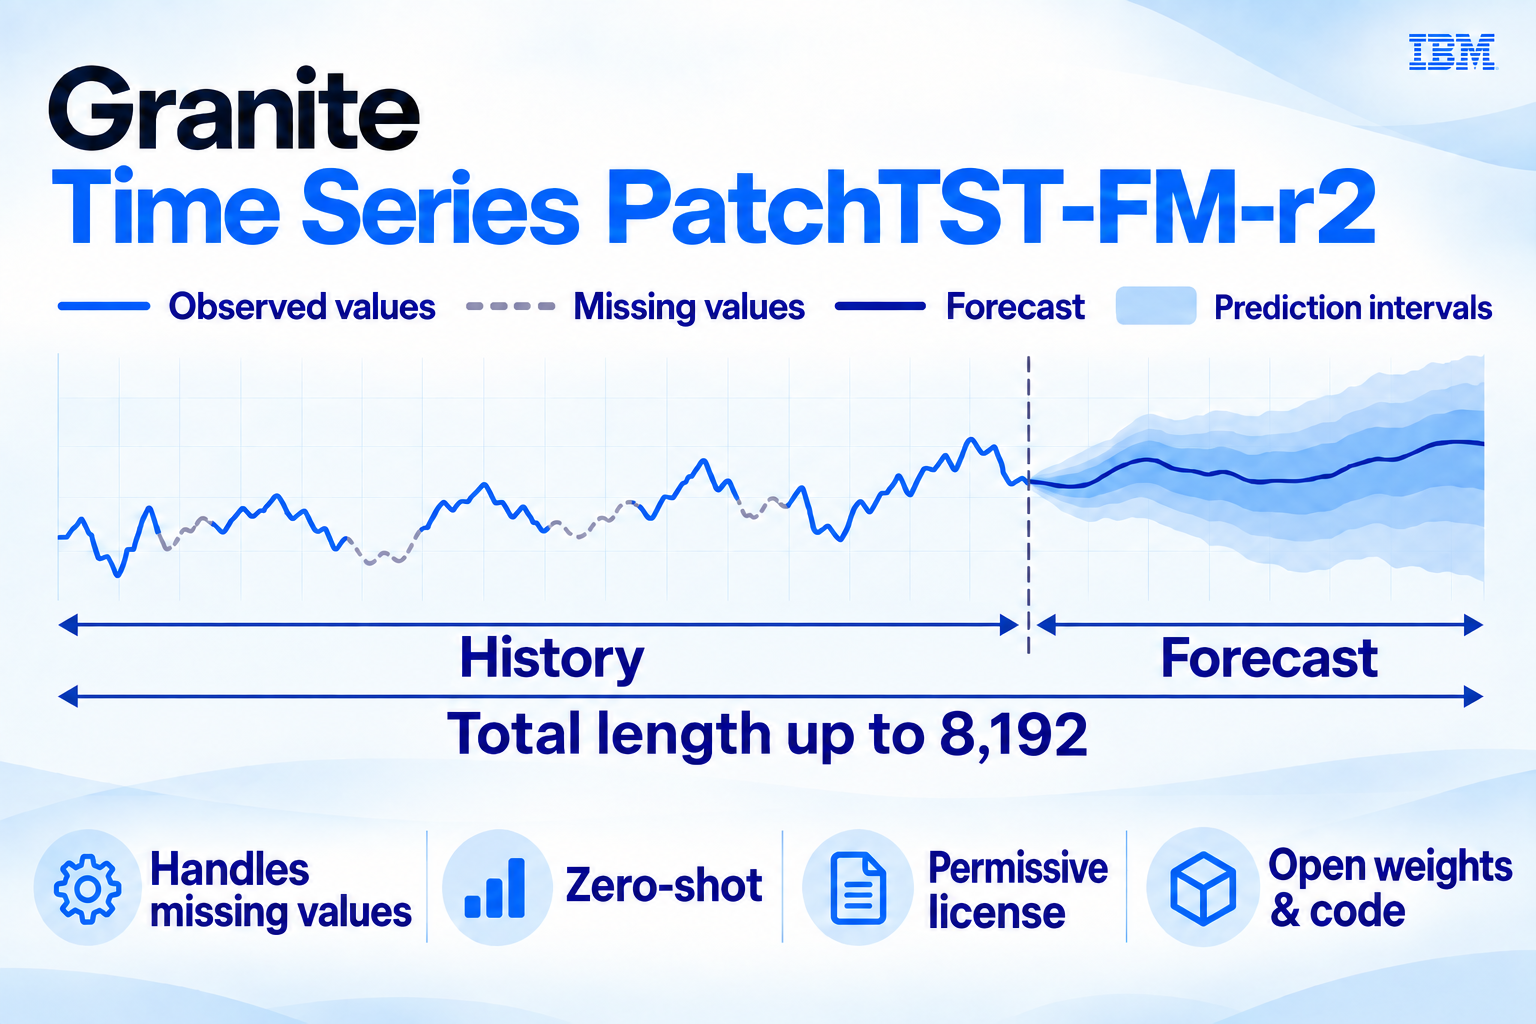
IBM 发布了 Granite 时间序列家族的新模型 PatchTST-FM-r2,定位是高性能零样本预测,并采用对商用友好的开源许可。模型约 385M 参数,支持最长 8,192 步的上下文,通过 99 分位数预测头同时输出点预测和概率分布。相比上一版 r1,骨干网络从标准 Transformer 层换成 conformer 层,并在 patch 之间加入重叠、加窗和 overlap-and-add 策略,以提升预测平滑度。
在 GIFT-Eval 基准上,截至 2026 年 9 月 8 日,PatchTST-FM-r2 在可复现的零样本模型中排名第二:几何平均 CRPS 为 0.467,MASE 为 0.6846,仅次于 TimesFM-3。如果把允许使用基准训练数据的预训练模型也纳入比较,该模型仍排到 CRPS 第 3、MASE 第 4,甚至超过 Chronos-2、Timer-S1 和部分 Toto 变体。更重要的是,在宽松商业许可的同类模型中,PatchTST-FM-r2 是当前表现最好的一个。
架构层面,r2 没有沿用 r1 的“多头自注意力 + 前馈网络”块,而是改用 conformer 块:两个半步前馈层夹着多头注意力和一层时间卷积。注意力负责捕捉 patch 之间的长程关系,卷积则用较小的感受野处理局部短时结构。IBM 用 ETTh1 数据展示了注意力图的变化:Transformer 的注意力大量集中在对角线附近,而 conformer 的注意力明显更多分布到远距离位置。骨干中卷积核大小按 {5, 5, 3, 3} 的模式交替。此外,r2 使用 50% 重叠的 patch,配合 Hamming 窗和 overlap-and-add 来柔化 patch 边界,并增加了归一化,block 数从 20 扩到 30。
训练数据方面,IBM 明确列出了四个来源:GiftEvalPretrain 中的部分数据集、基于 KernelSynth 修改周期核的合成数据、按 Chronos 方法生成但排除 GIFT-Eval 评估集的 TSMixup 语料,以及约 50 万条长度 4,096 的 CauKer 合成序列。相比很多不公开训练语料的模型,这种透明度让企业更容易做自己的治理和许可审查。官方也提醒,这不能替代企业自身的安全审查,但至少提供了更多依据。
许可上,PatchTST-FM-r2 采用 Apache 2.0 与 OpenMDW 1.0 双许可,用户可任选其一。Apache 2.0 是常见的宽松许可,OpenMDW 则是 Linux Foundation 专门为 AI 模型设计的许可框架。模型权重、架构、推理流程和复现基准的代码都已开放,并且实现与 Granite-TSFM 仓库兼容,向后兼容 r1 的 checkpoint。
上手很简单:安装 granite-tsfm(>=0.3.9)后,直接从 Hugging Face Hub 加载 ibm-granite/granite-timeseries-patchtst-fm-r2,传入最近一段历史序列即可得到未来预测和指定分位数,无需微调。应用场景覆盖需求预测、价格、能源负载、流量、遥测等规律采样的时间序列。
对于流式数据场景,IBM 与 Confluent 合作,把 Granite 系列模型(包括 PatchTST-FM-r1、FlowState-r1.1、TTM-r3、TSPulse)以 Early Access 形式接入 Confluent Cloud,通过 Apache Flink 直接在流上做推理和异常检测,不需要把数据搬到独立 ML 环境。这算是把零样本基础模型从离线 notebook 推向了生产级流处理管道。