AI 的四个问题
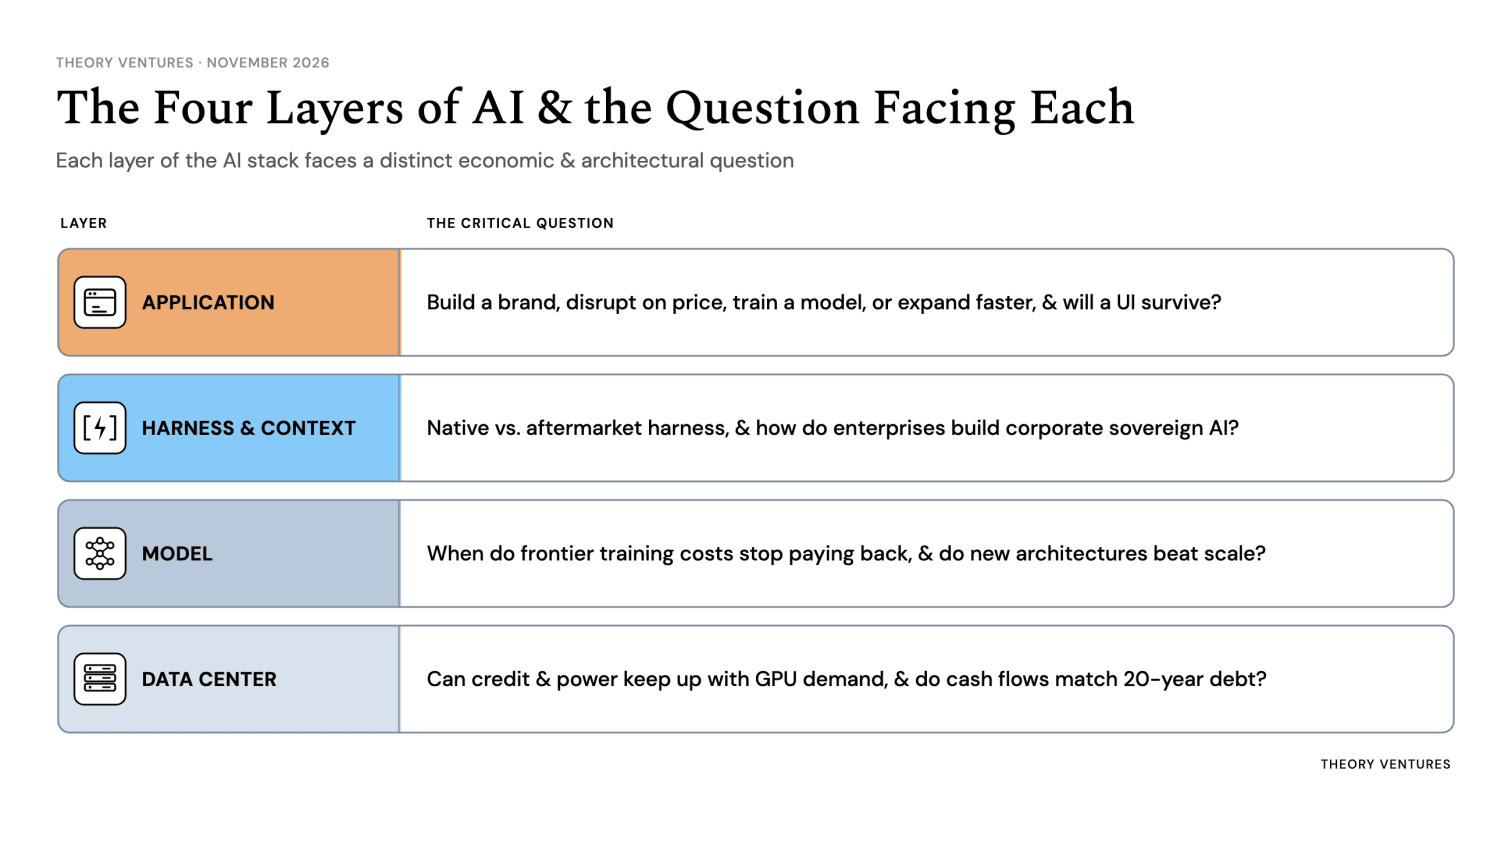
AI 产业链常被看作一条从模型到应用的直线,这篇文章把它拆成四层,提出每一层都有一个尚未回答的问题,并用市场数据说明各层之间的连带影响。
应用层的问题是如何建立护城河。突破性应用可以一夜爆发,也可能被下一次模型发布迅速抹平;当新模型吸收了某个功能,薄封装应用就会死掉。应用公司要做的选择是:建立品牌、用定价冲击现有厂商、自研模型,还是比对手扩张更快。Agent 正在用 headless 软件完成工作,这带来一个更根本的问题:用户界面还能不能存在,还是所有应用都会塌缩成中间层 harness。
如果应用塌缩成中间层,战争就在 harness 的归属上。模型厂商声称原生 harness 会赢,但同期 benchmark 显示相反:在同一周,OpenAI 和 Anthropic 的模型在 Cursor 里的得分比在各自厂商自有 harness 里更高。因为输入上下文最高占全部 token 的 98%,一个聪明的 harness 可以把同一答案的成本砍掉 71%,把毛利率从 38% 抬到 75%。企业也开始主张 harness 的所有权,目的是做 corporate sovereign AI:没有 CIO 想把公司机密放进 prompt 送出门。掌控上下文层,企业就能把记忆和权限留在内部,同时更换底层模型。
模型层的问题在于训练成本何时无法回本。训练一个 SOTA 模型要花数十亿美元;递归自我改进还没有拯救大实验室——AI 写了 Google DeepMind 75% 的生产代码,但 Google 没有在 AI 研究中看到端到端提速。需求侧,Rich Sutton 的 Bitter Lesson 认为靠大规模算力扩展的通用模型总会赢;但 SOTA 模型在公共网关上的 token 份额正在流失,因为运行成本太高。约 83% 的 agent 任务被路由到更小或领域专用模型,只为以更低账单完成单一工作。挑战者正用流程和架构攻击训练账单:一家创业公司让 coding agents 参与预训练,用一名研究员和不到 1000 万美元练出了有竞争力的 coding 模型;diffusion 架构和 JEPA 等新路径绕开了蛮力扩展——JEPA 的一个 109m 参数模型用 42 倍更少数据击败了 72b 参数的 LLM。看好继续扩展前沿的证据来自 Anthropic 的 S-1:Opus 5.5 把用户每任务成本降低 40%,而 Opus 4.5 相比 Opus 4.1 在更低的每任务成本下提供更多能力,Jevons 悖论发生,季度收入环比增速从 48% 升到 132%。
数据中心层的问题是信贷和电力能否跟上 GPU 需求。水泥价格涨了 3 倍,电网承压,涡轮机、发电机、往复式发动机都在排队;目前答案是不能。AI 不受约束的增长需要在五年内新增 4 万亿美元债务,这会让 AI 信贷市场超过全球私人信贷,相当于美国市政债券市场的 91%。还能不能找到足够多、利率还合适的贷款人?风险正在推高保险成本;五年期 CDS 利差创纪录:Meta 108 bps、Oracle 322 bps、CoreWeave 1090 bps。地方政治和电网延误卡住新站点,Ornn 的 B300 指数涨到每 GPU 小时 12.29 美元(自 6 月以来约 20% 的 CMGR)。这个层面还挂着三个问题:现金流能否匹配二十年期债务和租约、GPU 能不能用满五年、GPU 小时单价会涨还是跌。
四层不是孤立问题。顶层应用创造的巨额利润,可以支撑底部 GPU 价格和借贷成本继续上行;更高效的架构可以减少对水泥和铜的需求;GPU 价格飙升又会反过来改变整个产业链的账本。作者用双摆来比喻:四层是耦合系统,每一部分都很简单,但整体运动复杂、混沌、不可预测。