AI的广告模式:Meta用折扣换取训练数据
Meta 昨天发布了两件事:一个顶尖模型 Muse Spark 和一套基础模型的新定价体系。Muse Spark 将美国开源模型推向前沿,而定价体系则重塑了行业的经济逻辑。
过去三十年,企业软件遵循严格的许可费模式,保证完全隐私和零数据留存;消费者技术则相反——免费软件换取行为数据。消费者用查询交换便利,企业则坚决保护知识产权。现在,这一模式被引入 AI,但多了一个转折。
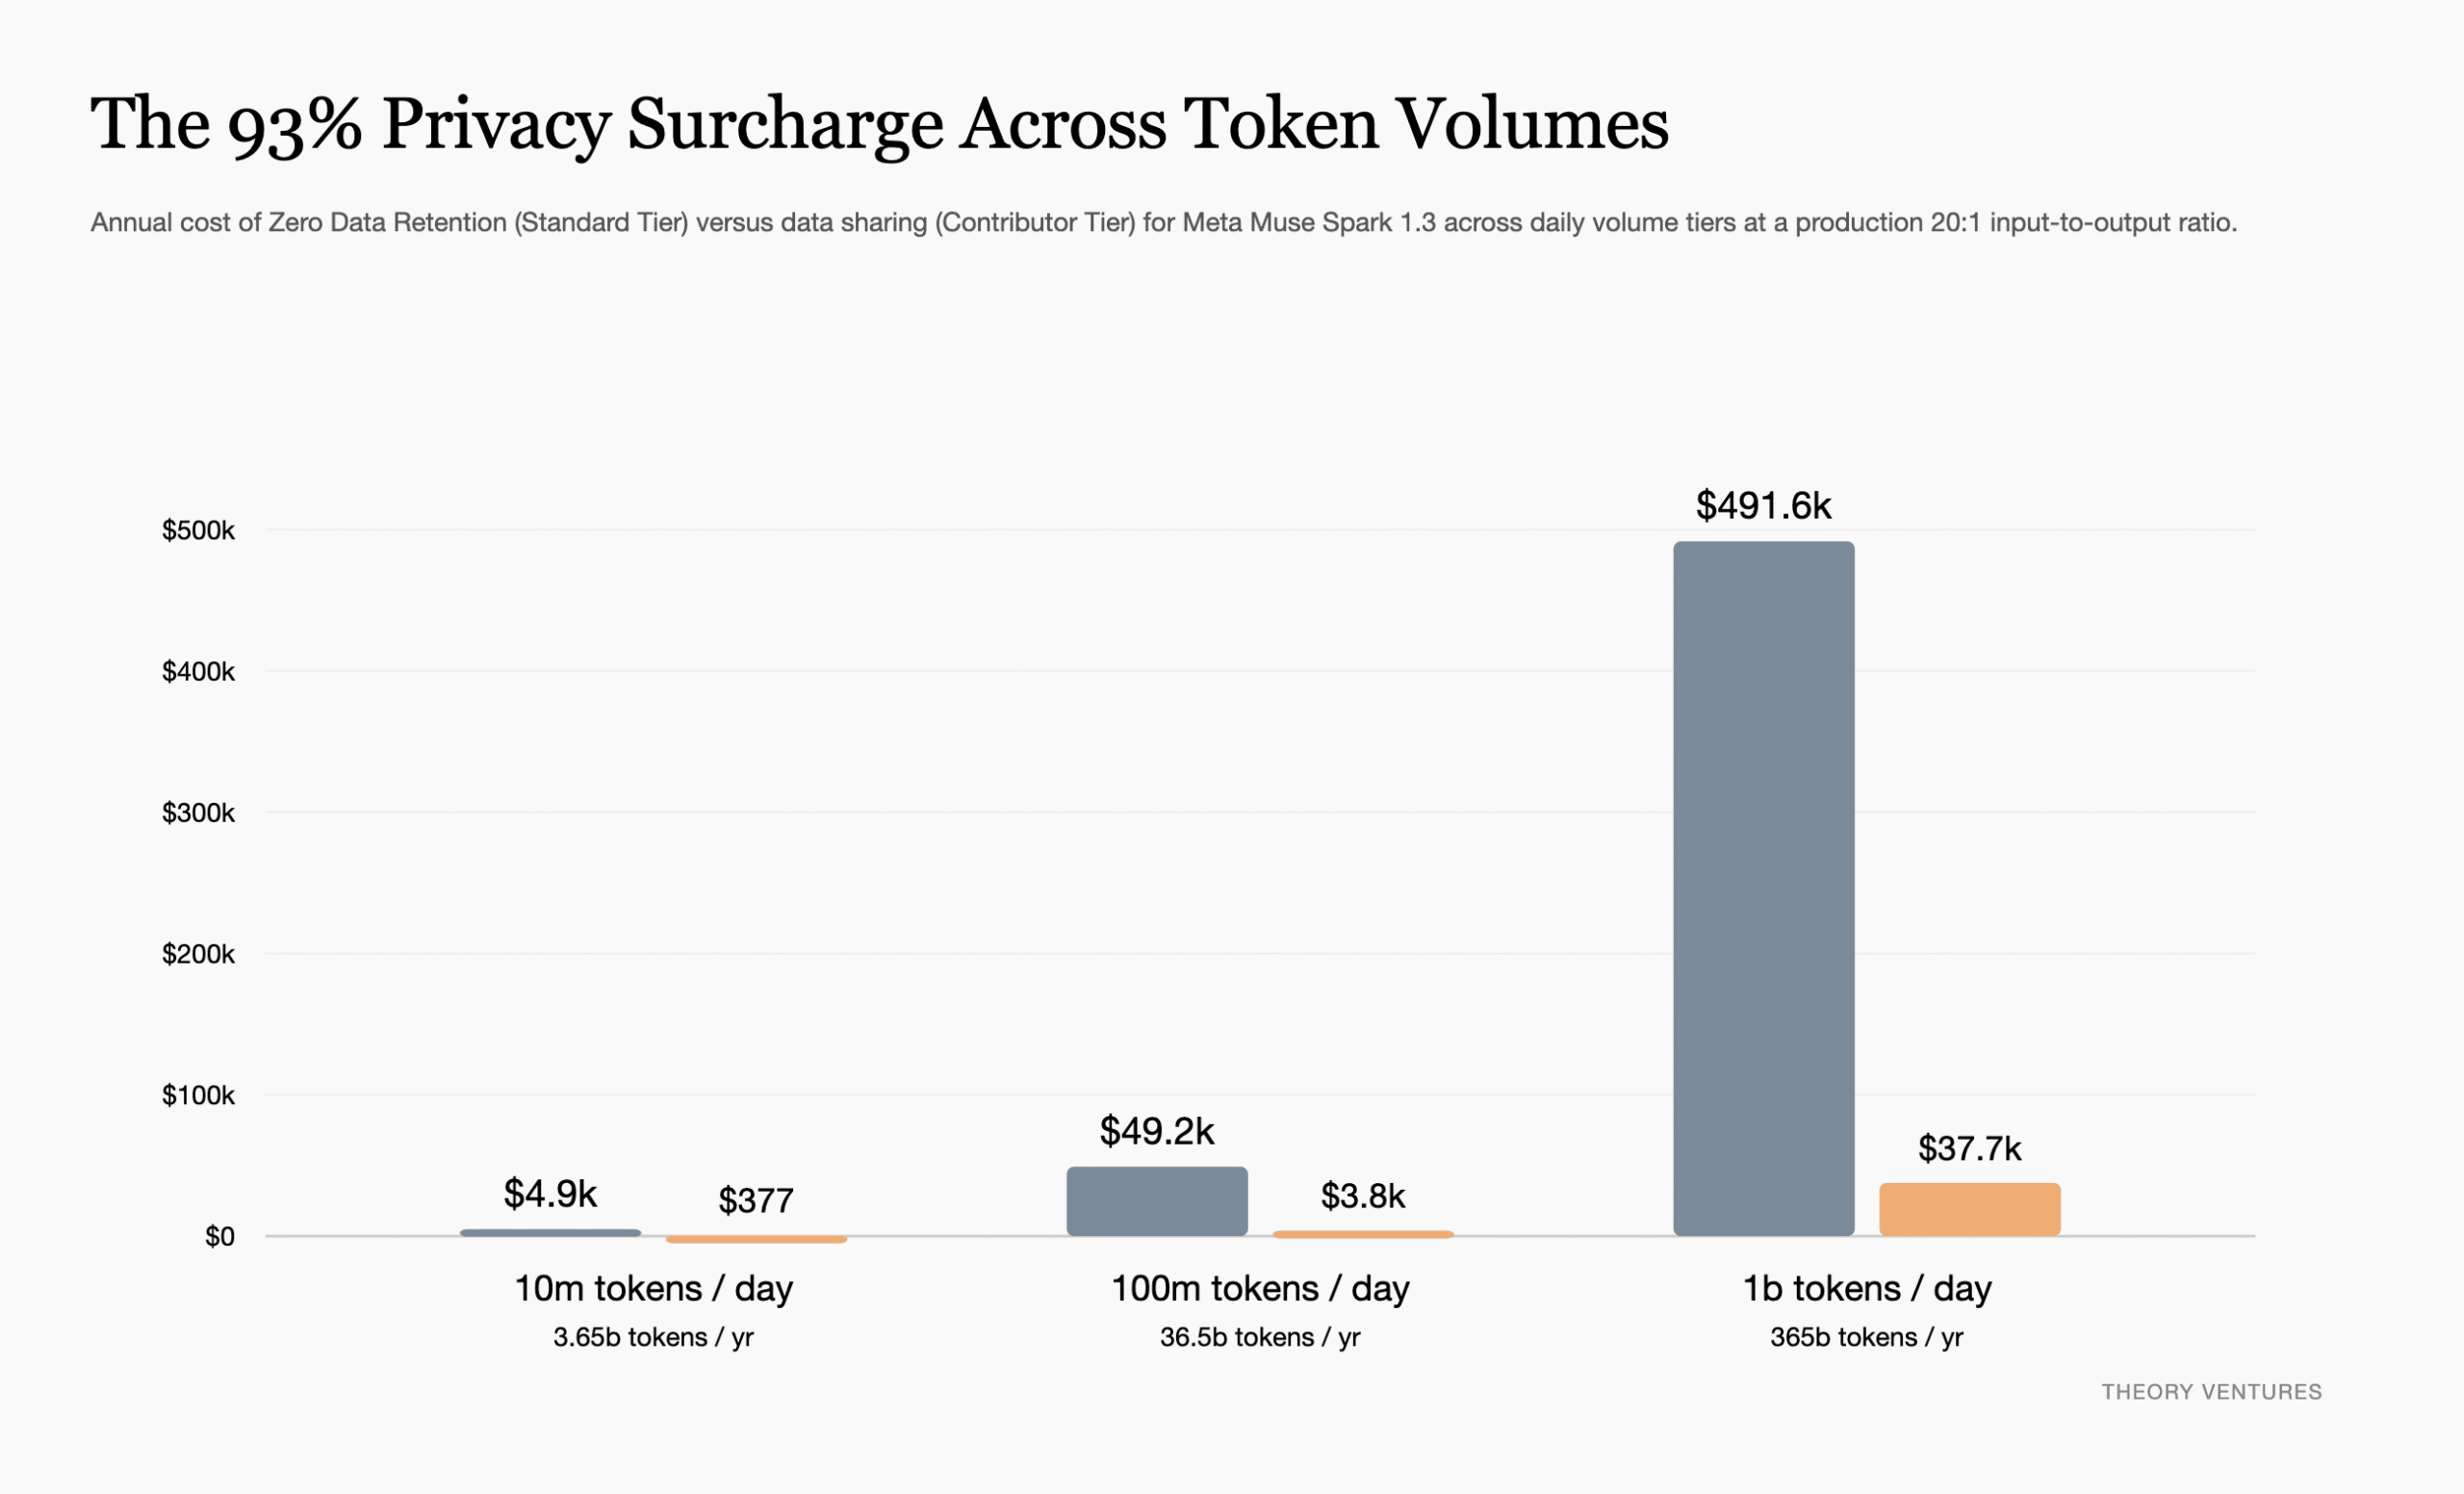
Meta 的新定价通过两级结构将这种“物物交换”明确化:标准层(muse-spark-1.3)费用为 $1.25/百万输入 token、$4.25/百万输出 token,你的提示和完成内容绝不会用于训练 Meta 的基础模型。贡献者层(muse-spark-1.3-contributor)费用为 $0.10/百万输入 token、$0.20/百万输出 token,作为交换——输入获得 92% 折扣、输出获得 95% 折扣——Meta 保留未来用你的数据训练模型的权利。目前没有其他基础模型提供商在其 API 中提供这种明确的物物交换。这就是 AI 领域的广告模式。
按照代理场景常见的 30:1 输入输出比计算,标准层的混合成本是 $1.35/百万 tokens,贡献者层是 $0.103/百万 tokens。差价 $1.24/百万 tokens 相当于 92.3% 的补贴。对于每天处理 10 亿 token 的企业,选择零数据留存(ZDR)意味着每年多付 $454,000 的隐私附加费。这个差价就是 Meta 对客户数据价值的估值:$1.24/百万 tokens。
为什么 Meta 愿意放弃 92% 的推理收入?并非出于利他。公共网络已被穷尽抓取,前沿进步现在来自后训练、基于 AI 反馈的强化学习以及用户使用模式。训练数据和人工标注市场年收入估计约 100 亿美元。Meta 的定价绕过了这一中间商。正如搜索和社交平台通过直接获取用户行为数据垂直整合了数字广告供应链,Meta 正在垂直整合 AI 数据供应链。它不再付钱给标注供应商模拟人类行为,而是将推理网络变成一个自我融资的数据飞轮。
以 $1.24/百万 tokens 的补贴率,Meta 以极低的价格获取有机推理痕迹,同时推理价格低于封闭模型。计算不再仅仅是基础设施层面的商品,它变成了直接用来交换训练 token 的货币——这些训练 token 正是构建下一代前沿模型所需的。最终,这解决了美国开源 AI 的商业模式:就像广告一样,物物交换很简单——补贴访问换取数据。