Dharma 字段抽取器:任意文档进,结构化 JSON 出
OCR 解决的是把页面文字忠实还原成文本,适合整份阅读的场景。但很多业务要的不是页面,而是特定字段:发票的每一行明细、医疗申请单上的患者姓名、检查类型和日期、证件上要存入员工记录的字段。OCR 输出里没有“哪个串是日期、哪个数字是总额”的标记,还得另写代码做映射。通用大模型配合提示词也能干这活,但在前沿 API 的价格和延迟下,高频业务场景会很快变成一种昂贵的解法。
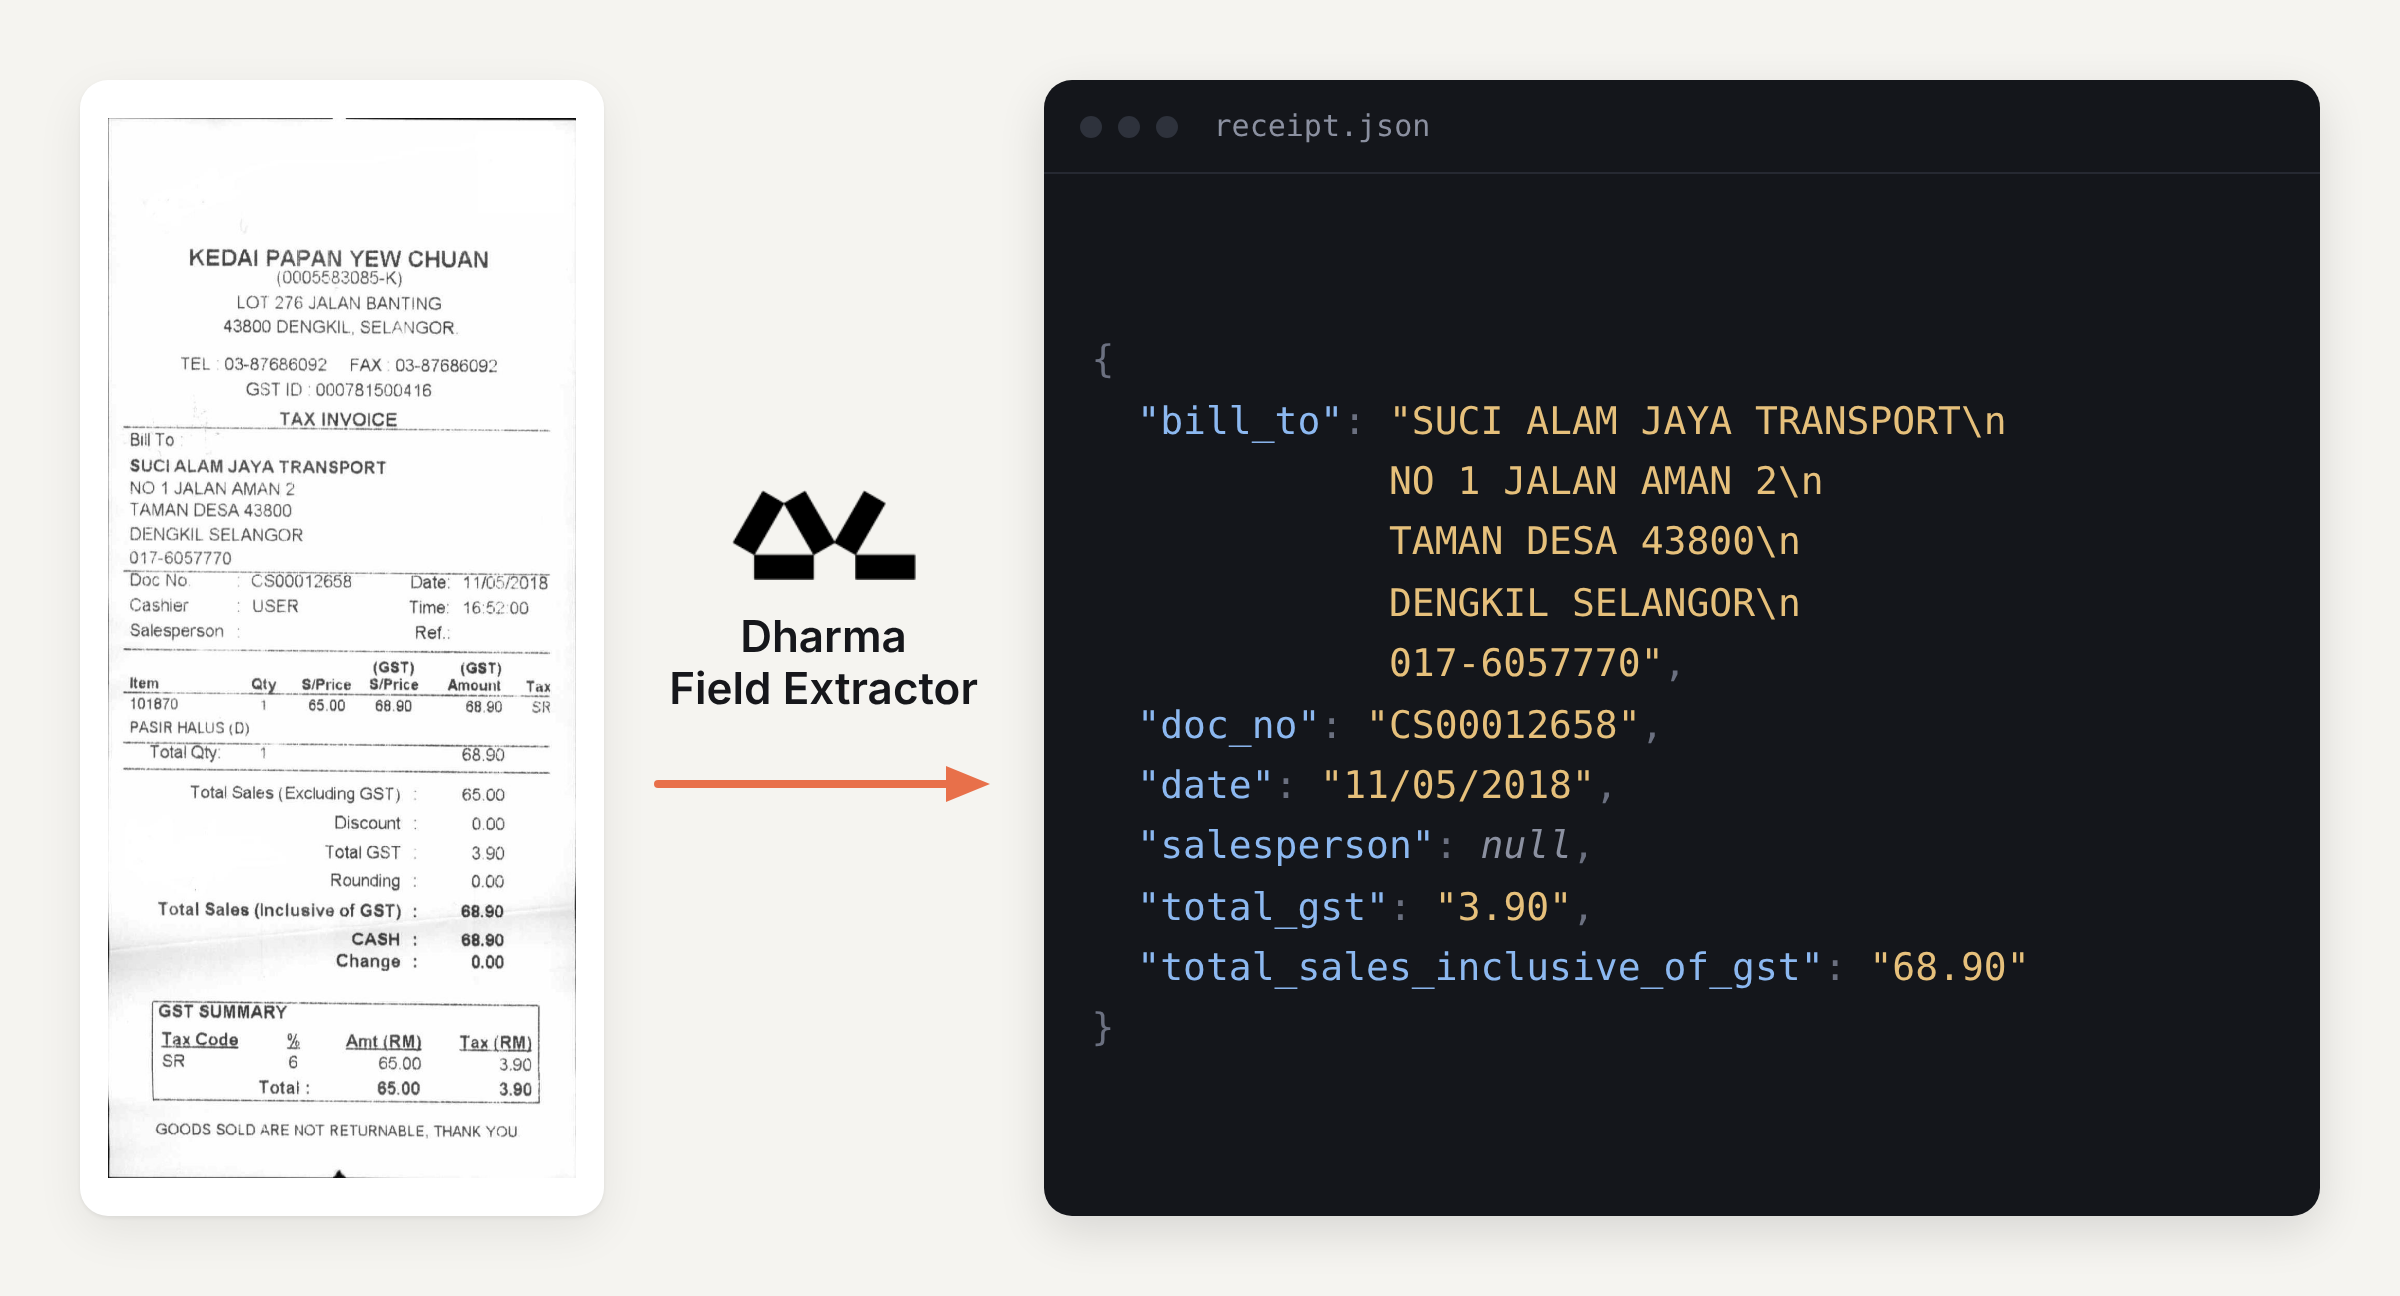
Dharma-AI 为此构建了 Field Extractor。它接收一张文档图片,加上“找出所有字段”的开放请求或一份精确 schema,输出结构化 JSON:类型化字段、逐字段对应、嵌套结构跟随原文档。同一套权重处理所有文档类型,无需按类型微调。使用分两种模式:Open 模式不提供 schema,靠版面上下文识别“标签+值”和表头结构,返回所有键值对;Schema-directed 模式由用户指定字段名和类型(string/number/boolean),输出严格使用这些键名,表格逐行逐列填充,文档中不存在的字段返回 null 而非编造。
基础模型是 DharmaOCR-LITE v1.1,一个 2B 参数的新版本,经监督微调和 DPO 专门化于 OCR;其上训练了一个 LoRA 适配器,数据规模 43,384 条,覆盖两种请求模式。数据分三股:英语多领域公开网页文档、巴西葡萄牙语真实文档、以及少量其他欧亚语种。全部做了字段级标注;领域刻意混合收据、商业发票、表单、银行流水、证件和合成文档。
基准覆盖 546 份文档 × 三种请求场景(无 schema 全字段抽取、只含真实字段的部分 schema、含故意不存在的字段的 schema),共 1,638 个用例。得分 = 字段级 F1(按路径匹配,含表格内位置)× 匹配值的 Levenshtein 相似度 × 合法 JSON 输出占比。对比四个通用前沿配置:质量差距 1.8–9.3 分(Claude Opus 5 最接近,GPT-5.6 Luna 差距最大);成本低约 6 倍到 147 倍。前沿 API 按实测每页 token 数(含 reasoning token)乘各自公开列表价计算,全部设为低推理档,Claude Opus 5 用 adaptive effort,简单页面可跳过推理;自家模型按单张 L40S、每小时 $2.24 的 GPU 时间计费,不按 token。
最终 2B 模型得分 0.834,高于全部对比对象:Claude Opus 5 为 0.816,GPT-5.6 Luna 为 0.741。SROIE 和 FUNSD 两个公开数据集未参与训练,作为泛化测试:SROIE 小票上 18 个字段全部正确,多行无标签的账单地址作为一个字段捕获,两个空白字段返回 null,金额精确到分;FUNSD 表格上 12 个布尔字段(含一组 5 个嵌套子选项),只把实际勾选的一项标为 true,其余 11 项为 false,还正确读出了手写的 Bates ID,两个留空字段返回 null。
这不是孤例。此前的 OCR 论文(arXiv:2604.14314)中,3B 参数的 DharmaOCR-LITE 在巴西葡萄牙语上超过所有商业前沿 API;三个月后更新的模型出现,差距依旧。作者的核心论点是:在边界明确的任务上,紧贴任务训练的小模型胜过被要求用通用能力做同一件事的前沿模型——参数规模设定上限,训练决定模型兑现多少。他们也指出,自托管成本取决于硬件、业务量和延迟需求,该对比不是销售报价,而是展示“在自有基础设施上部署自主专精小模型(SSLM),是前沿 API 的现实替代方案”。