Palette:让20B小模型按你的设计语言做幻灯片
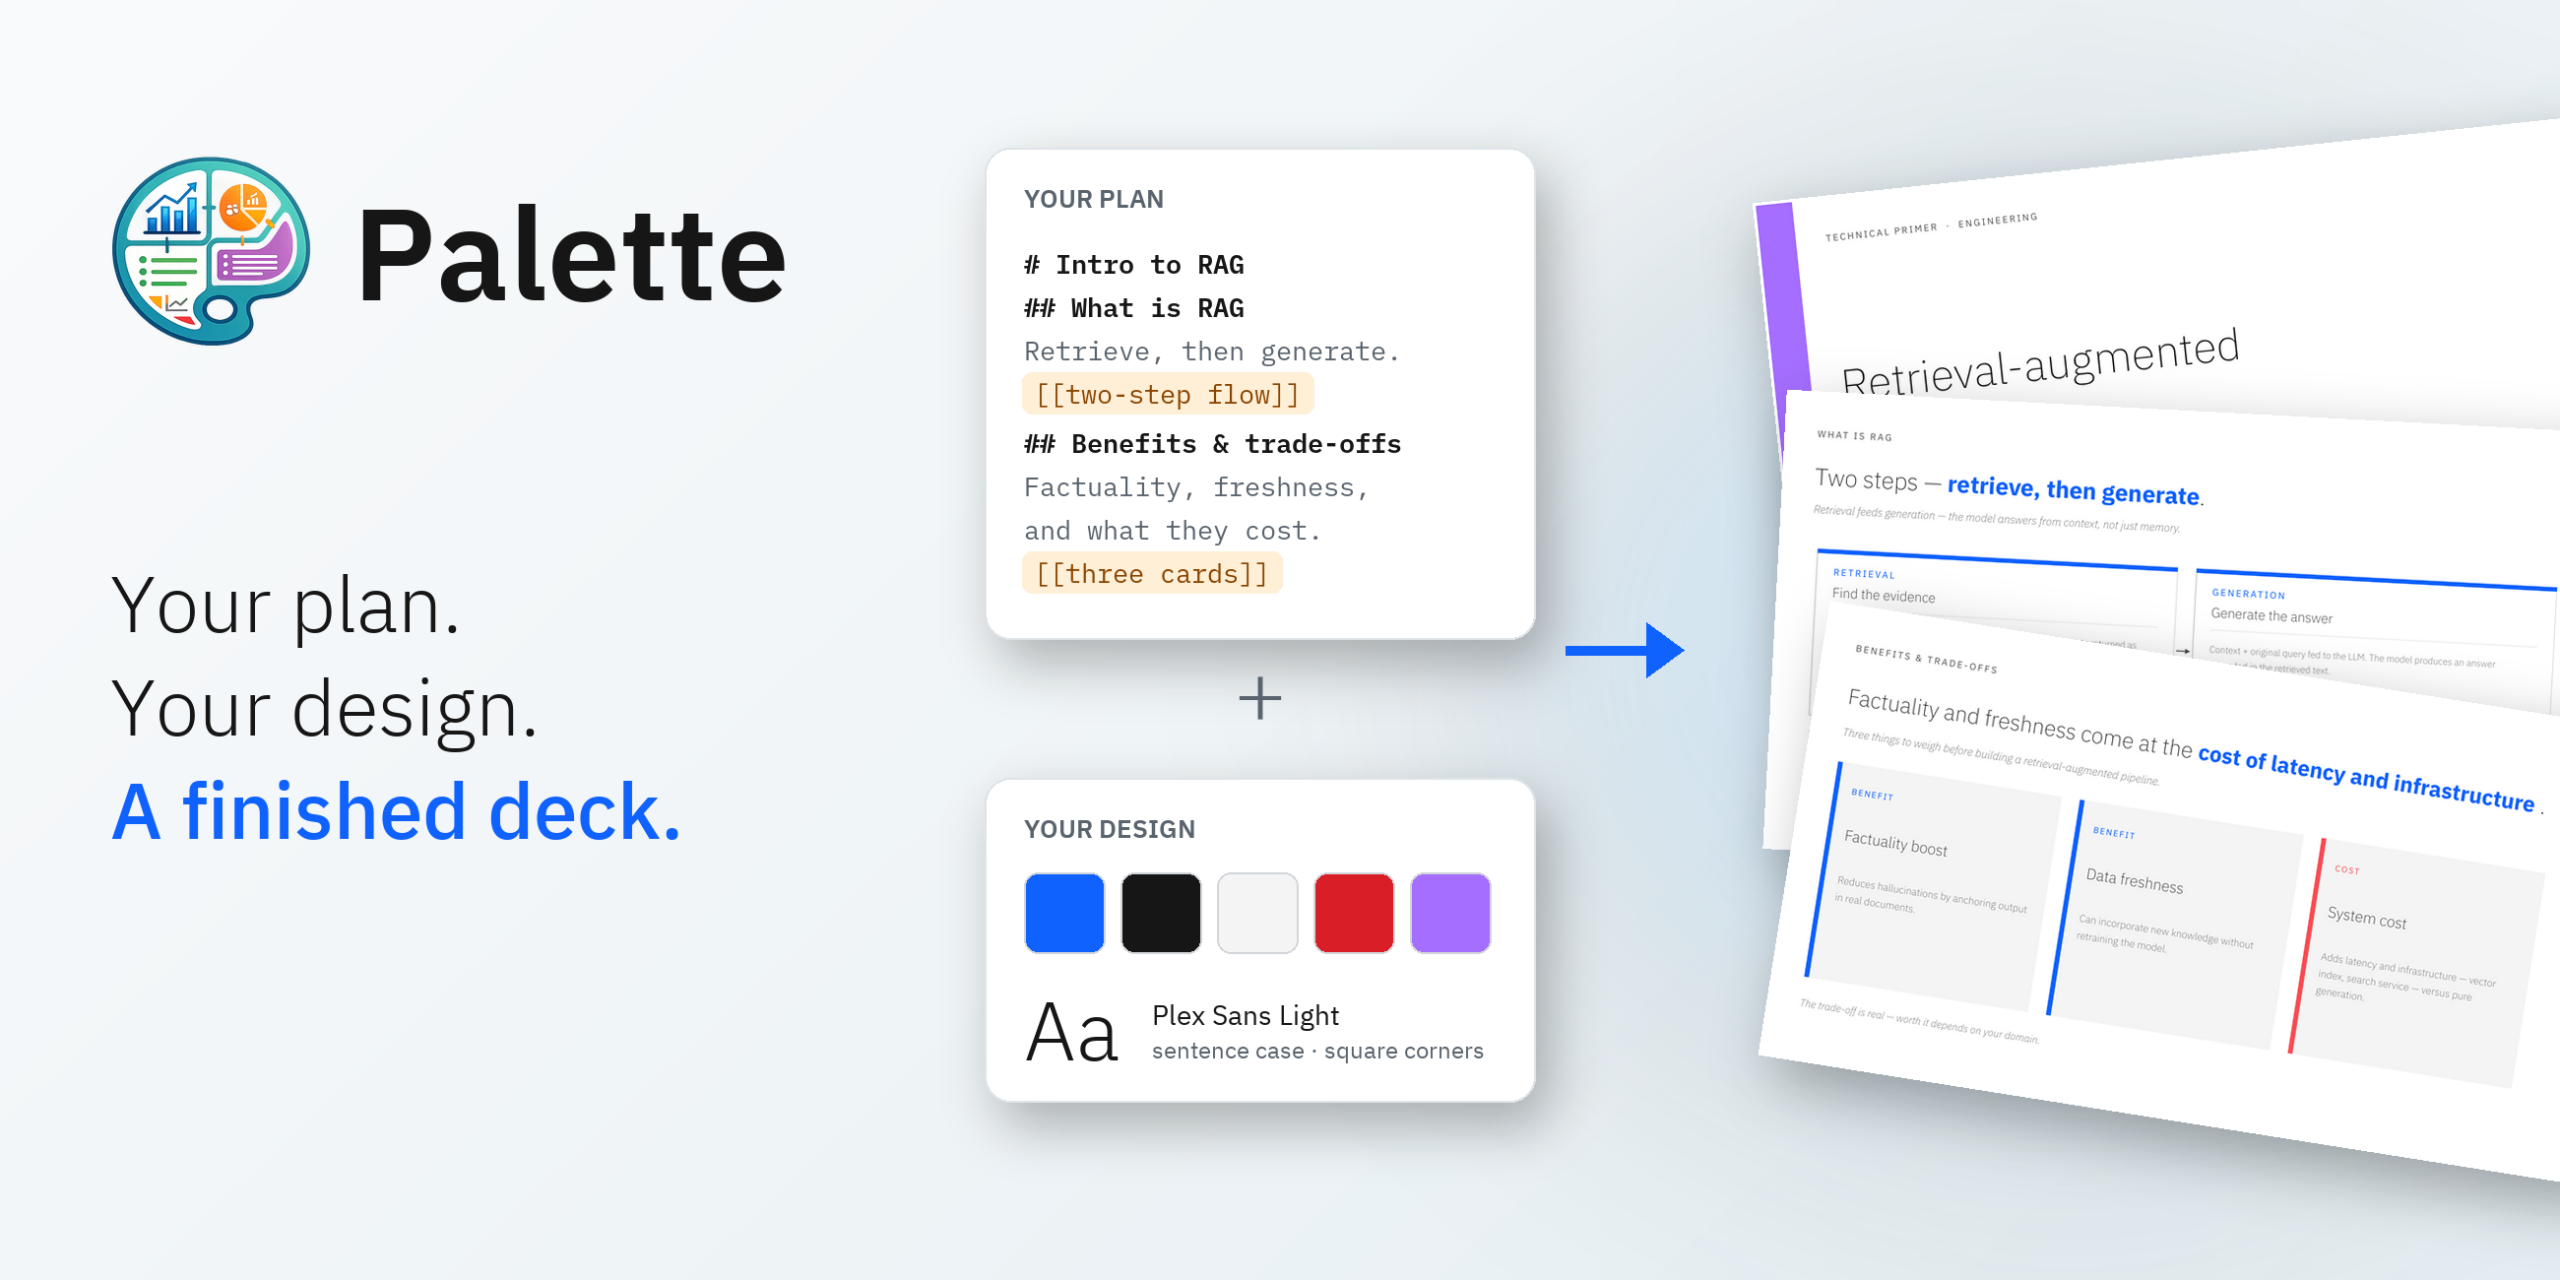
前沿模型能生成像样的幻灯片,但连续生成多套后会趋同,自带某种“AI生成”的审美。如果你要求它匹配你的模板,它总会被拽回自己的默认风格;当内容涉密时,又完全不能把数据送出系统。Palette 的应对是:用你自己设计语言的合成数据,微调一个 20B 的开源权重模型,并在外面套一层检查-修复装置,最终模型归你、结果也归你。
为什么小模型做不好幻灯片?一张幻灯片看起来简单,但模型要在看不见渲染结果的情况下做三件事:写代码把每个元素放在 x、y、宽、字号上,75 个字符的标题在 56pt 下是否折成两行,全靠心算;它同时要做编辑判断和几何定位;而且没有现成数据能说明“一张好片子是怎么做出来的”。
Palette 把任务拆成设计师和程序员两个角色,由同一个 LoRA 适配器承担。设计师读取计划,输出结构化 JSON brief,包含调色板、字体系统、每页布局、确切内容和简短设计理由;程序员拿到单页 spec,写出生成这张幻灯片的 pptxgenjs JavaScript。每个角色的决策单一化:设计师管内容取舍,程序员管几何。brief 可读可改,人和 agent 都能单独调整某一页;因为每页上下文在写代码前就固定,所有 coder 调用可以并行,编码阶段约快 6-7 倍。用 LoRA 而不是全参数微调,是因为它只教格式和技能,不动基座能力,而且实验成本低。训练数据里一个教训:coder 示例比 designer 示例长约 5 倍,朴素混合会导致设计师欠训练,需要把它的示例过采样 5 倍。
没有公开的“计划+设计决策+代码”语料,Palette 用大型开放教师模型合成。每套 deck 从 recipe 开始,控制体裁、长度、布局和用户指令;计划范围从整齐大纲到原始内容倾倒,模型学着删减和压缩。共生成约 1000 套 deck、约 10000 张幻灯片。每个示例还带反事实推理:权衡替代方案并说明为什么被拒绝,让模型学选择背后的规则。比如设计师会说“我考虑用表格,但这页的重点是趋势而不是精确数字,所以用柱状图”;程序员会写“标题 62 个字符,44pt 会折成三行撞到下面的图表,所以设成 36pt”。教师模型本身不够,外围的检查循环才让数据变好:每张合成幻灯片都被渲染和检查,重叠、溢出会被修复,修复理由也写成同样的反事实,被检查器抓到的错误变成更好的训练样本。
最难的是忠实性:最糟的失败是幻灯片出现输入里没有的事实,光靠 prompt 规则挡不住。真正有效的是 reference decks:教师模型会大量模仿样例,而不是服从指令,所以修好参考样例比加规则更能改变输出。Palette 还支持用 [[ ]] 写在计划里的指令,比如 [[make this a timeline]],12 个类别的指令用多种措辞训练,让模型学意图而非固定短语。
训练好的模型仍可能出错。Palette 不直接返回模型输出,全部先过 harness:简单规则先修已知错误(如坏颜色代码),再把每页渲染并测几何,发现文本重叠、裁剪出界就交给单独的 editor 模型重写。关键规则是:只有检查器确认改好了才保留重写,否则用原样,所以 harness 只能修好、不能改坏。跨 131 套 PresentBench deck 测试,harness 平均加 3.5 分。
评估用 PresentBench,按 fundamentals、visual design、completeness、correctness、fidelity 打分。Palette 在经济和教育的两个 domain 上排第一,Talk 排第三,三个 domain 平均排第二,59.7 比 NotebookLM 的 60.8 差 1.1 分,但超过其余系统,而且是单个 20B 开放权重模型。作者指出 PresentBench 不测设计语言遵循度,这仍是个空白。下一步:用 harness 的检查信号做强化学习奖励(GRPO 风格),让模型一开始就不犯错;用 Docling 抽文档里的图并放进 deck;以及尝试从一两份现有 .pptx 重换皮肤,不用重新训练。
他们总结的通用方法:把推理写进数据;修参考样例而不是加规则;修复要默认安全,能证明变好才保留;先建检查器,它让数据可信、输出可发送。