Trajectory 获 4500 万美元,让非技术专家也能训练 AI 模型
当前 AI 模型有一个共同局限:无论来自 OpenAI、Anthropic,还是基于开源构建,它们都不会从错误中学习,需要进一步训练。企业想把这些模型用于法律、金融等专业领域,通常得对通用模型做微调,而这往往意味着要养内部研究团队,或者依赖昂贵的顾问(forward-deployed engineers)。
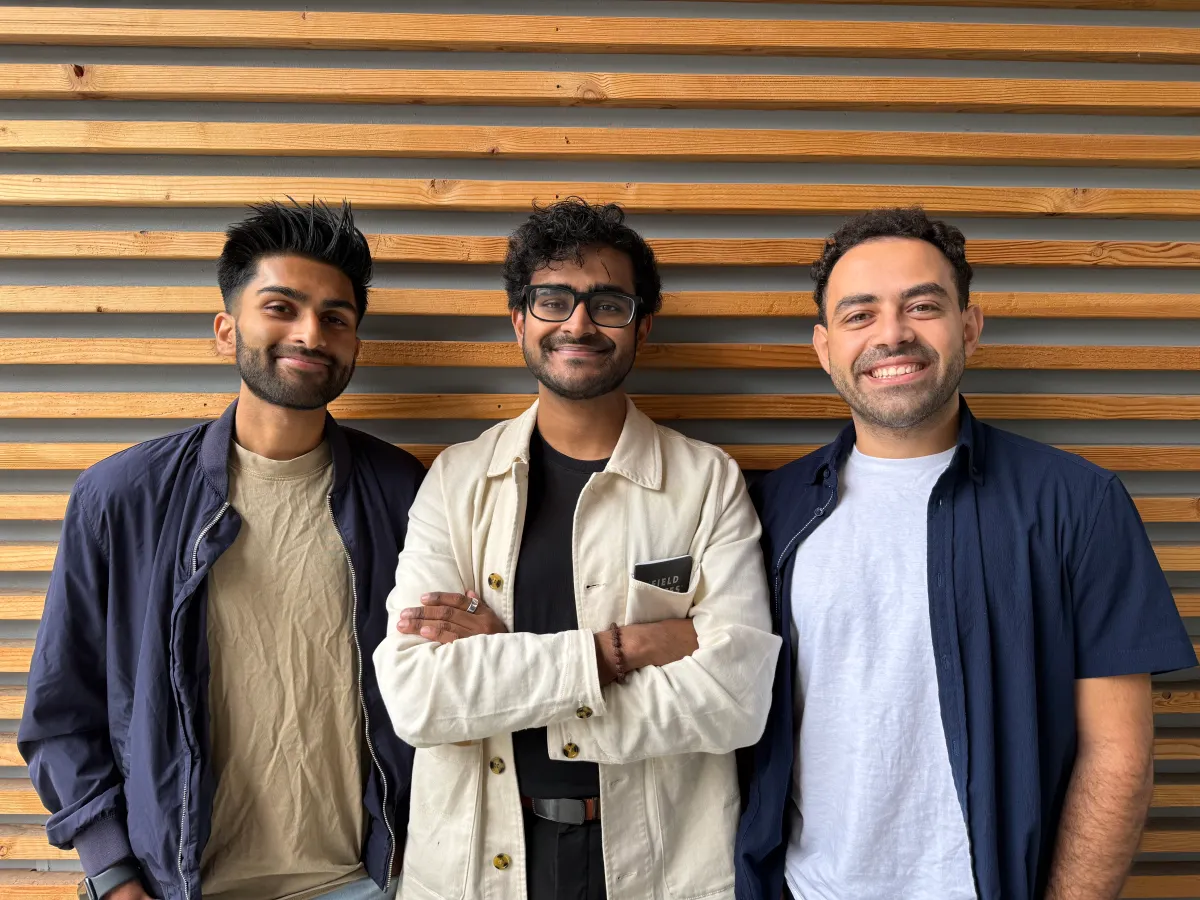
Trajectory 这家成立约一年的初创公司想把这个过程自动化。三位创始人是斯坦福同学,曾在 Google DeepMind 和 Apple 工作。他们刚宣布完成 4500万美元 A 轮融资,估值 3亿美元,由 Sequoia 领投,Nvidia、Bessemer Venture Partners、Bain Capital Ventures 参投,团队现有 18 人。
方法叫 持续学习(continual learning)。企业用 Trajectory 时,可以从开源模型开始,把平台接到自己的应用上,系统会收集模型在实际任务中的表现反馈。Trajectory 再拿这些信息重训模型,让它在专业任务上逐步变好。联合创始人 Ronak Malde 把基础模型比作一个很聪明的博士生,但经济更看重的是同一份工作干了 30 年的人。
这套思路的卖点是让律师、医生这类专业人士近乎自动地改进模型,不需要研究团队介入。Harvey 和 Rogo 已在用 Trajectory 平台对开源模型做后训练,让模型表现更像资深律师或金融分析师,比如学会审阅特定类型的法律合同,或者用特定方法给公司估值。其他客户还包括 Decagon、Mercor 和 Nvidia。平台现已公开可用。
Trajectory 的方法和递归自我改进(RSI)有相似之处,但联合创始人 Michael Elabd 认为,让人类留在训练回路里更安全,因为完全自主的自我改进可能带来意外甚至危险的后果。它的直接竞争对手包括 Thinking Machines Lab——Mira Murati 创办、拥有微调平台 Tinker——以及上月估值 32.5亿美元 的 Applied Compute,还有帮企业构建和训练自有 AI Agent 的 Prime Intellect。
Malde 认为公司最大的优势是团队。他本人是 Google DeepMind 从 Windsurf 收购式招聘的少数研究者之一;Elabd 也曾在 DeepMind 工作;第三位联合创始人 Arjun Karanam 之前在 Apple 做生成式基础模型。团队还补充了来自 OpenAI、Stripe、Netflix 的研究者和产品设计师。Karanam 说,他们专门开发了一套界面,让非技术客户更容易完成后训练。