NVIDIA发布Cosmos 3开放模型,用于交互式世界模拟
NVIDIA 在 Cosmos 世界模型开发平台上新增了四个开放权重检查点,统一归入 Cosmos 3 模型家族,目标是为交互式世界模拟和多传感器多视角驾驶场景提供生成能力。这四个模型都是 Cosmos 3 Nano 的后训练实例,可训练参数均为16B,并采用 OpenMDW1.1 许可,允许商业和非商业使用。官方同时提供了检查点下载、技术报告和演示视频。
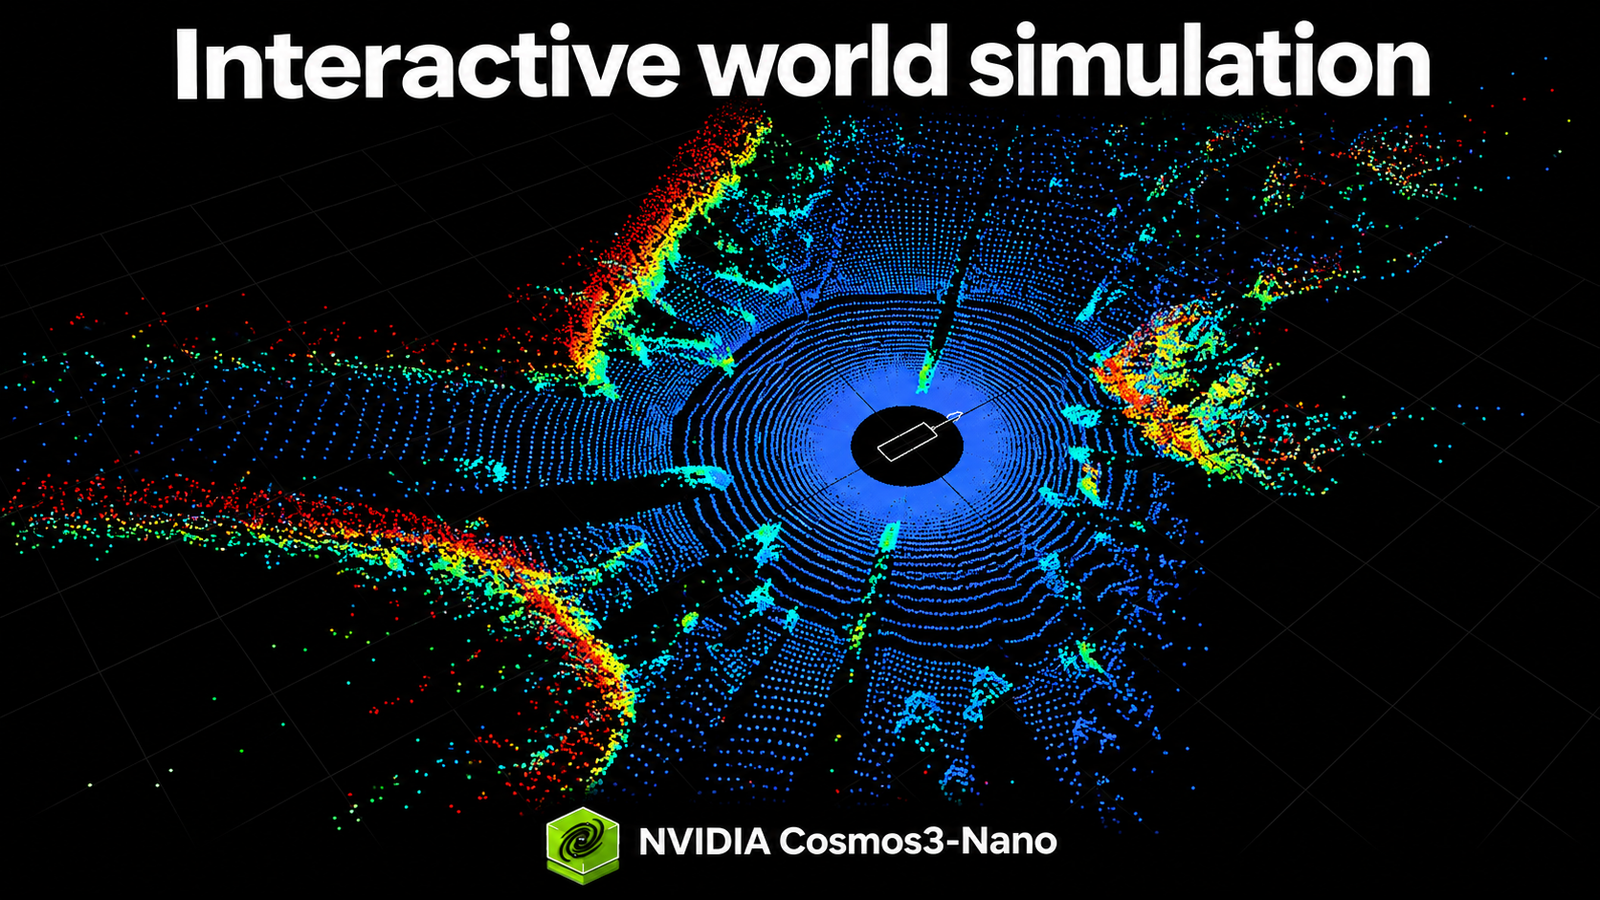
四个模型各有分工。Cosmos3-Nano-Transfer-Auto 面向离线合成驾驶数据,是双向模型,能生成最多 11 个相机视角的同步视频(含鱼眼),还支持 RGB-LiDAR 联合生成;每相机的 World Scenario Map 控制场景结构和交通运动,文本提示控制外观,可选初始 RGB 图像锚定场景。Cosmos3-Nano-Sim-Auto 是 Transfer-Auto 的因果蒸馏流式版本,用少量去噪步骤生成连续小块同步相机视频和 LiDAR,利用生成历史和更新的驾驶控制实现快速流式与长交互 rollout。Cosmos3-Nano-Sim-Transfer 把物理模拟器算出的空间控制转成策略可消费的 RGB 观测,深度、分割、边缘、模糊等控制信号决定几何线索,文本决定外观。Cosmos3-Nano-Sim-Bimanual 则直接根据场景和机器人动作预测下一段视频,支持 YAM 和 AgiBot 两种双臂形态,可由策略或操纵杆控制。
对自动驾驶来说,外观与几何必须一致。同步生成相机和 LiDAR 正好把视觉观测与 3D 传感对齐;场景和交通信号控制让研究者改变道路布局和信号状态,然后观察驾驶策略如何反应。对机器人来说,Sim-Bimanual 解决“动作会产生什么视觉后果”,Sim-Transfer 解决“把模拟器状态变成看起来真实的画面”。流式生成则让每个观测都能影响下一个动作,为世界模型研究提供探索“动作与观测如何共同展开”的途径。
在机制上,Cosmos 3 使用 Mixture-of-Transformers 主干,把文本处理和视觉生成网络通过注意力连接。生成器根据提示、可用控制和生成历史预测每个短段;时序因果注意力阻止未来目标观测被读取,KV cache 保留注意力信息供下一步使用。模型操作在压缩视频潜变量上:初始图像之后,每个潜时间步代表四帧 RGB。Transfer 每块预测一步,报告中优化的 Bimanual 每块预测两步;更小的块能让新控制更频繁地影响生成。
训练采用四阶段配方。Stage 0 是双向适应,从完整片段学习领域和控制-视频关系;Stage 1 是 teacher forcing,用先前观测和可用控制预测当前块,并掩蔽干净答案和未来目标;Stage 2 是一致性蒸馏,用冻结教师训练学生在四步去噪内生成每块;Stage 3 是 self-forcing,在学生的生成历史基础上继续训练,由冻结教师和辅助评分模型提供分布匹配信号。最后一步之所以关键,是因为一个稍微预测错的对象会成为后续帧的上下文,误差可能累积;self-forcing 让训练暴露在这种生成历史中。蒸馏和缓存进一步降低了每个观测的生成成本。
官方还给出了适配自己的数据的路线。Transfer-Auto 可先在你的数据上后训练,适配相机布局、LiDAR 配置和目标环境,再做因果训练和少步蒸馏得到 Sim-Auto。Sim-Transfer 和 Sim-Bimanual 也各有后训练配置、数据校验和检查点交接流程。运行环境要求 Linux、NVIDIA GPU、Docker 和 NVIDIA Container Toolkit;官方 vLLM-Omni 套件在单张 GB200 上测试过,但这并非最低内存规格。文章也坦承,这些模型对策略学习和评估的支撑程度仍需衡量,局限有待进一步明确。