Google 与 Oracle 合作,将 Google TPU 引入 Oracle 云基础设施
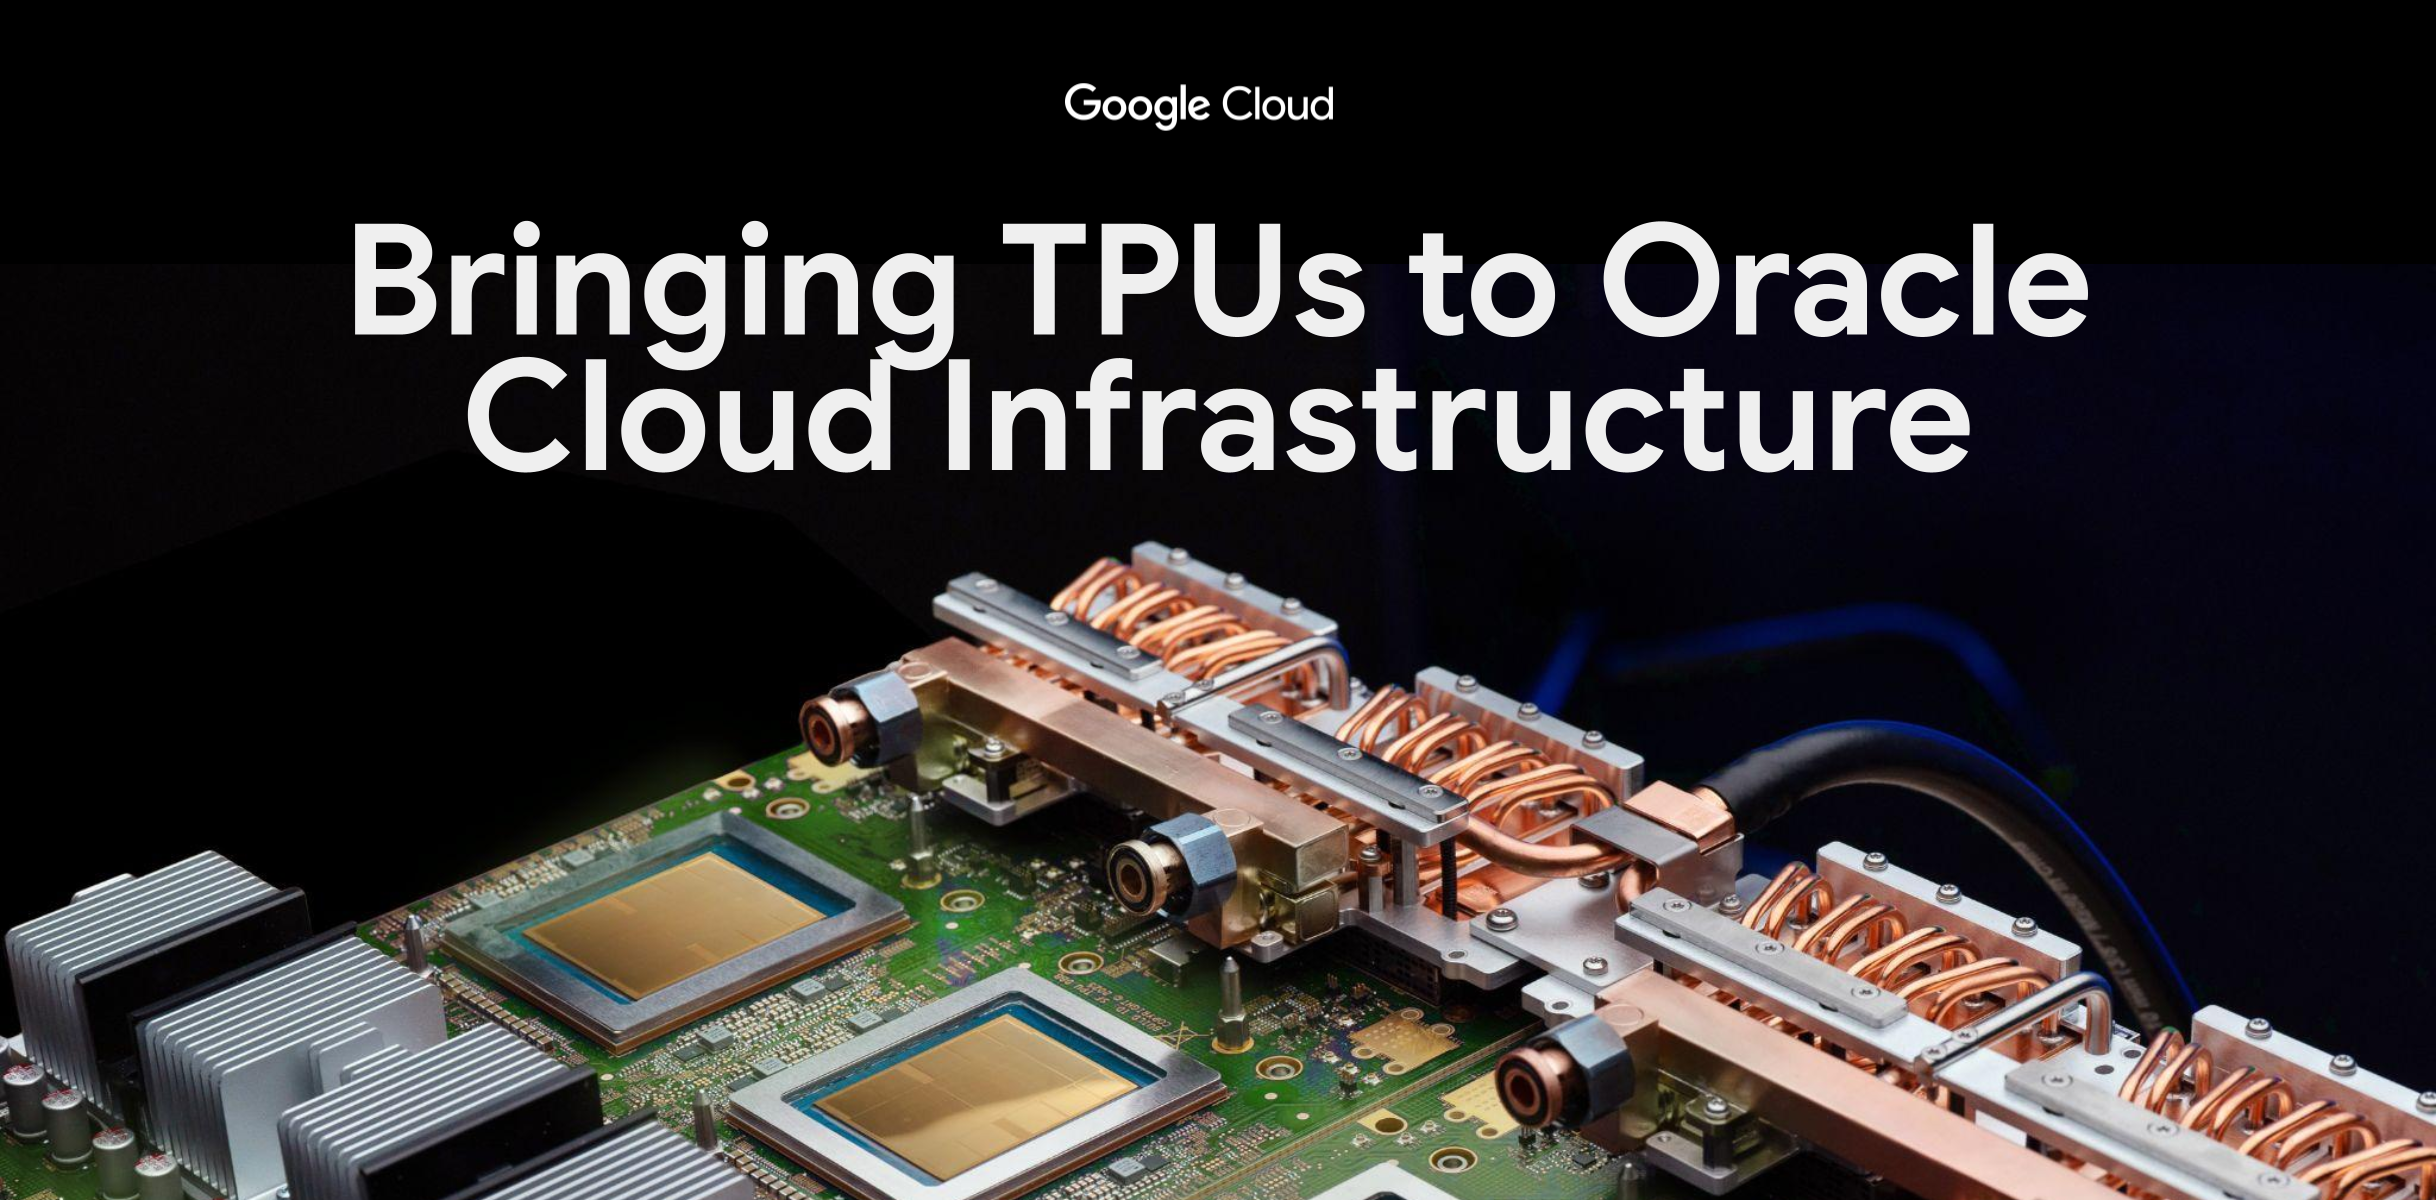
Google Cloud 与 Oracle 宣布达成合作,将 Google Tensor Processing Units(TPU)引入 Oracle Cloud Infrastructure(OCI)。OCI 因此成为 Google 之外第一家提供 TPU 的超大规模云。双方计划于 2027 年在 OCI 上部署 TPU 容量。
TPU 是 Google 自研超过十年的定制加速器,核心理念是从硅片到软件做系统级协同设计:把自研芯片与光网络、供电、液冷、编译器放在一起优化,以获得单看组件无法实现的每瓦性能和总拥有成本优势。第一代 TPU 的每瓦吞吐量是同期处理器的 30 倍。到第八代,单芯片可提供最高 12.6 PFLOPS 的原生 FP4 算力,超过 TPU v1 的 92 TFLOPS 一百倍以上,每瓦性能也比上一代最高提升 2 倍。
Google 强调,原始算力并不能直接决定客户在训练和推理上的实际成本。训练场景的关键指标是 goodput,即集群真正用于有效计算的时间占比;推理场景的关键指标则是延迟和每 token 成本。TPU 通过系统级设计来同时改善这两类指标:片上互连(ICI)结合光路交换(OCS),让控制面可以在运行中检测硬件或链路劣化,并实时把光路绕过故障点,无需重启任务。在大规模训练中,数千芯片上的 goodput 可维持在 97% 以上。最新一代 TPU 还增加了片上 SRAM 和 HBM 容量,并采用新的低直径互连拓扑,网络跳数减少超过 50%,低延迟推理场景的每美元性能最高提升 80%。
软件生态方面,Google 宣布 TorchTPU(TPU 原生的 PyTorch 栈)已在 GitHub 开源。开发者可以继续使用 vLLM、SGLang、llm-d、TorchTitan、Ray、TorchRec、Hugging Face、LiteRT 等工具在 TPU 上训练、服务和部署模型。这种可移植性让团队不必重写模型代码,就能把每个工作负载分配到成本或速度最优的加速器。随着本次合作落地,这些工作负载未来既可以选择 Google Cloud,也可以选择 Oracle 基础设施。
TPU 进入 OCI 对客户有四个直接价值。第一,OCI 的下一代数据中心按 AI 密度设计,支持机架级直接液冷,与 TPU 系统的散热需求匹配,能快速规模化上线高能效 AI 算力。第二,Oracle Acceleron 提供高性能网络基础:SmartNIC 具备硬件级租户隔离、High Performance Fabric 和 Zero Trust Packet Routing,可在 Oracle 数据库、存储与 TPU 集群之间传输数据,吞吐高、延迟低,且不消耗主机计算资源、不削弱安全边界。第三,TPU 直接放在 OCI 内,企业可以在现有 Oracle 数据库等系统记录旁边做微调和推理,避免昂贵的跨云数据传输。第四,OCI 同时提供 TPU 和 GPU,团队可以按 AI 工作负载的不同阶段选择最优加速器。
这次合作把 Google 十余年的定制 AI 系统工程能力向更广泛的生态开放。对行业而言,这意味着目的明确的 AI 算力不再只存在于 Google 一家云上,客户在构建和运营 AI 时有了更多选择空间。