FDE 在 OpenAI 意味着什么
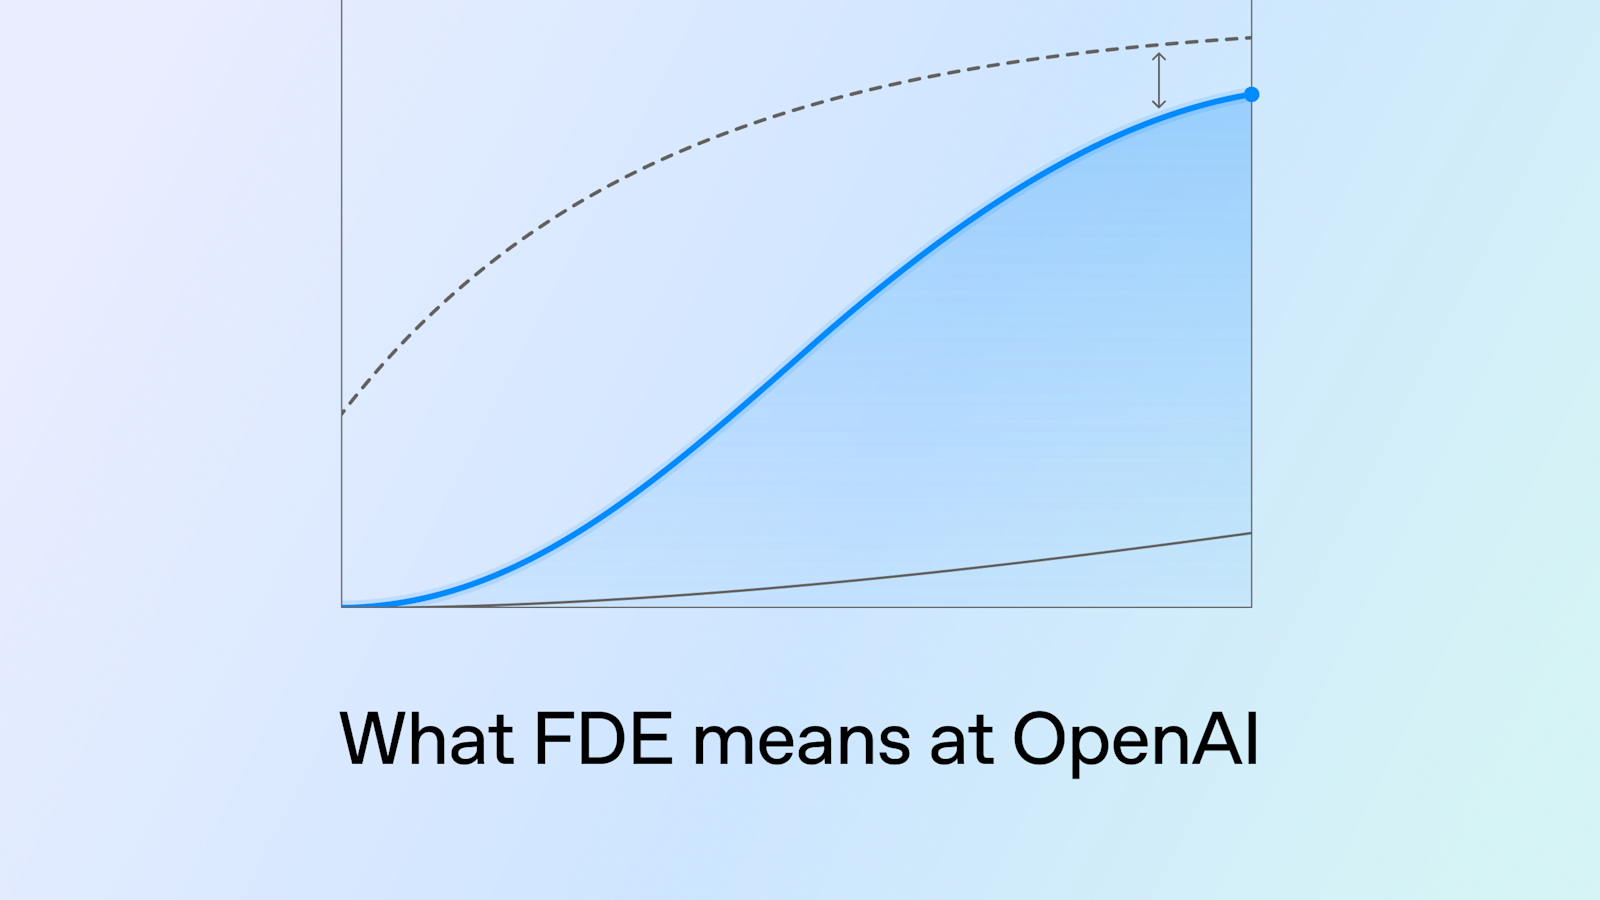
这篇文章讲的是 OpenAI 的 FDE 团队如何定义自己的价值。作者 2025 年初创建这个团队,目标是填补“部署差距”:模型看起来能做的事,和人们实际上能稳定用于工作之间,隔着一大段距离。模型能力跑得比配套系统和流程快,有时缺的是产品,有时模型在基准测试上表现不错,但面对真实变量和约束就做不了。
文章开头有个问题:Codex 出现后,如果它一次就能完成团队花几个月做的用例,怎么办?答案是去找更难的问题。如果 FDE 每隔几个月就被自己做的事淘汰,说明团队干对了。他们的工作方式不是做演示。先以结果出发,做必要的事,然后再规模化。
具体案例能看出这套方法。John Deere 是 200 年历史的农业企业,难点是把农业个性化建议规模化。See & Spray 用摄像头和机器学习识别杂草并定点喷洒,最高可减少 70% 的化学药剂用量,但前提是农民会配置、会规划季节、会随条件调整。OpenAI 的 API 被用来提供自然语言问答、配置指引、设备效率提示和价值解释。
半导体案例更硬核。2025 年年中,约 15 个 FDE 和一个大型半导体客户一起做 10+ 用例,目标是让验证流程 AI 原生化,覆盖定向测试生成、根因分析和调试、架构助手。验证在这个行业通常占项目约 70% 的努力。不少 FDE 入职才几天、从没碰过半导体,他们嵌入客户验证团队,业余时间学芯片设计,和工程师一起构建 evals。前 3-6 个月,这些用例全部进入生产。关键结果:AI 定向测试生成节省约 48% 时间,内核优化带来 22% 的中位性能提升,数周调试被压成几小时。团队混合通才和领域专家;在生命科学,有科学背景的 FDE 能和研究人员建立信任,参与靶点验证、基因表达分析、化学合成路径重建等工作。
接下来是让成功可复制。最初每个工作流都依赖太多定制集成,后来 Codex 能力变强,一个 FDE 用它重建应用,把用例迁移到以 Codex 为核心的公共底座上。定制应用变成插件和技能,单独的终端 UI 和 CLI 不再需要。每个项目大约 90% 的定制代码被移除。好处是能享受 Codex 的集中改进,技能和插件可共享并集中管理。扩展到新团队时,只需换新的 connectors/MCP servers、重建 evals。文中提到 2026 年 8 月的一次部署:第一个团队用了两个月,扩展到第二个团队只用一天。
同样原则也塑造了产品。OpenAI Presence 这个面向企业语音和聊天 Agent 的产品,就是从真实客户部署中生长出来的,源头是 Swarm,经过 Agents API 演进,现在一个客户超过一半电话由 AI 处理。在 Thrive Holdings 的案例中,FDE 和研究人员与工程师、会计师一起为克里特岛的会计师事务所做 Tax AI。试点期间处理了 7,000 份纳税申报,吞吐量提升约 50%。最难的是自动处理租赁房产申报,花了六周工程和从业者审阅,才达到 90% 的精确率和召回率。这些经验被用来扩展到记账、审计和 IT 支持。
模型能力不足时,工作变成和 Research 一起补缺口。一个大型电信客户想从客服平台扩展到语音。语音占他们客服量约 90%,成本比聊天高,难点包括口音、语气、延迟和准确率。评估初期模型只有约 60%,客服场景的函数调用和指令遵循达不到要求。FDE 和客户搭建平台并定义需求,Research 逐个能力缺口攻关。六个月里,关键 eval 从 60% 到 80%,再到 90% 以上,达到生产标准。这个语音模型随后既服务该客户,也进入其他自定义部署和 Presence 托管部署。
文章最后回到团队哲学。在 LLM 开发里,奥卡姆剃刀通常适用:最简单方案往往最好。这个行业充满夸大其词,FDE 要构建在真实场景中可靠工作的系统。每段客户工作都应该让下一个客户起点更高:产品更容易部署、模型能处理更难任务、定制代码更少。当模型已经能解决上一轮问题时,FDE 要做的是去找更难的问题。