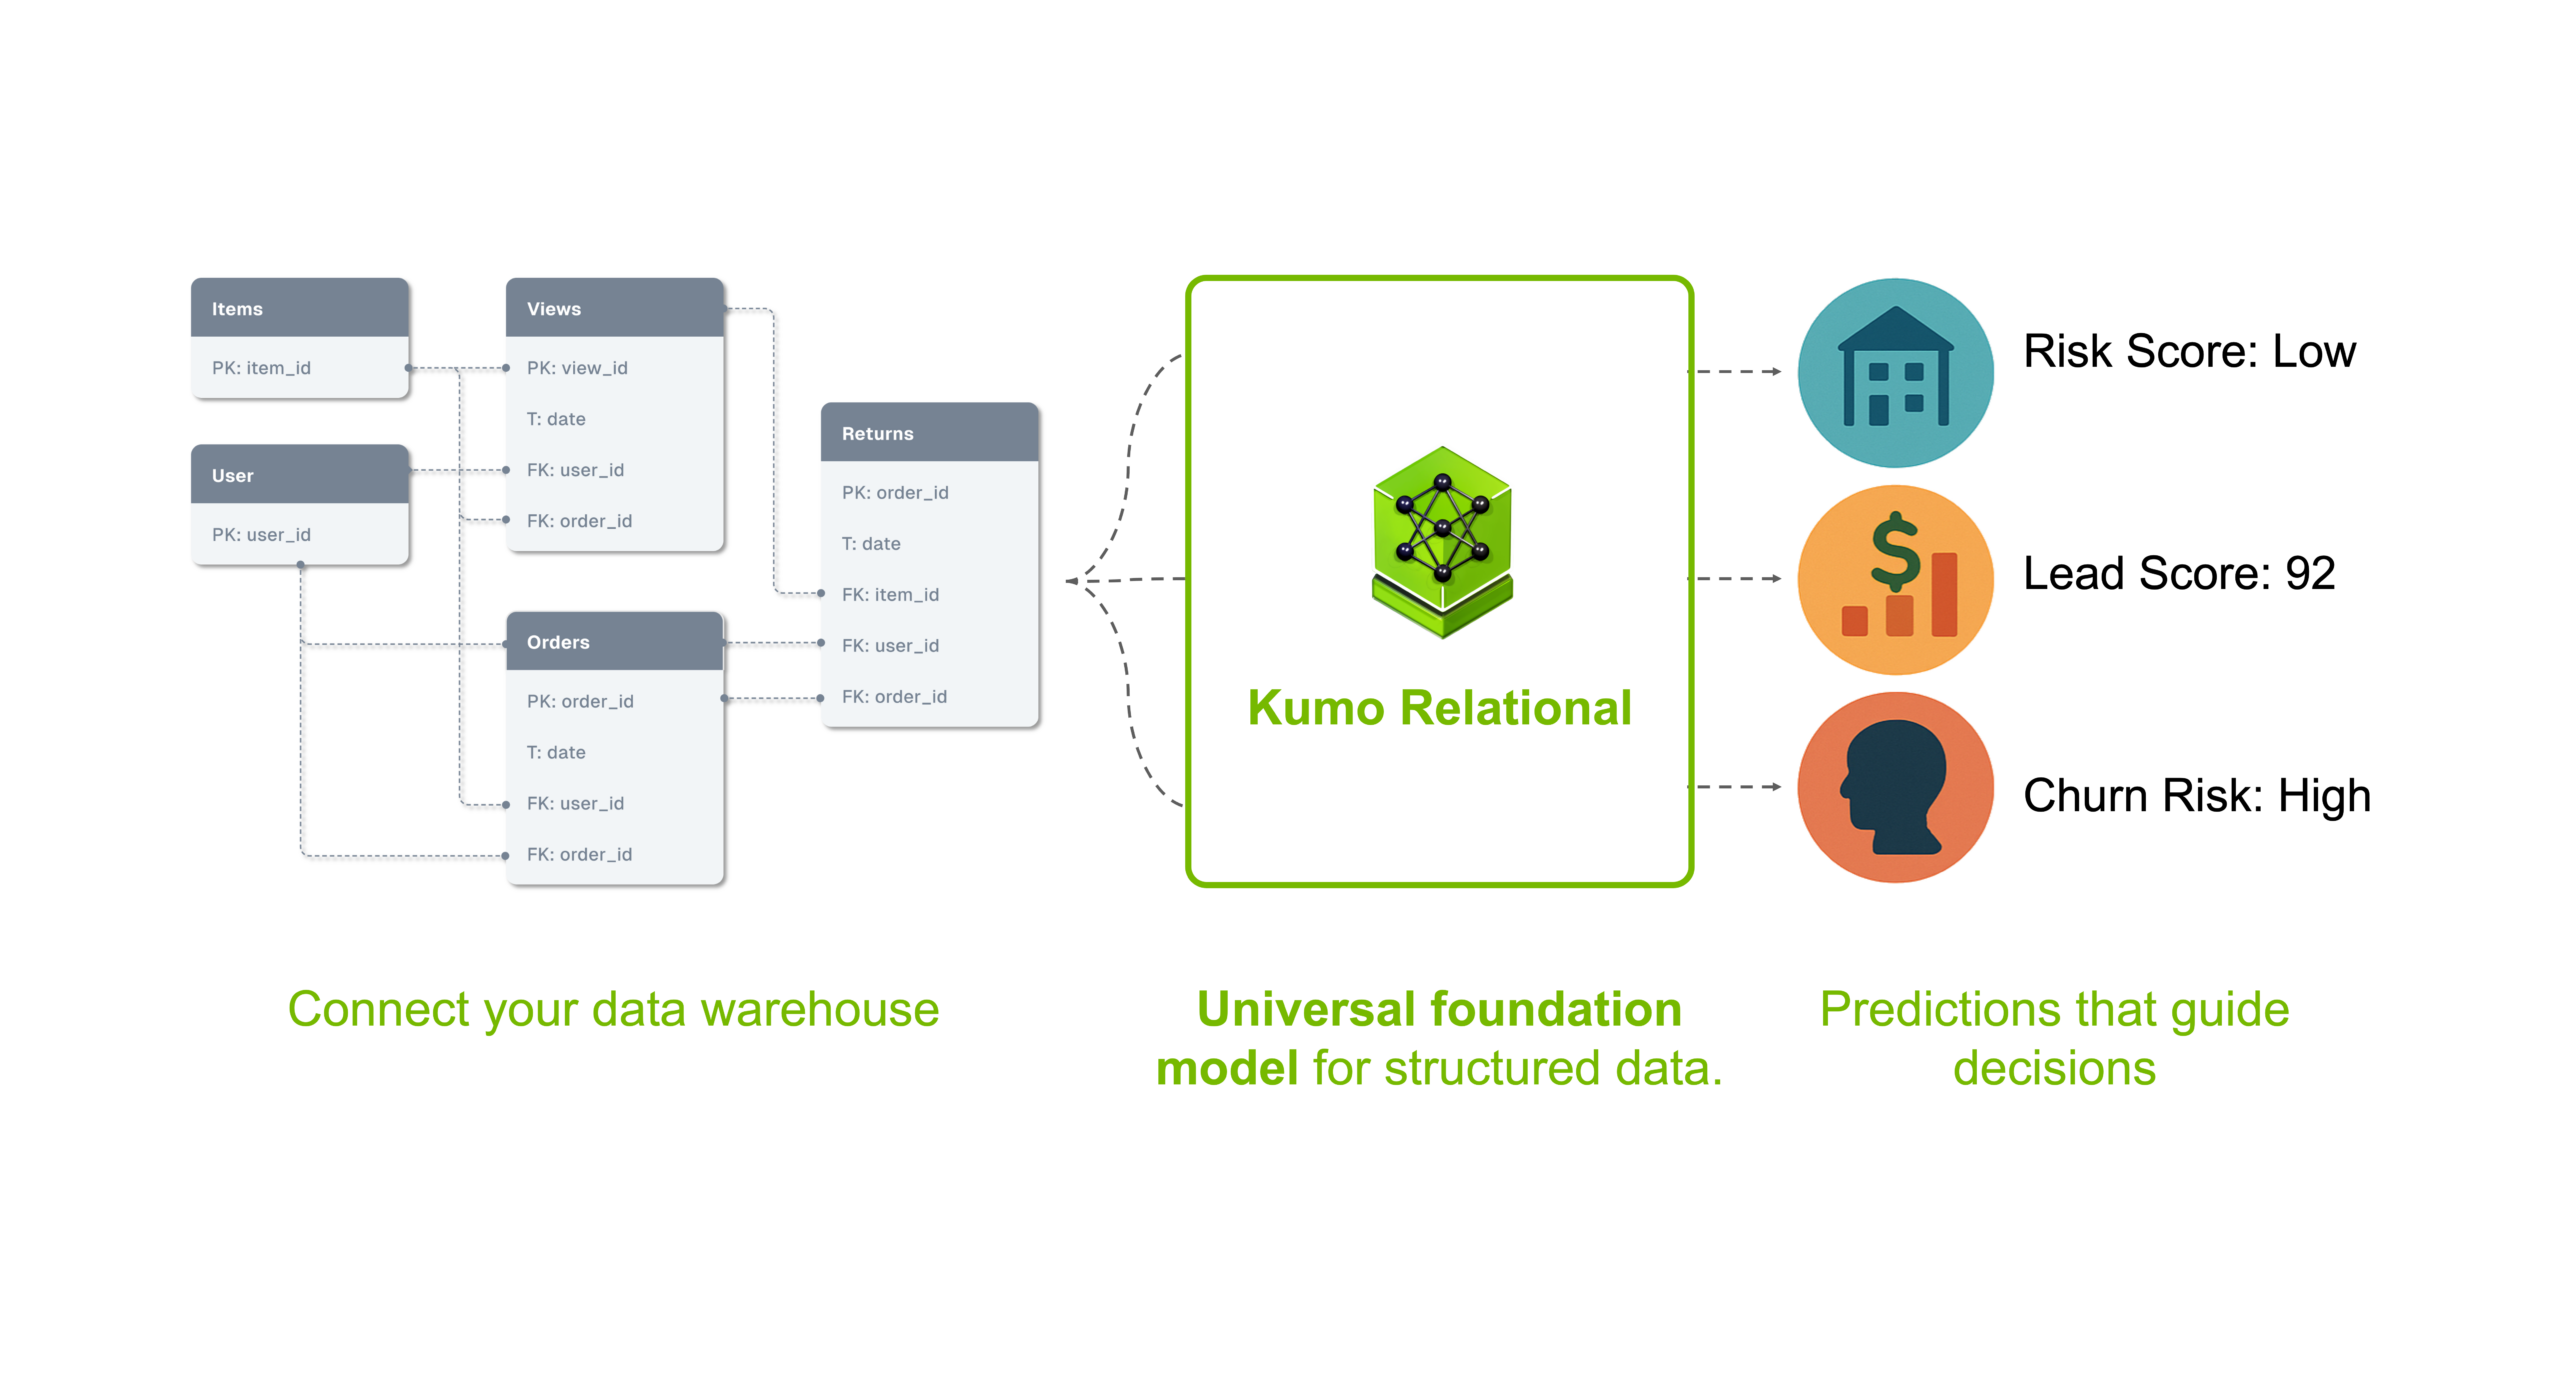
NVIDIA Kumo Relational:免训练的关系型数据预测基础模型
NVIDIA 发布了 Kumo Relational,一个直接运行在关系数据库上的预训练基础模型。给定一个预测查询,它会自动收集最多 10,000 条历史样本作为上下文,一次前向传播即可输出流失、需求、欺诈等预测结果。整个过程不需要任务专属训练、不需要特征工程、也不需要对多表做拼接展平。
它的核心卖点是成为第一个在常见关系型基准上超过监督学习的少样本基础模型。在 15 个数据库的 41 个任务上,它同时击败了关系型深度学习和专家手工特征工程加持的梯度提升树流程。在 SAP SALT 企业基准上,它比 AutoGluon 集成平均倒数排名(MRR)高 8%,微调后领先扩大到 16%。在 RelBench V1 分类任务上,它比基于专家特征的梯度提升树平均高出近 4 个 AUROC 点;在 SAP SALT 上比带工程特征的 XGBoost 高出 7 个 MRR 点,微调后高出 13 个。
工作原理分三步。第一,用预测查询语言(PQL)声明要预测什么,系统自动从数据库历史状态中生成上下文:对时间型任务,回放锚点时间戳之前的图谱子图,目标从锚点之后的事件计算,防止数据泄漏。第二,表内推理:轻量网络对每张表分别做列注意力和行注意力,过滤噪声。第三,表间推理:通过主外键关系上的图注意力,把行嵌入在关系结构上传播,并用跨样本注意力关联上下文示例。由于只处理行嵌入而不是所有单元格,避免了二次方成本。
预训练完全使用合成关系数据。合成数据生成器基于 PluRel,扩展单表数据生成器到完整关系数据库,分阶段生成 schema、外键链接和来自结构因果模型的列值。预训练分阶段进行,从单表到复杂关系结构。论文显示预训练损失随合成数据库数量呈幂律下降,收益可迁移到真实数据库。
在效率与精度的权衡上,RelArena-α 排行榜显示 Kumo Relational 开箱即用就处于准确率-效率的帕累托前沿:约 17 秒处理 1,000 个样本,Elo 1,842;最高分条目 rt-plurel 达到 Elo 1,878 但耗时约 7,300 秒,慢了约 430 倍。
模型在极端条件下依然稳健:只用 0.2% 的训练数据作为上下文时表现良好;删除多达 75% 的外键链接仍保持稳定;添加大量噪声列也几乎没有退化。限制也很明确:对于非常大的训练集,任务专属监督模型仍可能超过上下文预测,因为基准中最多只用 1 万个上下文样本,此时可以微调;预测信号必须能在有限跳数内到达,因此建议从聚焦查询开始。
Kumo Relational 已开源。代码在 structured-data-models 库中,GPU 原生,权重首次使用时从 Hugging Face Hub 下载,Apache 2.0 许可;模型权重使用 OpenMDW 1.1 许可。也可以通过 NVIDIA NIM 作为独立服务部署,客户端负责收集上下文并发送 PQL 查询。它支持 500B+ 行数据库,通过内存映射 I/O 以最高 5 GB/s 速度读取。
论文、文档、代码链接均在原文中提供。


