BigQuery Python UDF 日志记录:让数据管道可观测
Google Cloud 宣布 BigQuery Python UDF 新增日志记录功能。开发者可以在 UDF 内部直接使用 Python 标准 logging 库,将结构化日志无缝发送到 Cloud Logging,无需外部插件或自定义连接器。该功能覆盖范围很广,但官方用一个构建容错数据管道的示例来演示:在查询执行期间捕获行级诊断遥测,帮助团队隔离问题记录、触发实时告警、用 SQL 排查,而无需中断整个工作负载。虽然演示用 Python 负责验证和转换,但 Python 驱动的日志与验证可以无缝集成到基于 SQL 转换的管道中。
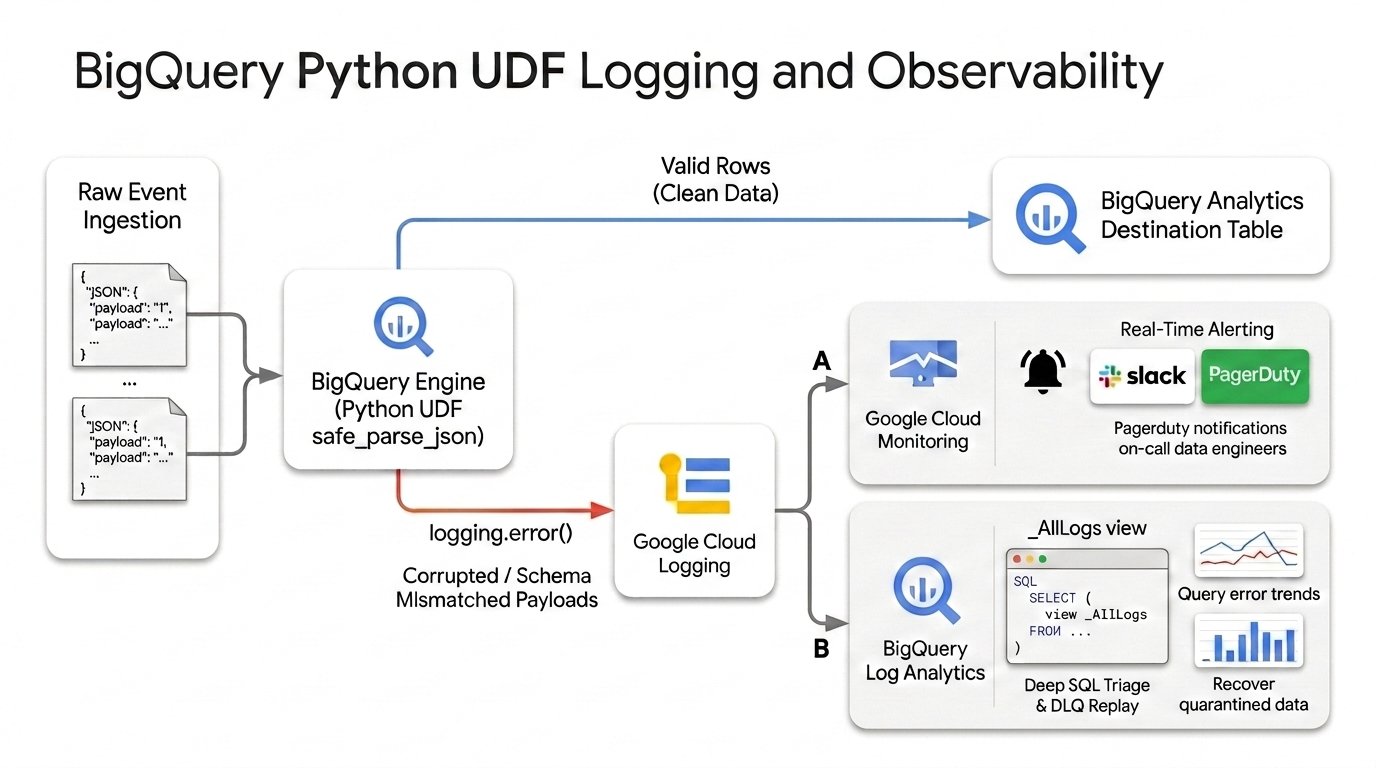
架构分三个阶段。内联验证阶段,Python UDF 解析传入的 JSON 负载,有效记录进入目标表,损坏或不兼容的行会触发 logging.error() 并返回 NULL,避免查询失败。实时告警阶段,Cloud Monitoring 的日志指标在错误率超过 SLA 阈值时通知团队。SQL 分类与重放阶段,数据工程师用标准 SQL 查询关联的 _AllLogs 视图,定位隔离负载,诊断根因,并在数据修复后重新摄入。
快速入门有四个步骤。第一步创建通用 Python UDF,它解析 JSON 并检查必填字段,解析失败或缺少关键字时记录结构化诊断 JSON 并返回 NULL。第二步启用日志,在会话中设置 SET @@udf.properties,模拟一个电子商务事件接入管道,处理 click、view、checkout 等用户动作。结果中 evt_001、evt_004 标记为 VALID,坏的行被路由到 Cloud Logging,查询成功继续,不中断。第三步在 Cloud Monitoring 中配置实时告警,在 Logs Explorer 粘贴对应 UDF 例程的日志过滤器,点击创建提醒,设置 Slack、PagerDuty 或 Email 等通知渠道。第四步用 BigQuery Log Analytics 分类坏行:前提是在 Cloud Logging 存储桶上启用 BigQuery Log Analytics 并创建关联数据集。示例日志输出包含两条 ERROR:一条是 MISSING_REQUIRED_KEY user_id,负载为 {“event”: “view”};一条是 JSON_SYNTAX_ERROR,负载为 corrupted_json。因为原始负载完整保存在 Cloud Logging 中,修复上游数据后,可以直接用 SQL 恢复隔离记录。最终 clean_events 表包含原有有效记录和恢复的记录,无数据丢失。
官方还列举了其他用例。影子执行与安全迁移:在 UDF 中并行运行旧版和新版业务逻辑,将旧版结果返回生产环境,同时把计算差异记录到 Cloud Logging。PII 编辑审计:在写入 BigQuery 前掩码 SSN 或账号等敏感令牌,同时向 Cloud Logging 发出匿名审计事件。ML 推理漂移:当嵌入式评分逻辑遇到词汇表外输入或低模型置信度时,记录警告日志。
最佳实践有三条。启用调试输出,在会话中设置 SET @@udf.properties = JSON ‘{“enableDebugOutput”: true}’。避免在日志中写入敏感数据,因为 Cloud Logging 对有 Logging Viewer 权限的用户可见,不能记录凭据或密钥。成本管理,高吞吐管道要有选择地记录,比如只记录错误或采样,以控制日志摄入量。