Liquid AI 发布视觉版 DSpark 草稿模型,加速 VLM 推理
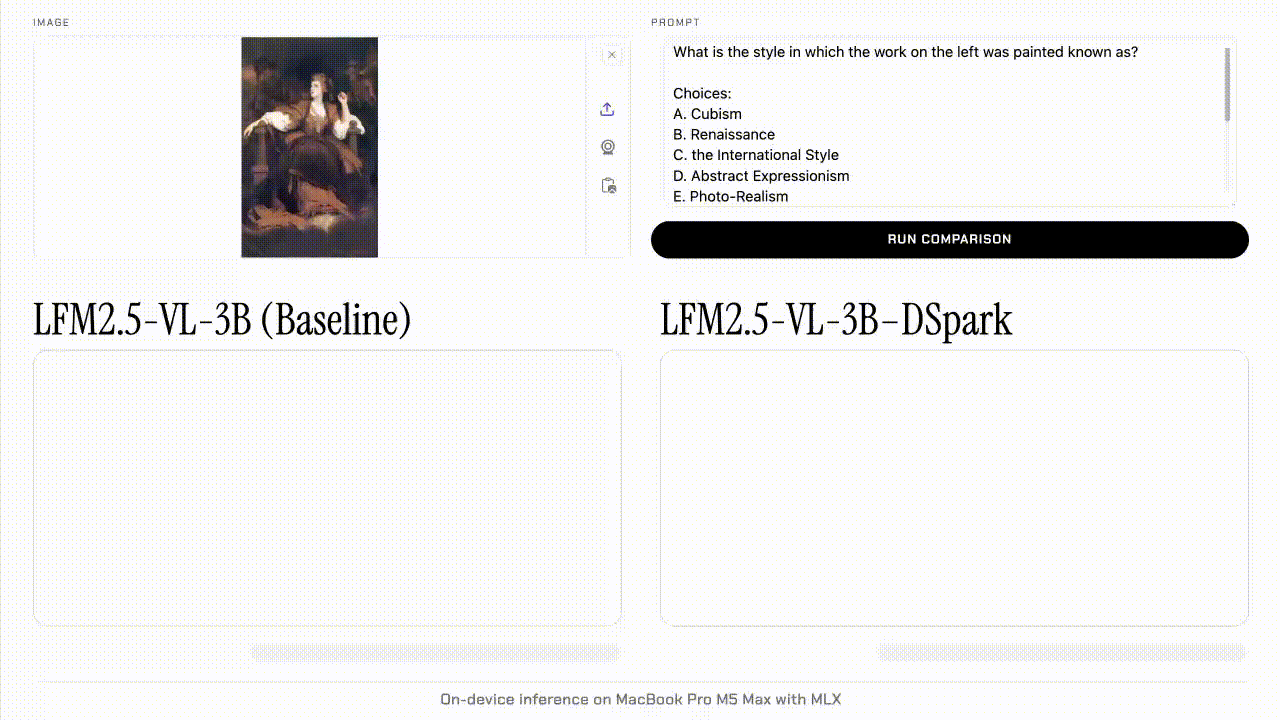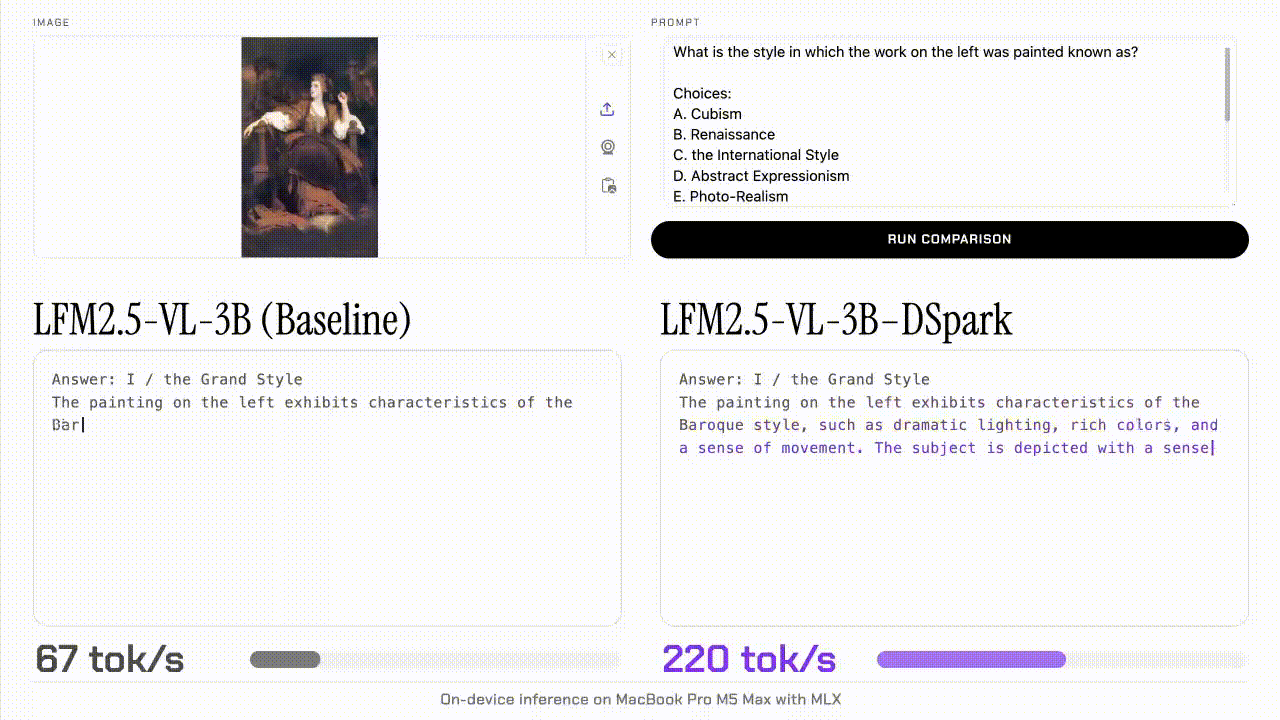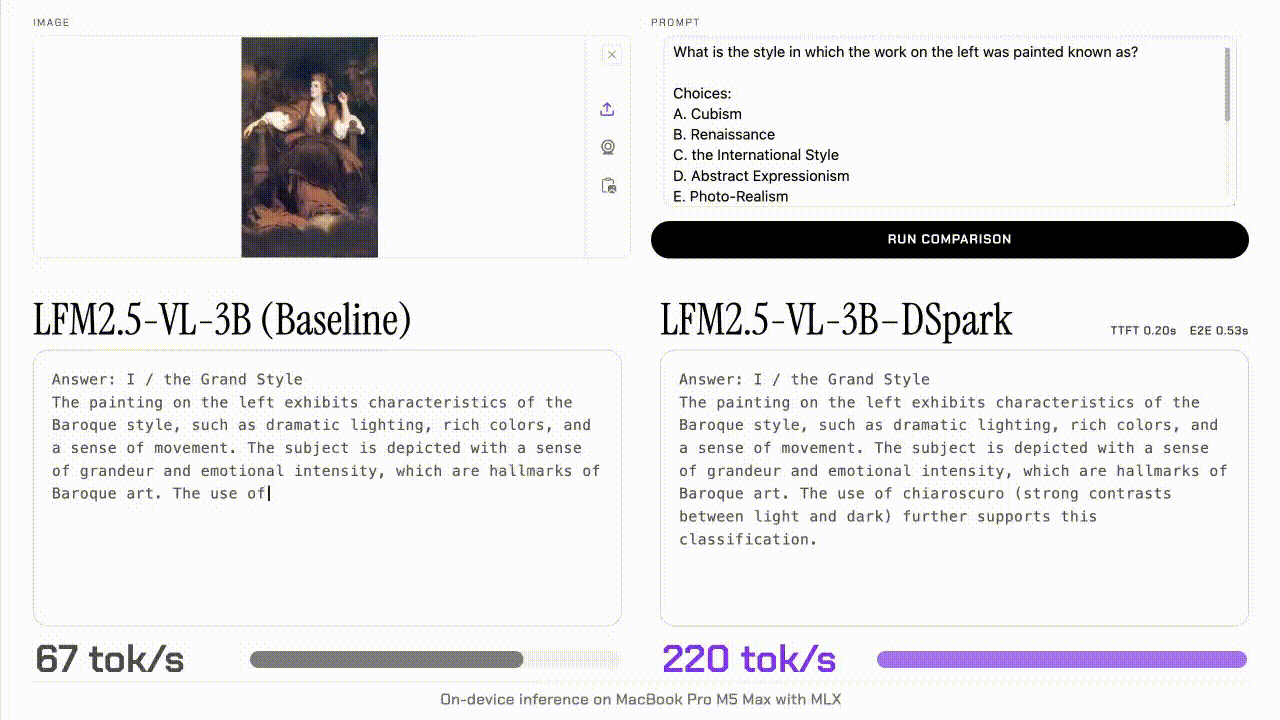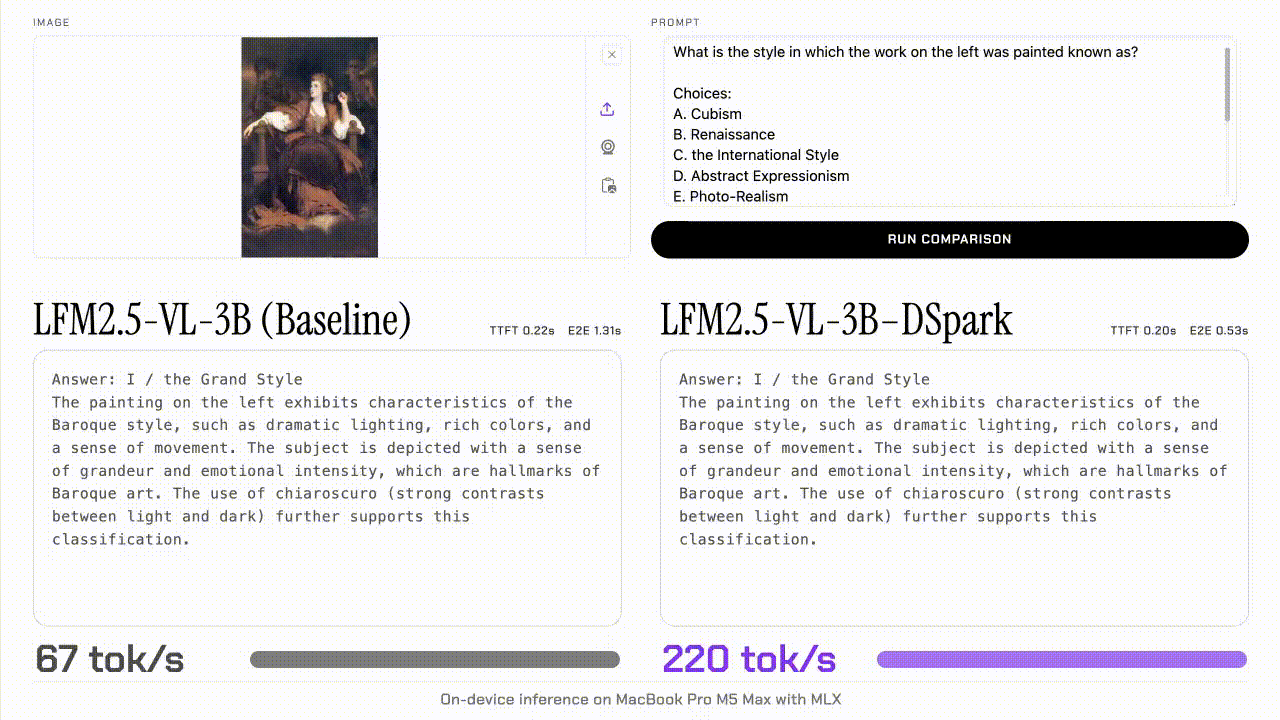
Liquid AI 发布了一款实验性的 DSpark 草稿模型,用于加速其视觉语言模型 LFM2.5-VL-3B。该模型延续了此前文本领域 LFM2.5-DSpark 的思路,通过投机解码(speculative decoding)在几乎不增加内存开销的情况下显著提升推理速度,且不改变输出质量。解码速度在设备端最高可达 3.13 倍,在 H100 上最高 2.66 倍;端到端延迟提升分别最高至 2.62 倍和 2.27 倍。草稿模型仅新增约 2.8 亿参数,占目标模型 30 亿参数的 8.9%。
视觉草稿模型与文本版采用相同架构:在固定的 tapped layers 捕获目标模型的隐藏状态,并据此一次性草拟 k 个候选 token。图像 patch 和文本 token 在进入这些层之前先被投影到共享表示空间,因此无论输入模态如何,草稿模型操作的隐藏状态向量维度一致,推理算法与文本模型完全相同。训练采用 DSpark 配方,混合视觉语言 SFT 数据,并偏向预期的工作负载。经过 3/4/5 层的消融实验,最终选择 4 层、块大小 9 的简化 attention-only 草稿模型。在最终数据混合上训练 10 个 epoch,接受率随训练 token 增加而提升,直至收益递减。推理时建议根据硬件选择块大小 8 或 9。
组件参数分解如下:解码器堆栈(4 层)193.0M,隐藏状态投影 21.0M,马尔可夫头 65.5M,范数 + 置信头 6.4k,总计 279.5M。模型发布首日即支持 llama.cpp、MLX-VLM 和 SGLang 三种集成。在 MLX 上(M5 Max),解码加速 2.30-3.13 倍,端到端 1.56-2.62 倍;llama.cpp 上(M3 Ultra),解码 1.57-2.14 倍,端到端 1.30-1.77 倍;H100 上解码 2.04-2.66 倍,端到端 1.64-2.27 倍。注意原文中 H100 解码加速写为 ‘20.4x’,明显是笔误,应为 2.04 倍,此处按合理值解读。
投机解码的局限在于:它只加速 decode 阶段,不加速视觉编码和 prefill。VLM 中图像编码和视觉 token 处理占比高,边缘设备计算能力弱,prefill 在端到端延迟中占比更大。这就是 Amdahl 定律——整体加速受限于未被加速的部分。运行方式:SGLang 需带 DSpark 支持的构建(PR #40651),指定草稿模型和块大小;llama.cpp 需对应构建(PR #29339),使用 –spec-type draft-dspark;MLX-VLM 需构建(PR #2280),块大小从 sidecar 元数据读取。投机解码是精确的,目标模型验证每个建议 token,贪心输出与单独运行目标模型完全一致。模型以 Safetensors 和 GGUF 格式开源在 Hugging Face 上。


