tokenizers v1:编码、解码与扩展性能实测
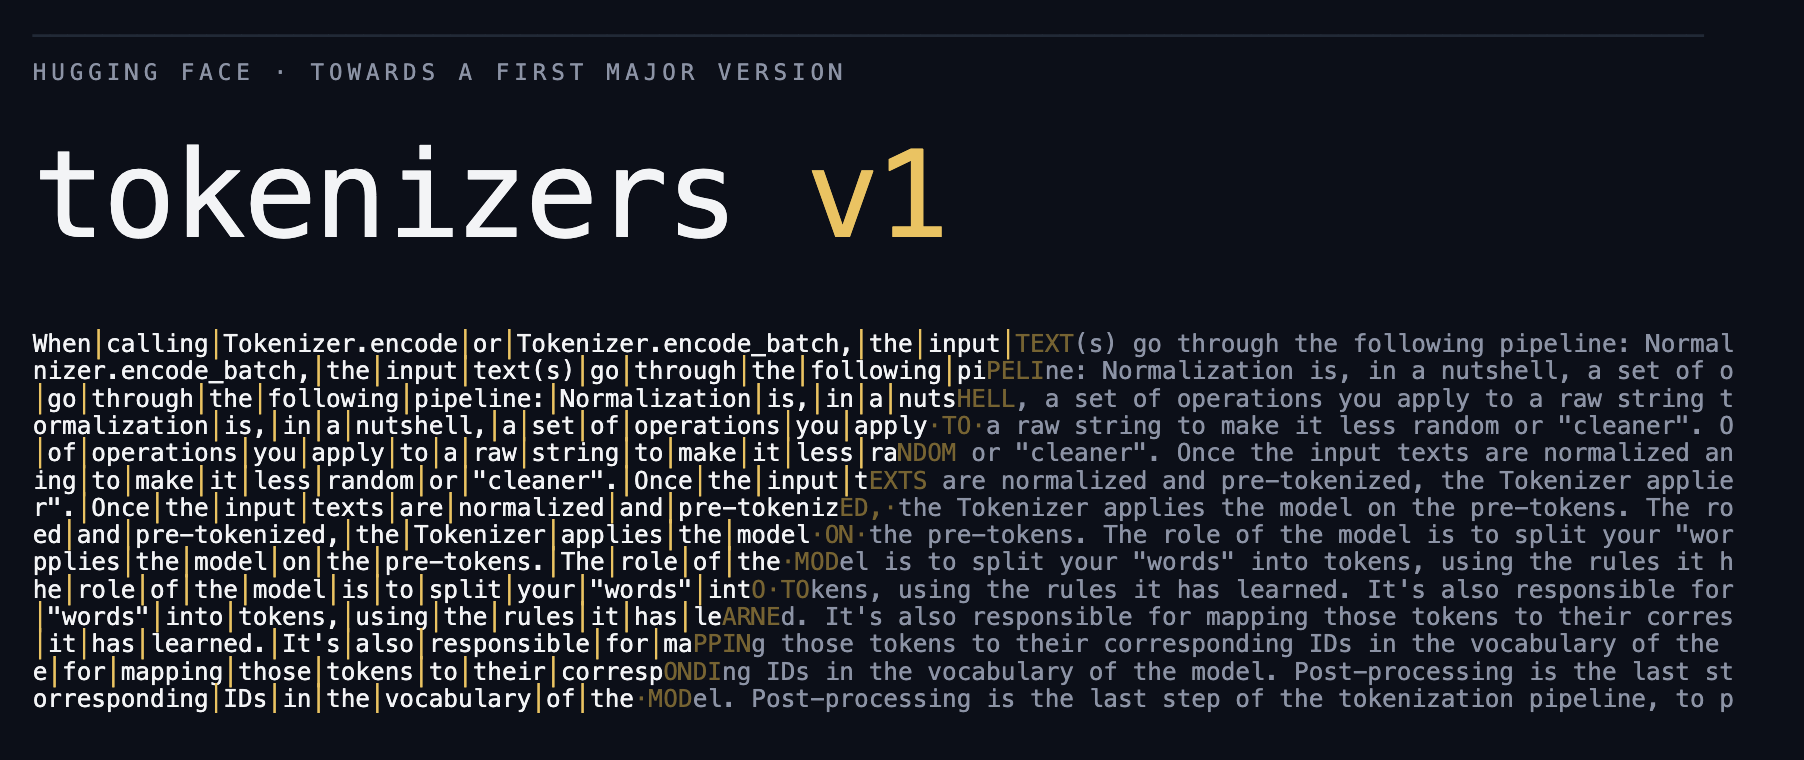
在多数机器学习工作流里,tokenizer 从来不是瓶颈。计算上,分词比大规模建模轻得多。但模型变快、负载变大后,训练海量数据、并发服务大量请求、反复处理长输入,都可能让 tokenizer 抢不到足够 CPU 时间,反过来让 GPU 空等。Hugging Face 这次重写 tokenizers v1,核心目标就是让分词足够快,能随工作负载扩展。
v1 不改变输出:它产生与 v0.23 完全相同的 token ID。API、词表、merge ranks 都保留,只是把内部实现重新做了一遍。tokenizer 把文本转成模型读取的整数列表,分四步:normalization、pre-tokenization、model、post-processing。本文的性能工作主要集中在 model 阶段,被测试的十个模型族里有八个使用 BPE。
具体改动包括:单一 crate 拆成 workspace,tk-encode 是唯一必需的运行时,tk-serialize、tk-convert、tk-train 按需链接;模型合并工作集放进调用者拥有的 scratch buffer,循环过程不碰内存分配器;BPE 的正则分割改成基于位流的布尔运算,用 SIMD 找切分点;合并循环改用预分配 buffer 内的 intrusive 双向链表,一次合并只更新两个索引;新增线程本地 word cache,重复 pre-token 直接取缓存结果;多个线程可共享同一个 tokenizer,每个线程从自己的子池取资源,不再全局排队抢锁。
其中对分割的改动最依赖模式识别。BPE 模型的正则随模型固定、运行期不变,所以不需要通用正则引擎每次解释。bitcannon 把输入字节视为并行位流,用 CPU 的 SIMD 指令做布尔运算,一次寄存器操作处理 64 字节,思路与 Parabix、simdjson 一致。但只有少数语法覆盖大部分字节级 BPE 模型;不在覆盖范围内的 tokenizer 仍走正则路径,也拿不到这部分加速,这正是不同模型加速幅度差异巨大的原因。
word cache 的前提是真实文本重复词多。输入越大,唯一词增长通常慢于总词数,重复词占比提高,缓存命中率也上升;反之,如果输入几乎不重复,查找缓存本身就成了开销。tokbench 的基准方法也刻意区分两种工作负载:反复编码同一文档,以及编码持续到来的不同文档。头条数据用的是后者,完整语料太大,放不进缓存。
为了跨引擎公平,tokbench 做了严格约束:所有引擎跑同一计时循环,词表加载单独计时,输出 ID 用 FNV-1a 哈希校验与基线一致,只统计所有引擎都跑过的单元,每个 repeat 在新进程中开始,worker 固定到八个不同物理核、不用 SMT 兄弟线程。测量覆盖单线程、多线程、跨线程扩展、逐模型和逐语言对比,以及延迟、解码吞吐、内存堆和 crate 体积。在 Apple M4 Max 上单线程实测,v1 比 v0.23 快 3 到 30 倍,其中 t5-base 是最低端,gpt2 是最高端;八线程扩展为线性扩展的 76%。
release candidate 已发布在 crates.io,API 不变,安装命令是 cargo add tokenizers –pre。训练功能默认开启并拉入 C++ 依赖,只需要编码时可以关闭。Python bindings 包装同一套代码,但每次调用的额外开销不计入上述测量。下一步是把更多模型族迁移到新合并循环,然后推进 transformers 等依赖 tokenizers 的生态适配。1.0.0 之后计划探索 GPU 分词,先做原型验证。