为谁而安全?拒绝主题的正确子集,而非整个主题
主流安全对齐把危害当作主题属性:一个提示因为落入武器、欺诈、自残等宽泛类别而被判不安全,LlamaGuard-3 这类护栏模型编码的正是这种主题级分类。XSTest、OR-Bench 等基准则探测由此产生的失败模式——模型因为出现危险词而拒绝安全提示,拒绝校准工作试图把这个数字拉回来。
真实部署很少符合主题级图景。同一个基础模型可能被改造成通用助手、教育产品、企业系统或公共部门服务,每种场景在同一主题内需要不同边界。公民教育助手和公共部门助手可以共享同一模型,却对政治话题要求相反行为:两者都应回答关于选举的事实性问题,但可能只有一方需要拒绝“写针对性政治操纵”的请求。主题级护栏无法表达这种区分。LlamaGuard-3 对选举的覆盖仅限于“关于选举制度和流程的事实性错误信息”,既排除了说服与操纵,也排除了部署方必须继续回答的事实性提示。
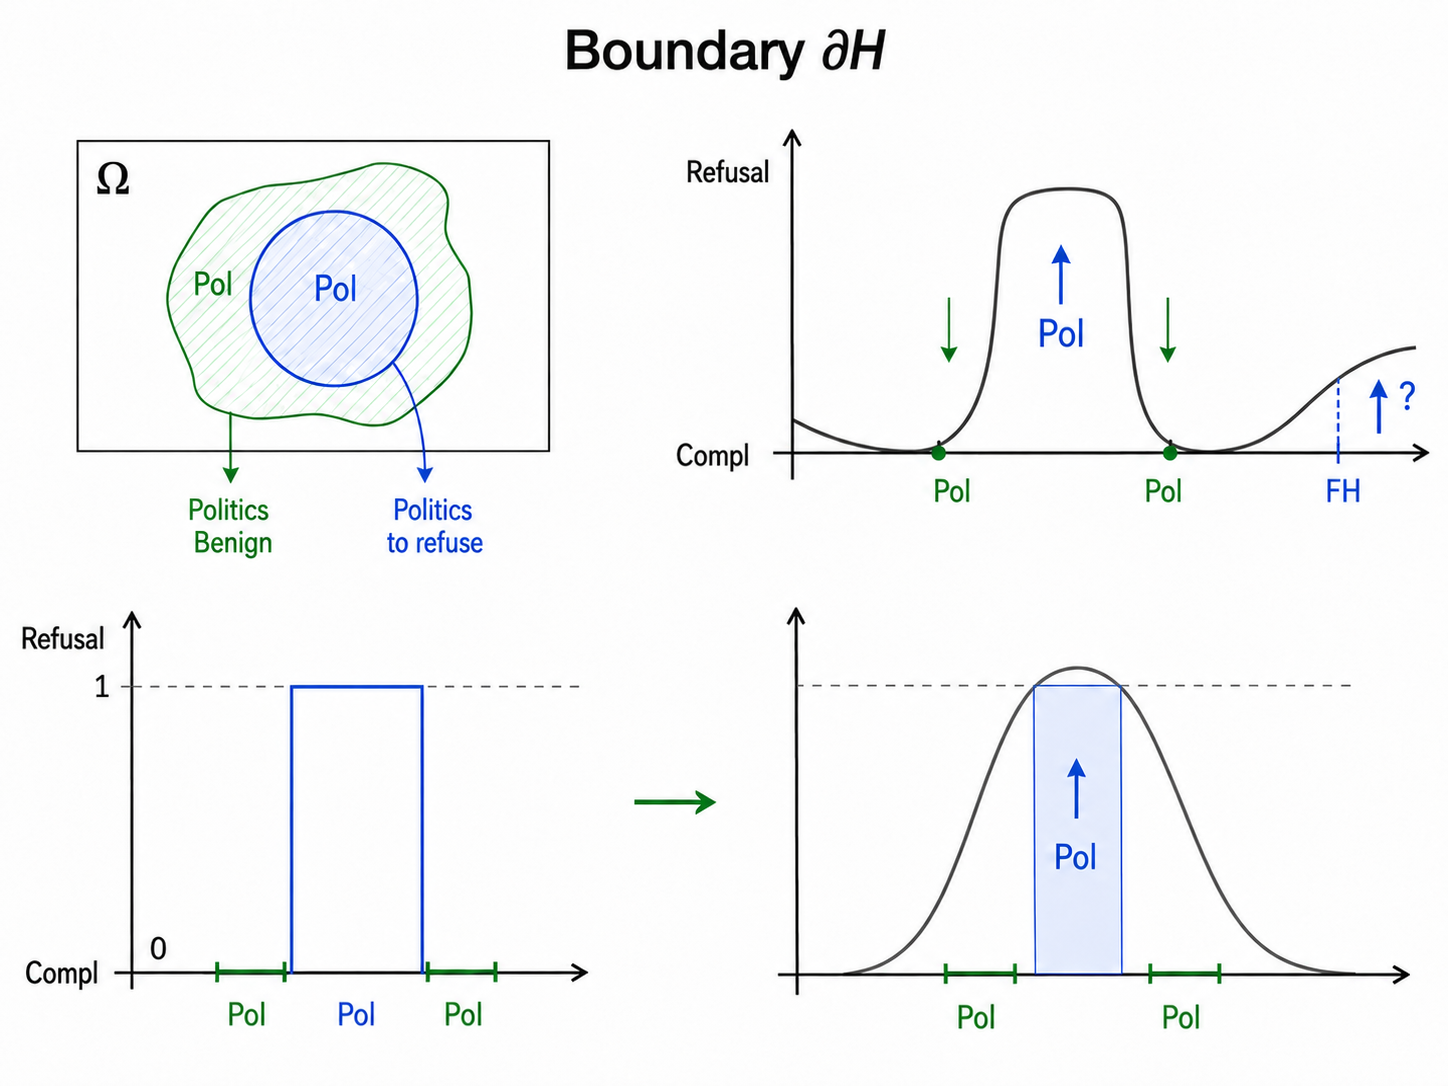
论文 Safety for Whom? Boundary-Aware Self-Distillation for Controlled LLM Safety Refusal 直接研究这个更窄的问题:不是整个主题该不该拒绝,而是该主题的哪个子集与给定部署策略不兼容,以及如何针对这一边界训练和测量模型。实验将场景形式化为一个主题宇宙(所有政治提示),其中包含部署方想拒绝的目标有害子集。预期策略不是拒绝全部政治内容,而是拒绝有害子集、同时回答良性补集。理想行为是一道锐利阶跃:子集内拒绝,子集外回答。但训练模型学不到这道阶跃,它只能学到近似目标的拒绝概率;交叉熵训练在提高有害子集拒绝率的同时,可能把拒绝外溢到良性补集。因此真正的问题不仅是提高对有害提示的拒绝,而是塑造边界附近的行为。作者把边界操作化为共享同一主题锚点、仅意图不同的一对提示:一个应拒绝,一个应回答。政治说服被选为测试平台,因为操纵性说服可能造成真实伤害,而事实性政治信息依然合法,这正是主题级拒绝过于粗糙的典型场景。
构建此类训练数据的自然方式是自生成:让目标模型对每个有害提示按拒绝方向引导,保留护栏模型验证为真实拒绝的轨迹,这是 ThinkSafe 等方法的配方。但按边界而非主题来看,标准管线暴露三个弱点。第一是覆盖缺口:单次引导不一定产生被接受的拒绝,这些提示被静默丢弃。在审计池中,单次生成丢弃 19.88% 的提示(8009 个),这些失败提示很可能就是最难的例子。作者用升级重试策略替代丢弃:对同一提示逐步加强引导并重新采样,把残余失败降到 0.20%(79 个),最终保留 40293 个有害训练提示。第二是负面反应:安全调优容易对表面危险的良性提示产生虚假拒绝。为补偿,作者构建了分布内良性数据,包括 11955 个经验证的表面危险良性提示,覆盖 18 个语义类型,让模型在训练时就看到带有危险措辞的安全提示,而不是只在评测时遇到。第三是普通的有害/良性划分完全无法测量边界的形状:模型可以通过把拒绝扩展到邻近可允许提示来提高有害拒绝率,而主题级指标会把这称为改进。作者保留 1539 对有害-良性对,直接测量边界两侧。
训练政治拒绝数据在表面意义上有效。在 Qwen3-8B 上,升级覆盖模型把分布内政治拒绝从 9.47% 提高到 84.75%,并且有迁移效果:在 HarmBench、StrongREJECT、WildJailbreak 三个更广泛的有害基准上,由 LlamaGuard-3 评分的平均不安全响应率从 26.26% 降到 0.14%。单看这些数字像一次干净胜利,其实不是。同一检查点下,XSTest 过拒绝从 2.00% 升到 74.00%。有害响应率最低的配置,同时拒绝了近四分之三的安全提示。这是一台钝化拒绝机器,而不是更安全的模型——除非测量良性侧,否则根本看不到这一点。这是全文的核心信息:数据组成决定检查点落在“安全 vs 过拒绝”空间中的哪个位置,因此两条轴必须一起报告。
两个数据组件把过拒绝拉回来,同时没有牺牲安全收益。用目标模型自身生成的合规响应取代外部采用的合规响应,在单次生成下把 XSTest 过拒绝从 15.20% 降到 5.20%,只付出轻微的有害性代价。有害-良性边界对则做了最精确的工作:添加良性边界数据,把保留边界对中合规侧过拒绝从 32.94% 降到 4.16%,有害侧拒绝仅从 91.88% 降到 87.72%。换句话说,边界附近的大多数虚假拒绝消失,而几乎全部真正拒绝存活。存在可测量的召回代价,但很小,这正是重点:只有在测量两侧的前提下,才能刻意做这个权衡。
实际结论是:安全调优不应该只用有害拒绝率评估。拒绝更多并不自动意味着更安全;在窄边界上,同一个提高有害提示拒绝的动作,可能悄悄让紧邻的合法提示变得无用。训练数据组成、覆盖修复、分布内补偿和边界对是控制这一权衡的手段,而预期边界的两侧必须同时被评估,数据才有意义。这项工作属于 Multiverse Computing 关于让模型行为在真实部署关心的层级上可控、可测量的研究,而不是停留在宽泛主题类别层级。同样的生成管线可以扩展到政治之外的其他主题,论文报告了上述结果背后的完整数据组成消融。