IBM时间序列模型集成Confluent实现实时智能
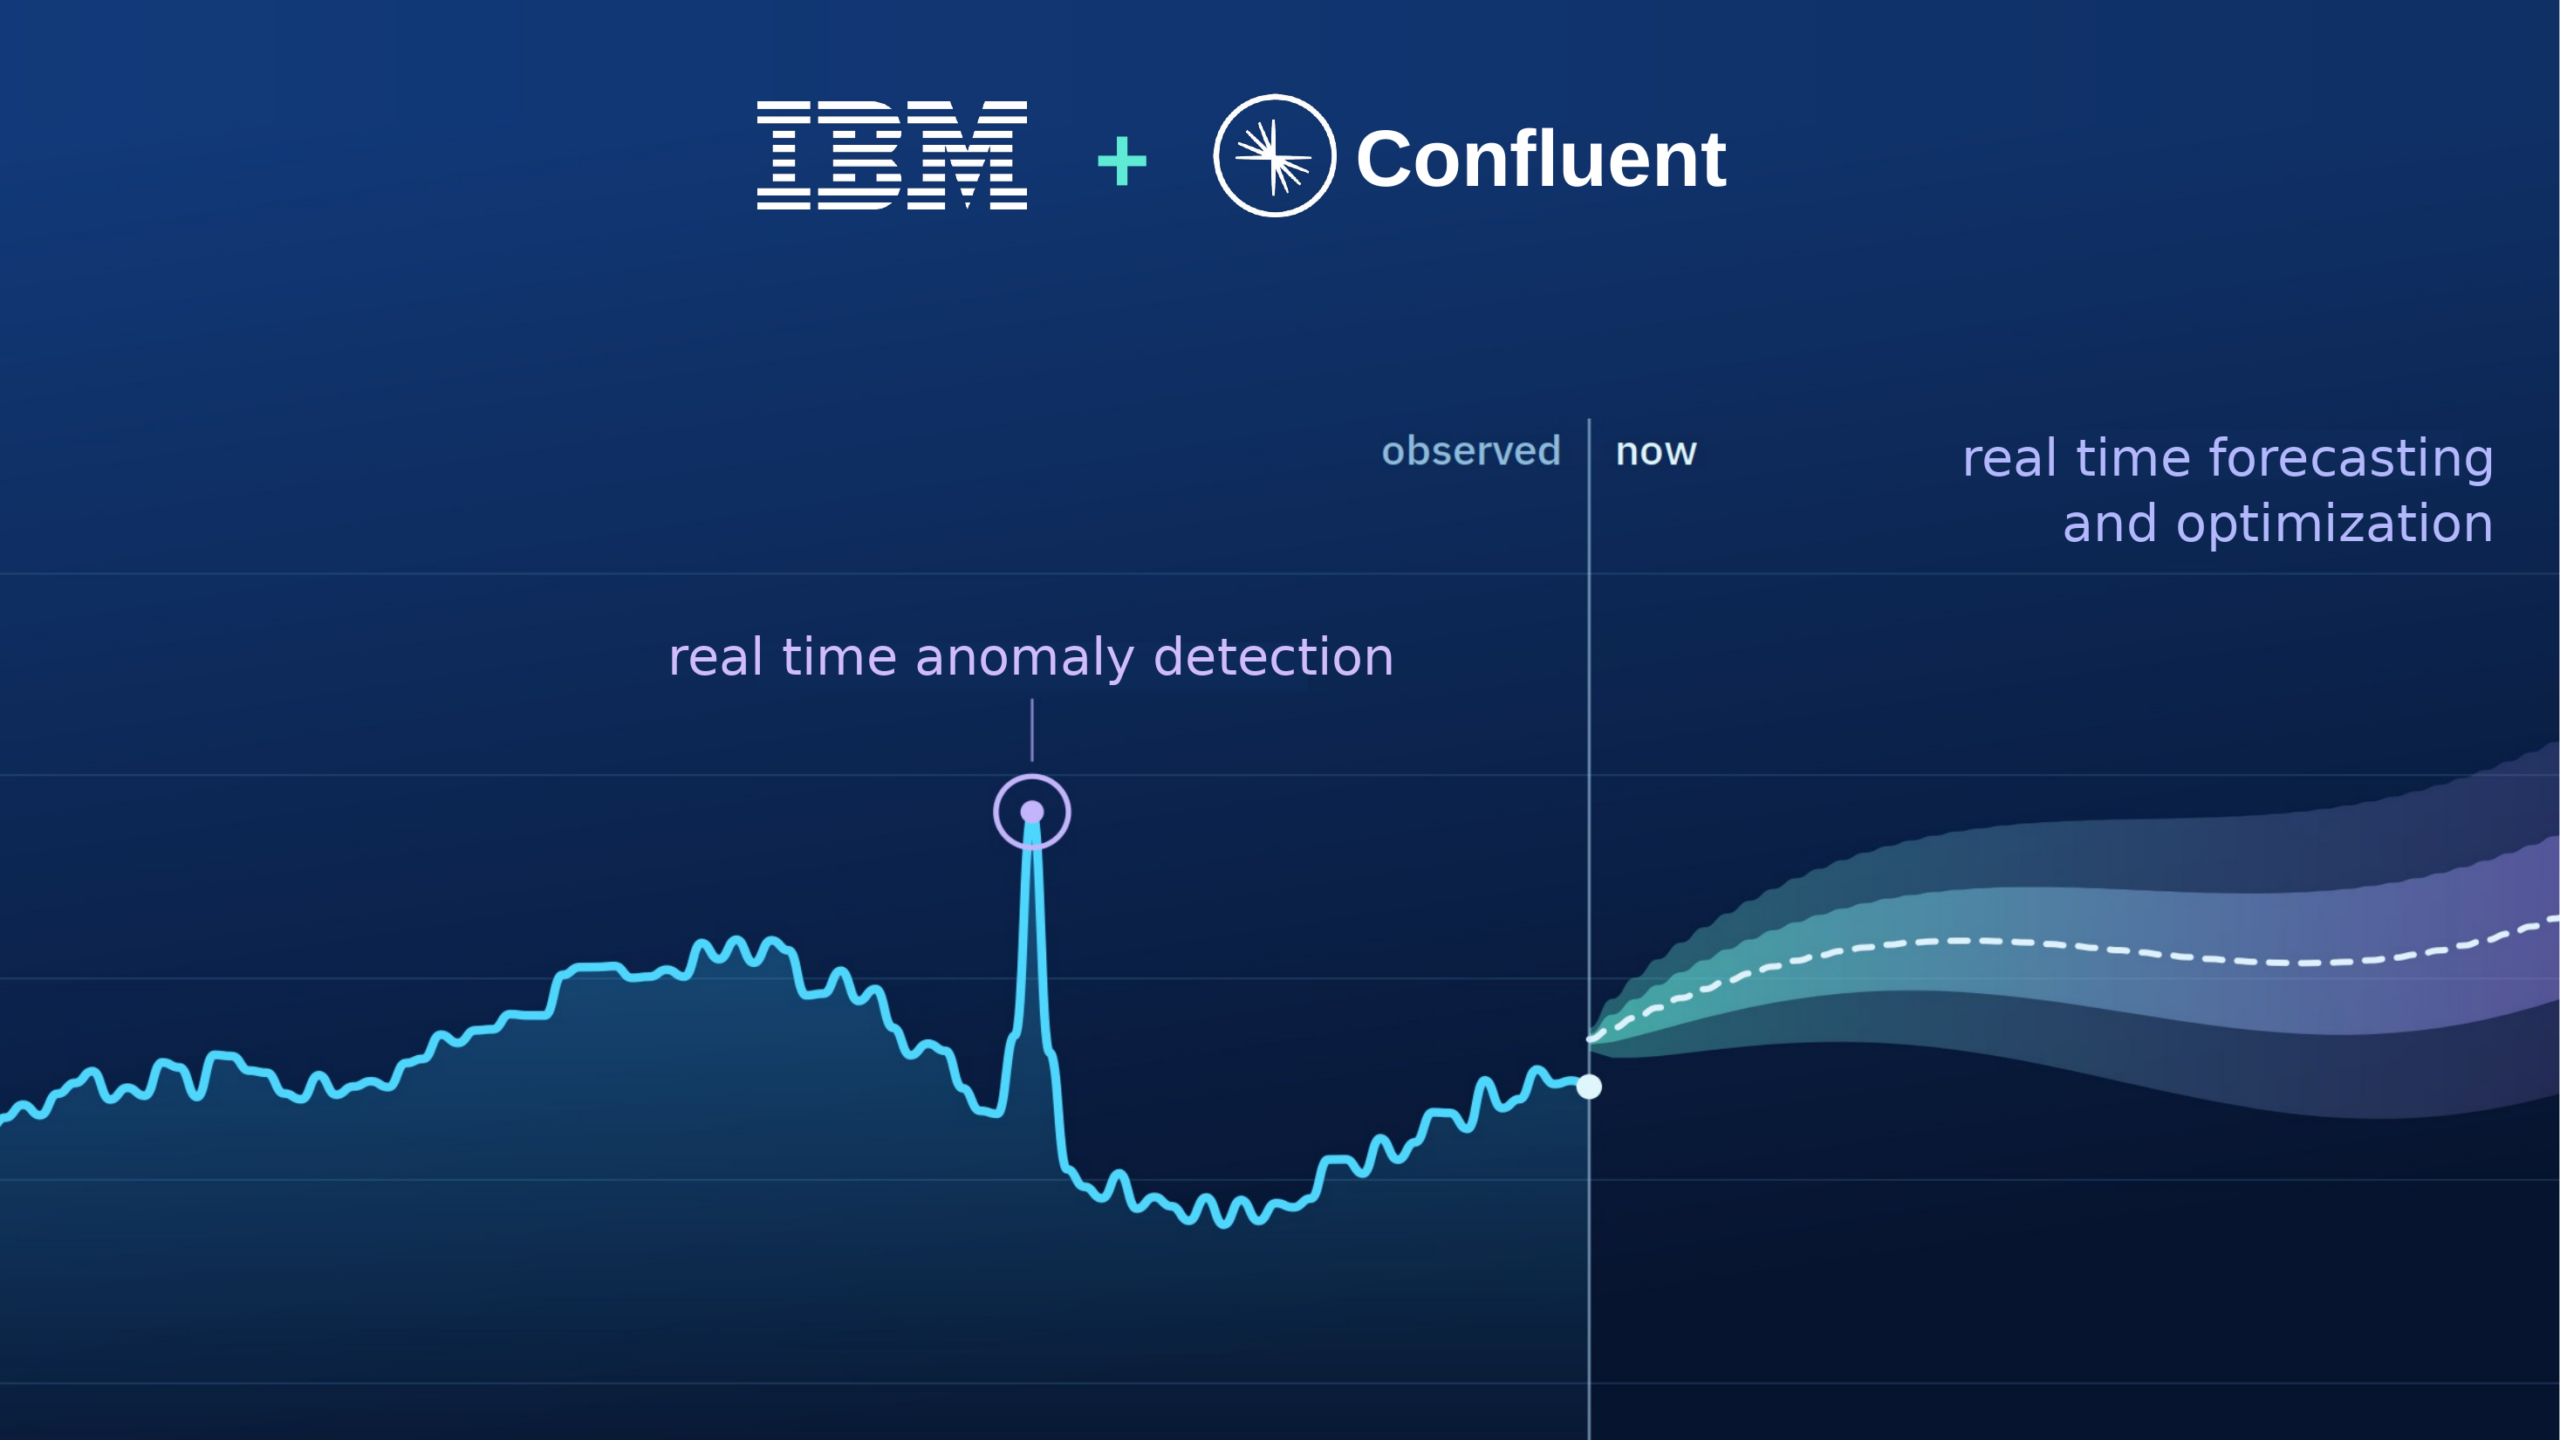
IBM 和 Confluent 合作,将时间序列基础模型(TSFM)直接集成到 Confluent Cloud 的实时数据流中,现已进入 Early Access。核心思路是:不再为每个时间序列单独训练模型,而是用一个通用模型处理任意序列,直接在流上完成预测、异常检测、相似搜索、优化等任务。
过去,关键决策依赖逐个定制的模型,每个都需要数月专家工作,导致大多数序列只能靠安全库存和余量覆盖,代价是每个周期都在为无法预测的决策买单。TSFM 改变了这一点:在大量多样化信号上训练一次,就能泛化到未见过的序列。IBM 在自身产品以及水泥、钢铁、食品、电信等行业的客户中验证过,宣称准确性每提升 1 个点价值数百万美元,生产力提升 5 到 10 倍,且原本需要数据科学家的任务现在由领域专家直接完成。
IBM 提供了四个互补的模型,通过 Flink SQL 的 AI_FORECAST 和 AI_DETECT_ANOMALIES 函数调用,切换模型只需改一个 SQL 参数,无需改造管道。PatchTST-FM 像语言模型一样逐块读取序列,每个变量独立通道,返回完整分布,适合规划场景。FlowState 用连续时间动态,能同时处理秒级 SCADA 数据和小时级市场数据。TTM 用极小的混合网络,百万参数模型可在 CPU 上每晚覆盖十万个序列。TSPulse 结合时间和频率视角,用于异常检测、分类、补值,并回答“以前见过吗”。这些模型设计得小,推理直接在 Confluent Cloud 内运行,或使用 Hugging Face 的开源权重在自有 CPU 上跑,无云入/出流量费。
具体应用场景:
– 预测与规划:零售商可用一个模型覆盖全部 SKU,无需逐 SKU 建模,支持天气、促销等驱动因素,输出分布而非单点值,每个预测直达 Kafka 主题,触发补货、定价、促销等动作。
– 异常检测:在金融场景中,模型对每张卡维护正常行为基线,在支付进行中实时评分,检测到漂移立即告警,且能从银行自身流中持续定制,随新欺诈模式更新。
– 生产优化:工厂工程师将模型放在流上,条件化控制参数,把预测变成模拟器,优化器搜索最佳设置并解释理由,且能随原料变更、需求变化重新优化。
– 语义智能:模型将时间窗口编码为嵌入向量,与历史事件匹配,返回相似案例和解决方案,支持分类、补值,并为 AI Agent 提供上下文检索。
所有推理结果写入 Kafka 主题,可被告警系统、仪表盘、数据湖和 AI Agent 消费。Confluent Cloud 原生推理提供零配置、内置治理、成本效率(无需专用 GPU 和基础设施)和增强安全。作者强调,这只是一个开始,时间序列领域的进展速度与语言模型类似,创新会持续。