LFM2.5 Q4_0:用于边缘部署的量化感知蒸馏
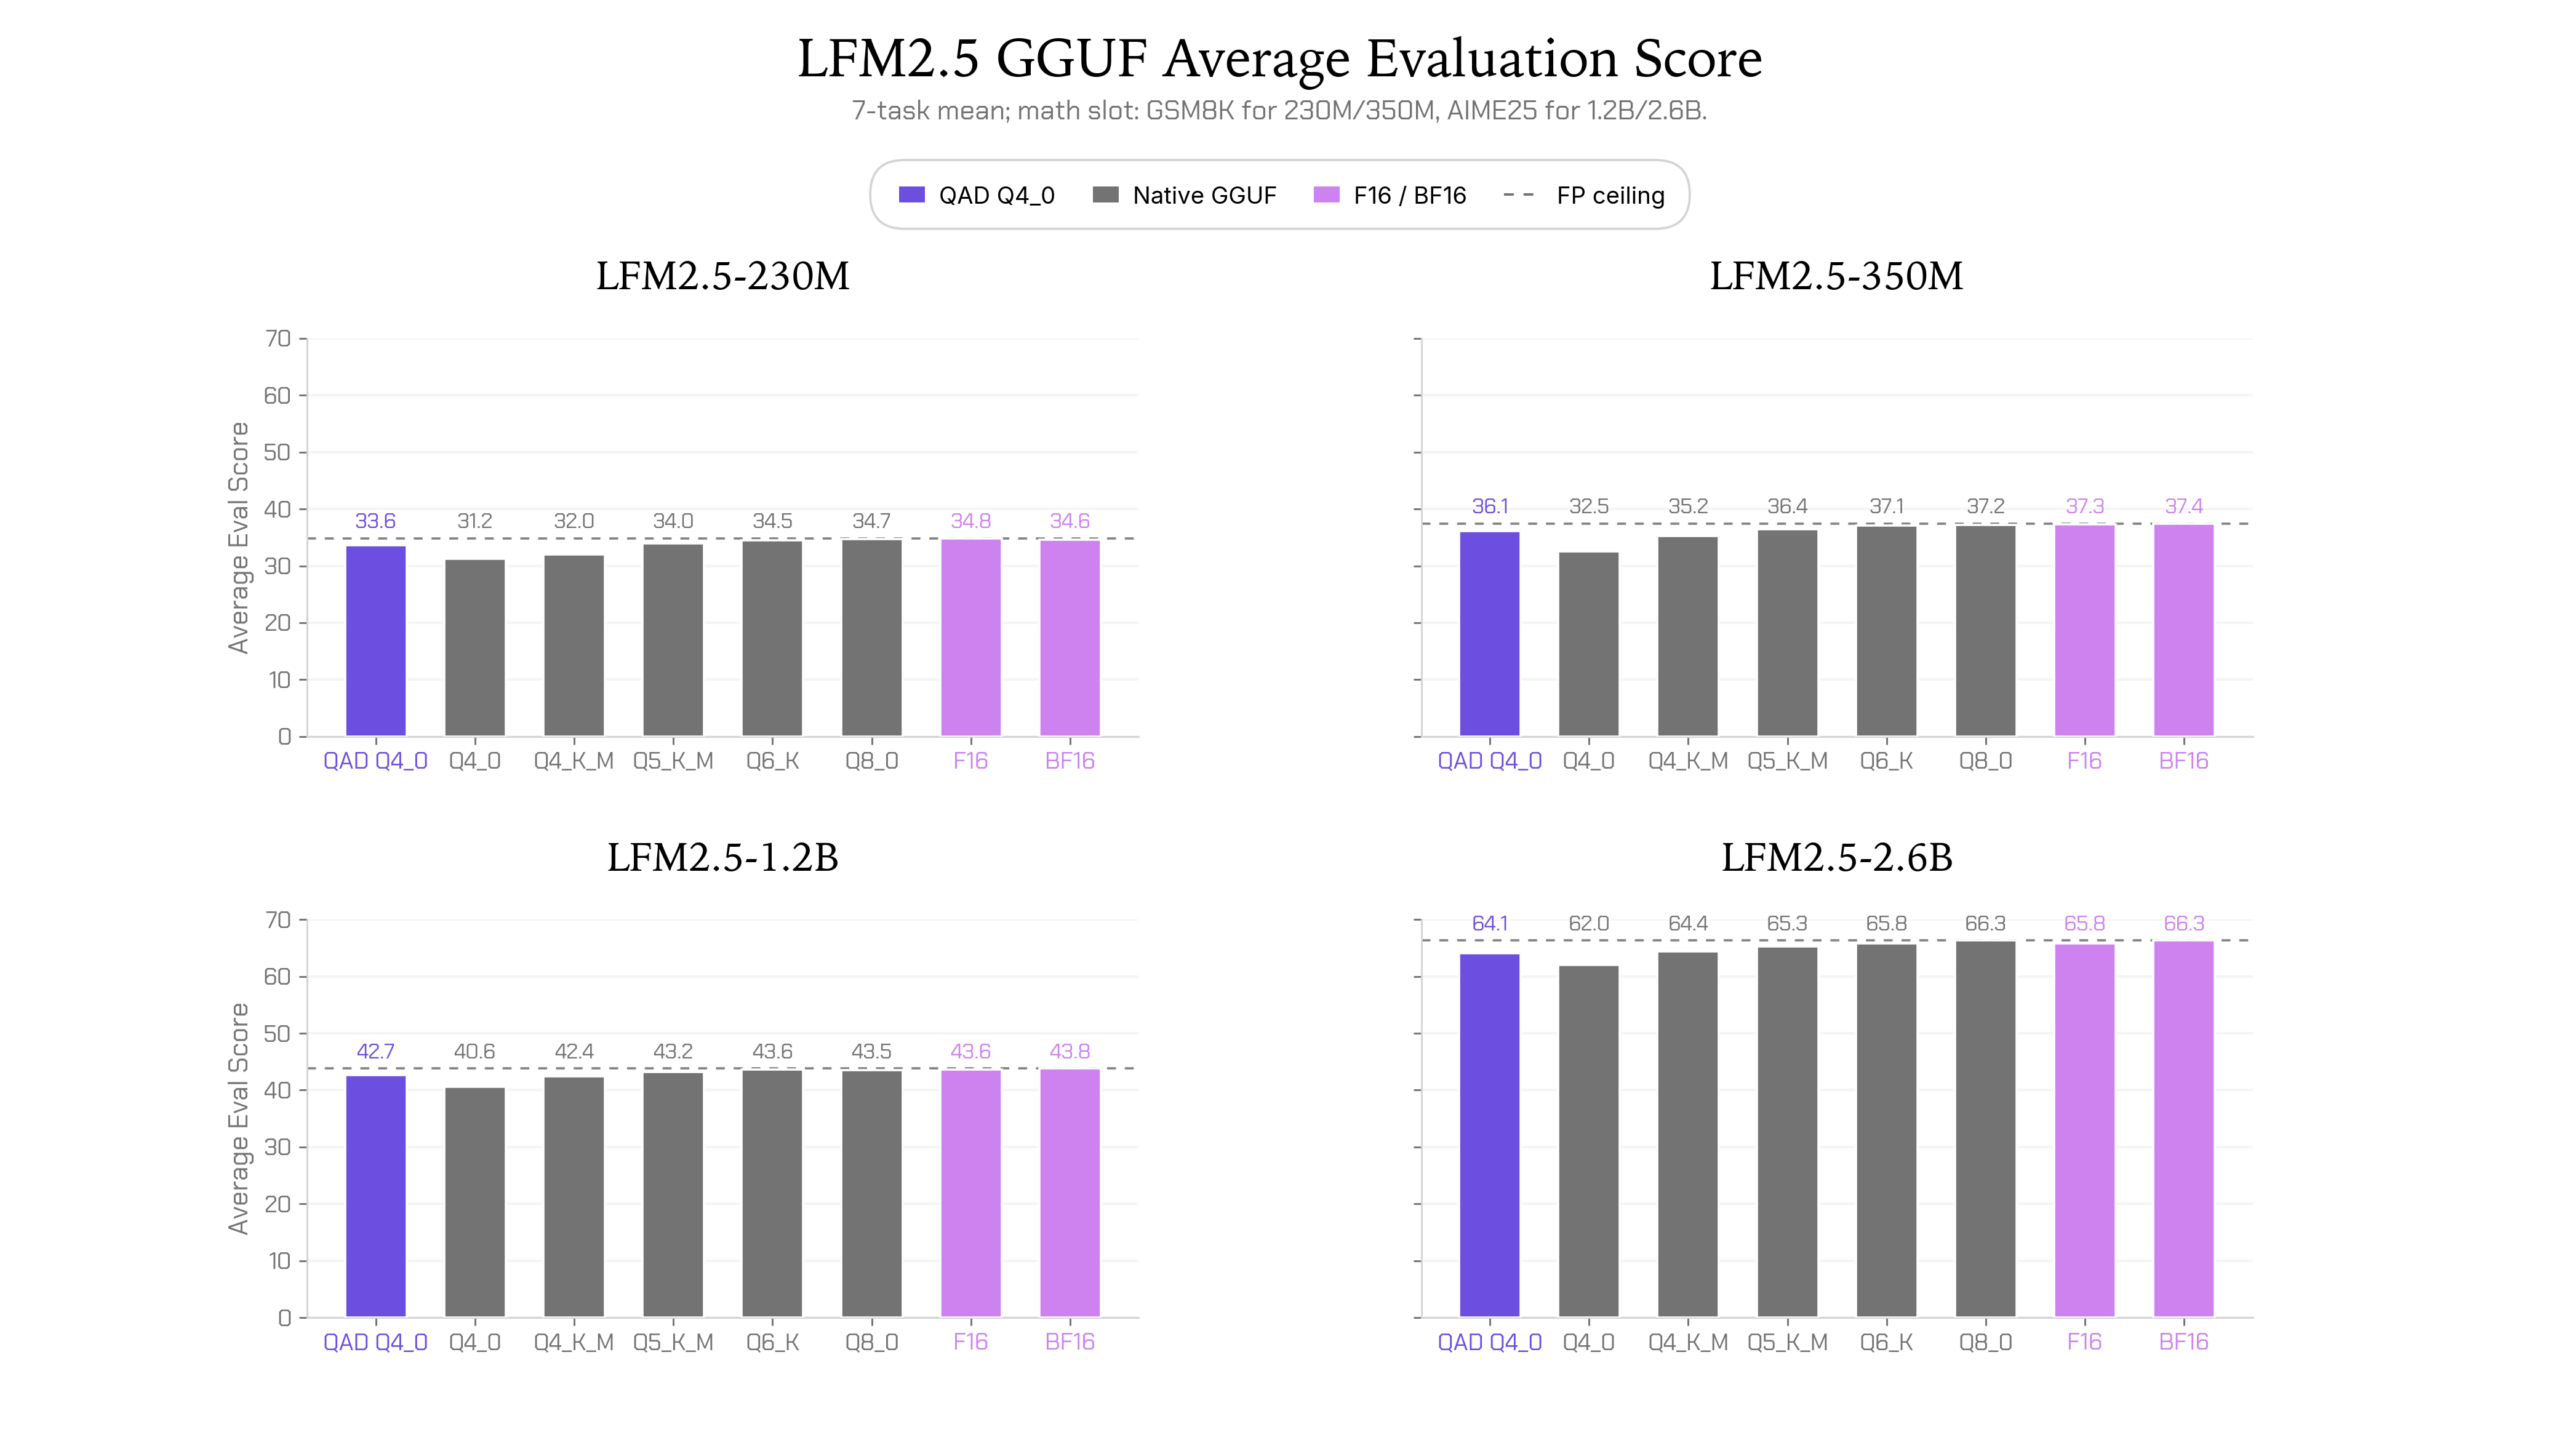
Liquid AI 发布了一套基于量化感知蒸馏(Quantization-Aware Distillation, QAD)训练的 LFM2.5 全系列 Q4_0 GGUF 检查点,覆盖 LFM2.5-230M、LFM2.5-350M、LFM2.5-1.2B-Instruct 和 LFM2.5-2.6B 四个尺寸。核心卖点是:让模型在 Q4_0 的内存占用和解码速度下,接近 BF16 全精度模型的准确率。
传统 Post-Training Quantization(PTQ)压缩到 Q4_0 时准确率损失明显,而 QAD 通过将高精度教师模型蒸馏到量化后的学生模型中,把因量化丢失的准确率恢复了 97%(四个模型分别保留 BF16 基线的 97.1%、96.5%、97.4% 和 96.6%)。
在真实硬件上的评测覆盖了 MacBook Pro、NucBox EVO-X2、Samsung Galaxy S26 Ultra 和 Raspberry Pi 5 四个目标平台,测试基准包括 GPQA Diamond、MMLU-Pro、IFEval、IFBench、Multi-IF 和 BFCLv4,并为不同规模模型补充了 GSM8K 和 AIME25。在解码速度方面,230M 和 350M 模型在解码吞吐量提升4%-33% 的同时,质量超越了 Q5_K_M(在其精度区间内);1.2B 和 2.6B 在提升 3%-14% 吞吐量的同时,质量达到 Q4_K_M 水平。这一结果同时也超过了 Unsloth 的 UD-Q4_K_XL(Strong external baseline)。
QAD 检查点可直接配合 llama.cpp 等支持 Q4_0 GGUF 的运行时使用,适合对显存或内存敏感、同时希望保留模型精度的端侧部署场景。这一生成式推理的质量锚点意味着,边缘端的模型落地可能不再需要基于浮点权重进行推演或精度回退。所有检查点已同步公开在 Hugging Face,并以 llama.cpp 命令行或公开 API 形式提供直接调用路径。