当模型持续学习
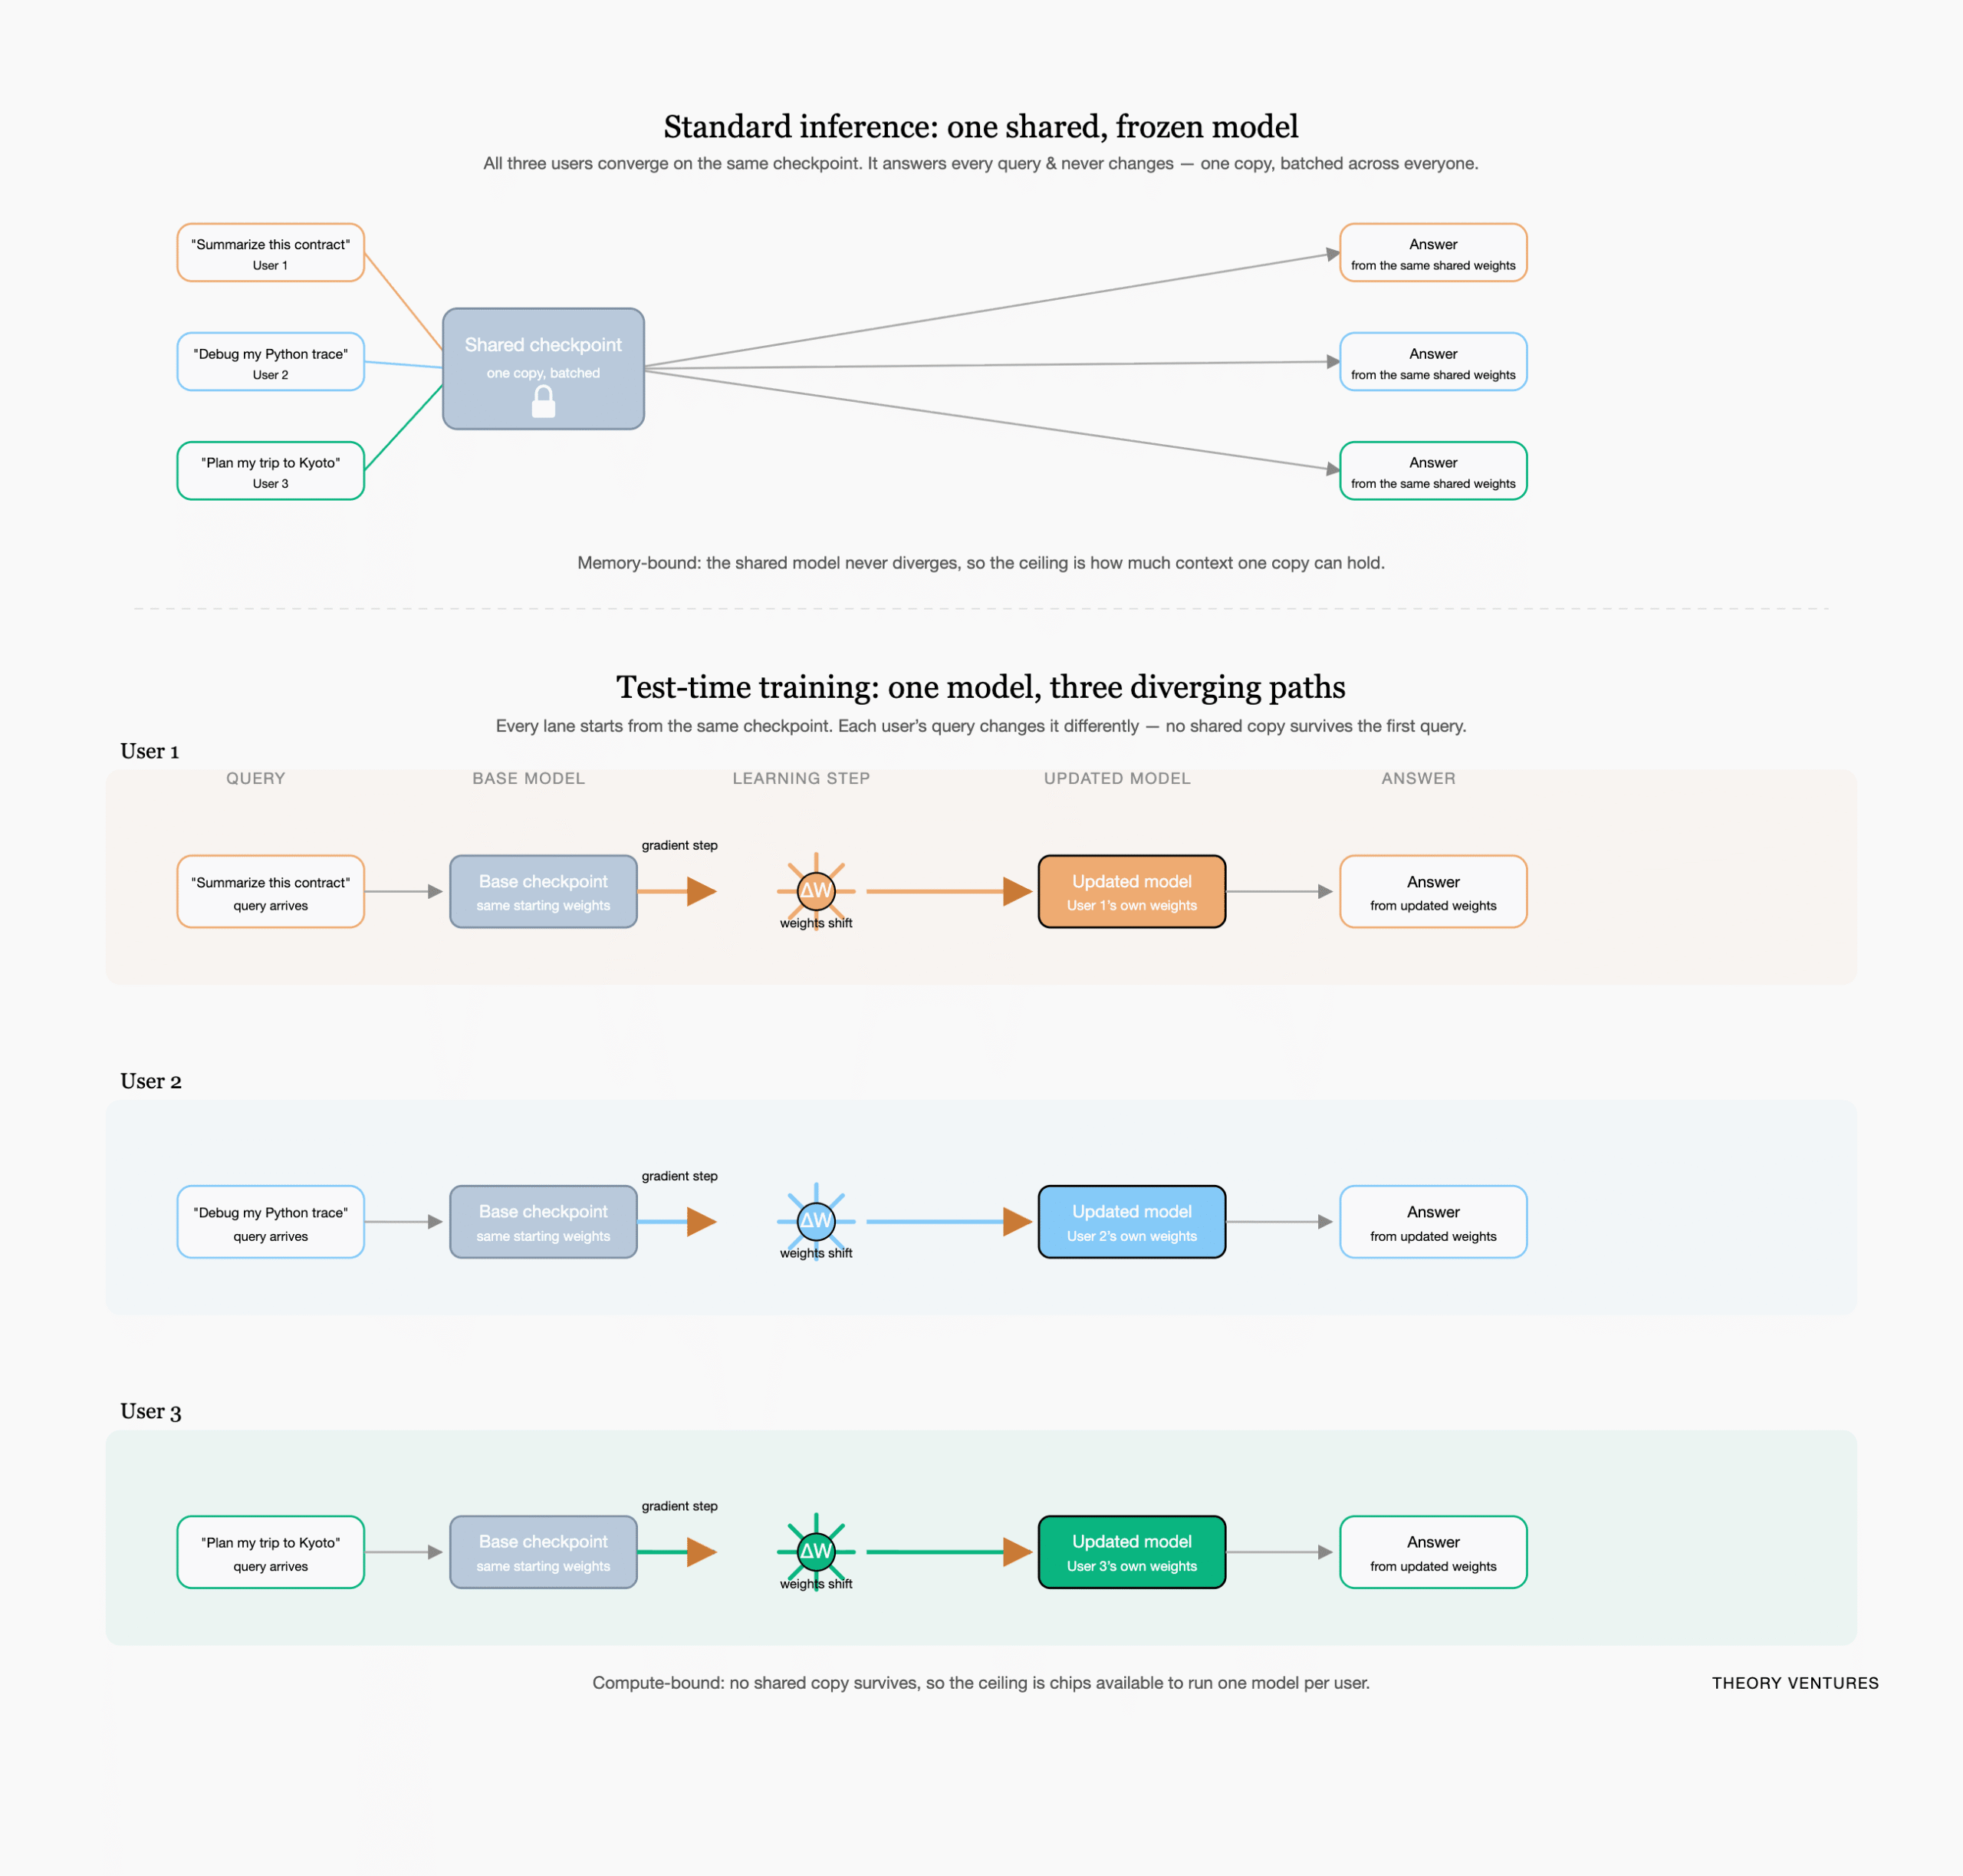
作者用GPS学习日常交通捷径来比喻测试时训练(test-time training):模型在使用过程中对当前prompt进行梯度更新,持续改变自身权重,从而根据用户交互不断适应,而非像传统模型那样在训练结束后就冻结。
这项技术带来三个直接影响。第一,内存需求骤降——标准Transformer依赖KV-cache,内存随上下文长度线性增长;测试时训练将历史信息折叠为固定大小的权重,内存不随对话长度增加。第二,提供商的成本结构改变——每个用户的模型都因个人prompt而分化,意味着GPU提供商需要为每个用户维护一个独立副本而非共享一个,相同用户数下需要更多算力和芯片。第三,推理速度显著提升——Stanford在小模型上的研究显示,测试时训练模型可达2.7倍加速,因为其推理延迟不随上下文长度变化。In-Place TTT方法可直接替换,让4B模型无需重训就达到128k上下文的竞争力。
核心权衡在于:标准AI受内存限制,测试时AI受计算与芯片限制。提供商需根据场景选择——是服务长上下文(测试时训练优势),还是服务海量用户(标准模型更便宜)。
这种成本仅在能产生足够价值时才值得付出。一个编码agent可以学习代码库规范和持久bug,通过记忆形成锁定效应,长期会话能够摊薄每用户成本。而一次性客服查询,共享的冻结模型(或做过微调)就能完美处理,对提供商成本低得多。
测试时训练将成为2026年及以后的关键议题,它有潜力改变当前AI的经济模式。