大多数 AI 工作可以等
构建 AI Agent 团队时,最常见的错误是先选模型再搭架构。顺序应该反过来。模型选择是最后一步,不是第一步。
核心在于路由器(router),一段决定请求由哪个模型层级处理的小代码。把路由器做对,70-80% 的流量可以在本地模型上运行,调用成本几乎为零;或者交给异步模型处理,AI 花费减少 90% 以上。Coinbase 的 Brian Armstrong 上周也提到类似做法:通过更好的默认设置、路由和缓存,在 token 用量指数增长的同时保持 AI 花费持平。
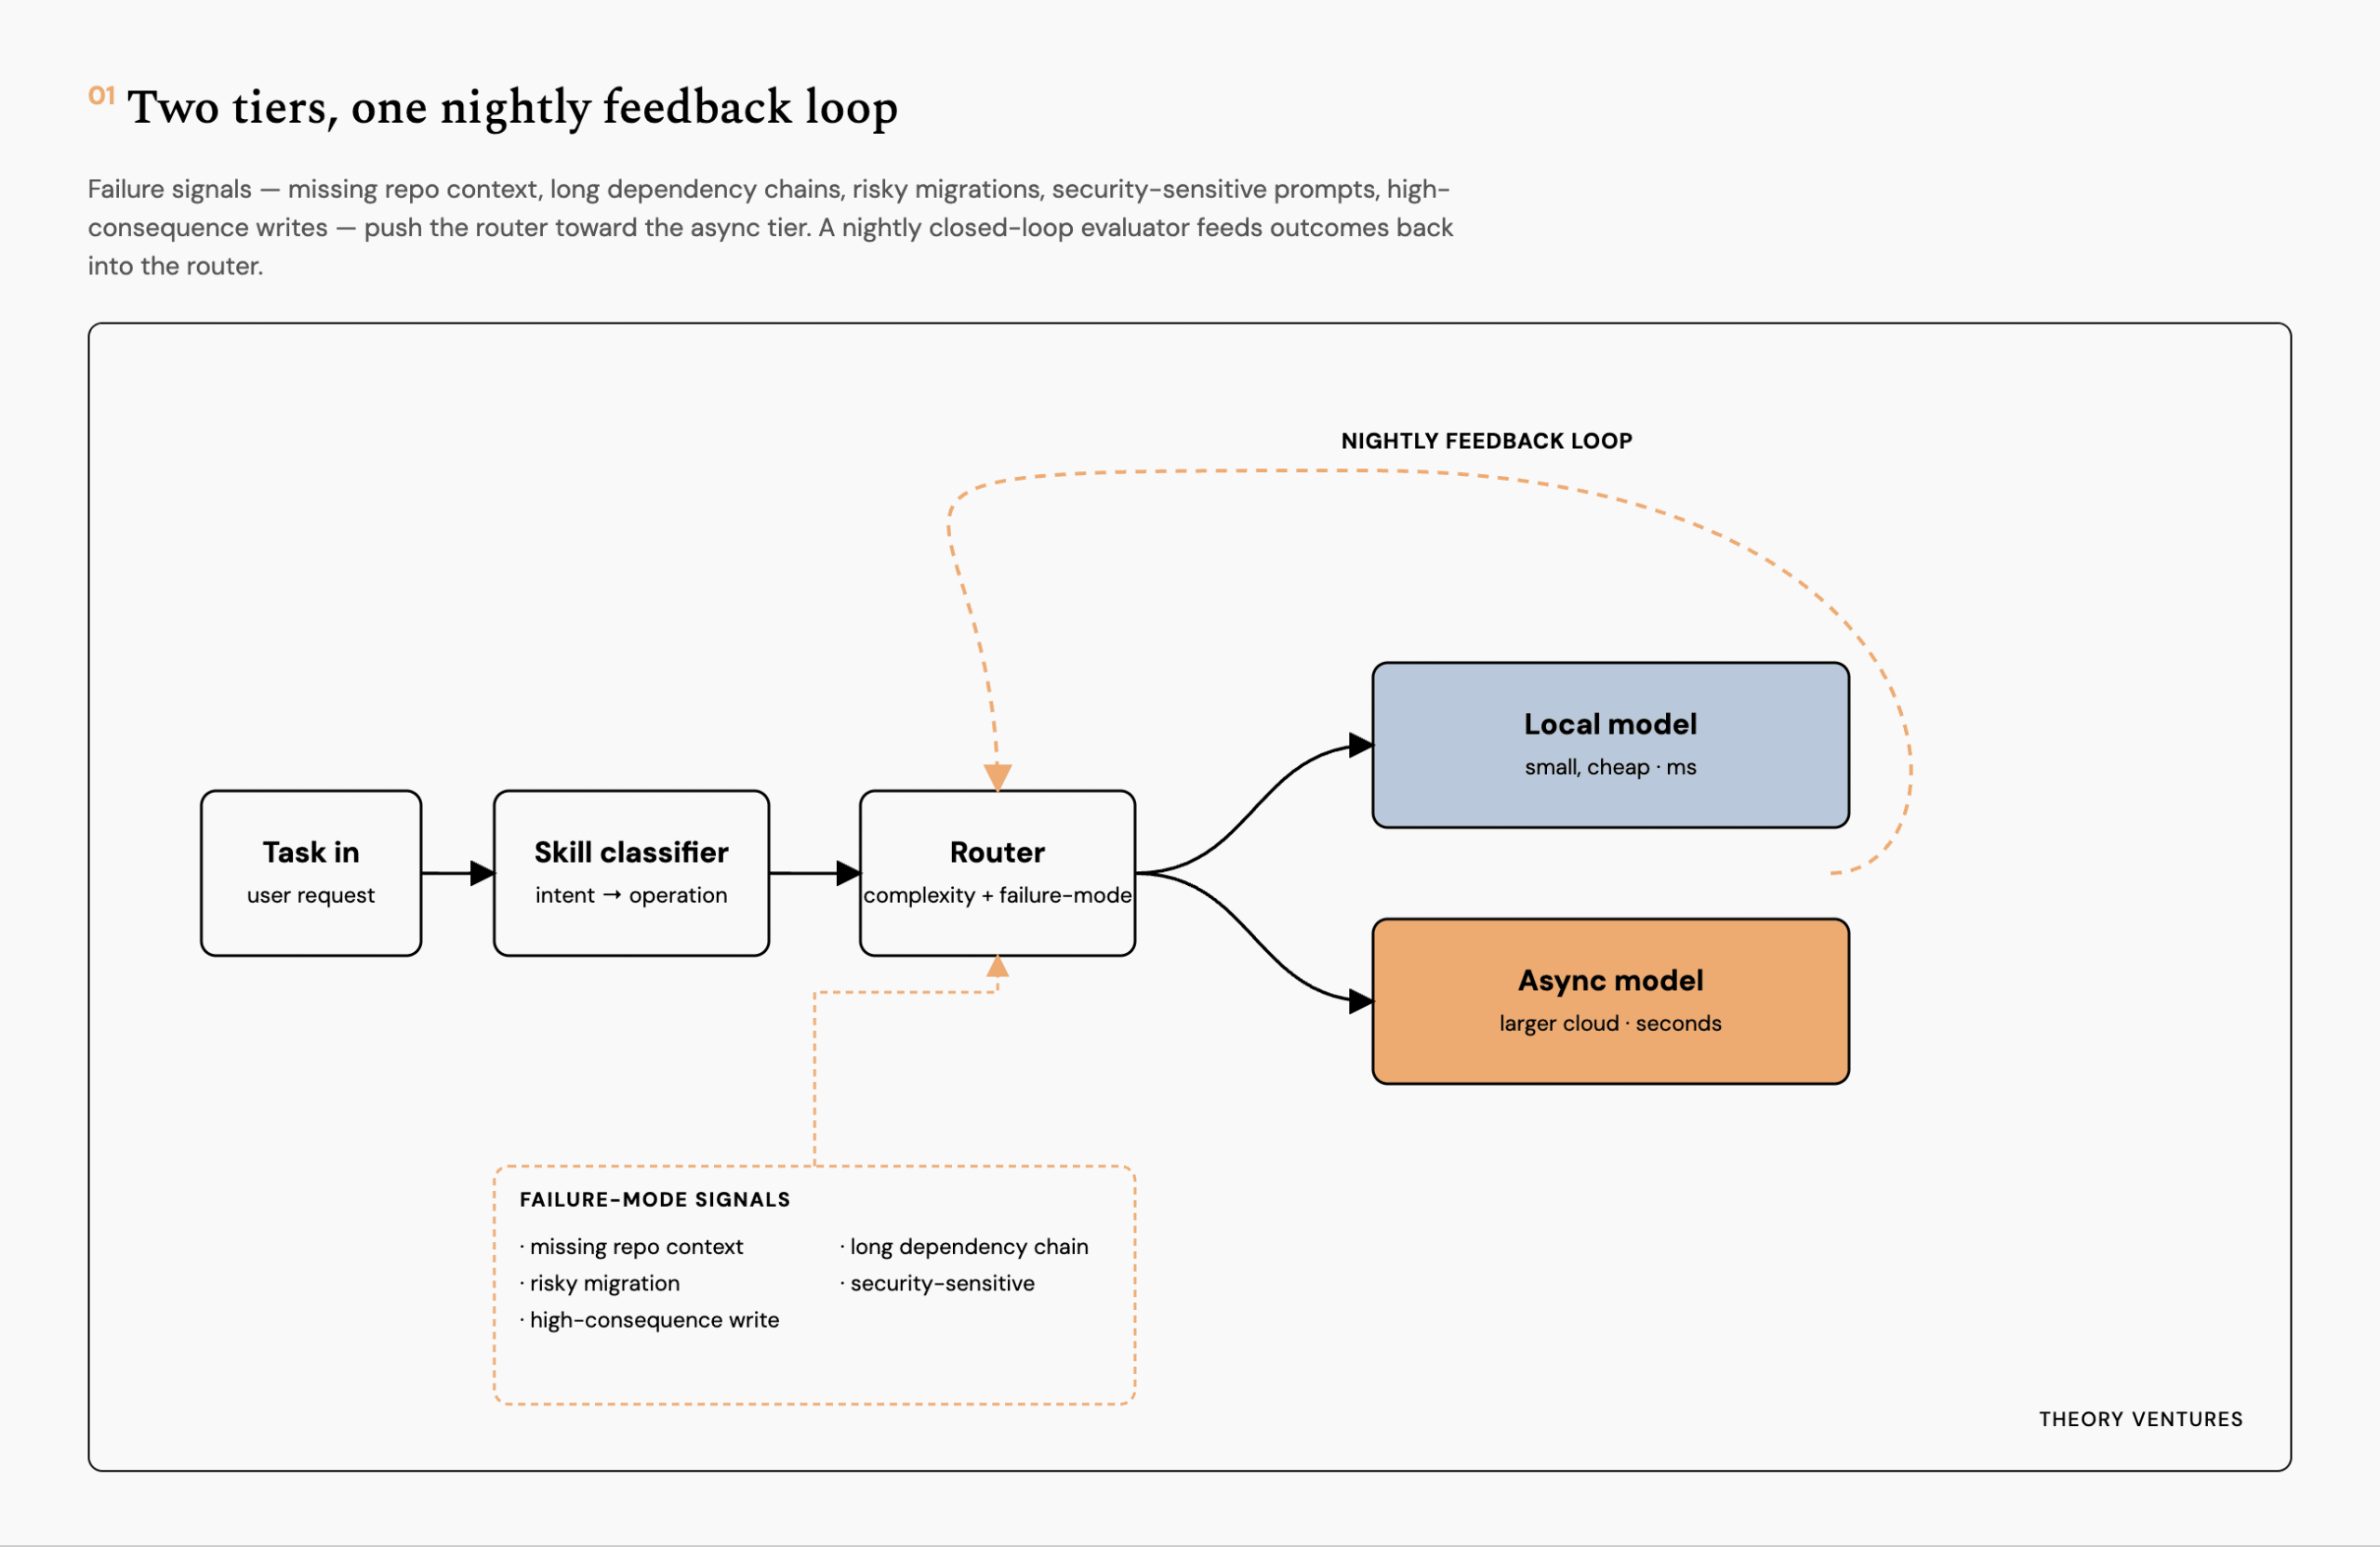
路由问题分三个不同层面。技能分类器(skill classifier)将用户原始请求转化为具体操作,回答的是任务是什么——比如起草回复、总结代码库、运行迁移,本质是意图识别。路由器决定哪个模型层级来执行已分类的操作,它读取的是分类器的标签和几个特征(复杂度、上下文大小、历史成功率),而不是提示词本身。模型选择器(model selector)则在一个层级内挑选最便宜且满足置信阈值的模型。分类器和路由器不是同一件事,前者是语言问题,后者是调度问题,把两者混在一起会把模型选择埋进提示词里,导致无法对同一操作做不同模型的 A/B 测试。
本地计算几乎免费。异步批量推理的成本比实时推理低两个数量级。所以真正的问题更窄:有多少工作需要实时响应?答案是少得惊人,一旦系统可以排队处理。起草回复、总结仓库、尽职调查备忘录、夜间评估器运行——这些都不需要在一秒内返回。
我们把这个功能第一版做进了 Agent 运行时。路由器已经根据复杂度、上下文大小和本地内存检索对任务打分。现在在路由器之上又加了两个反馈机制,运行在不同的时间尺度上。同步故障信号:一个预测器会为每个进来的路由标注五个特征——缺失代码库上下文、长依赖链、高风险迁移、安全敏感提示、高后果写入。夜间闭环反馈:一个批量评估器在夜间对前一天的轨迹评分并更新路由器权重,它在 Sail 上用异步推理跑,评估成本接近零。同步预测器在已知难任务失败前就拦截,夜间循环则发现预测器漏掉的新失败模式。
一旦技能蒸馏(skill distillation)将操作集扁平化,对大多数非编码工作而言,70-80% 的 Agent 流量可以在本地模型上运行。
启示:系统设计应围绕路由,而非围绕模型。模型最后选。