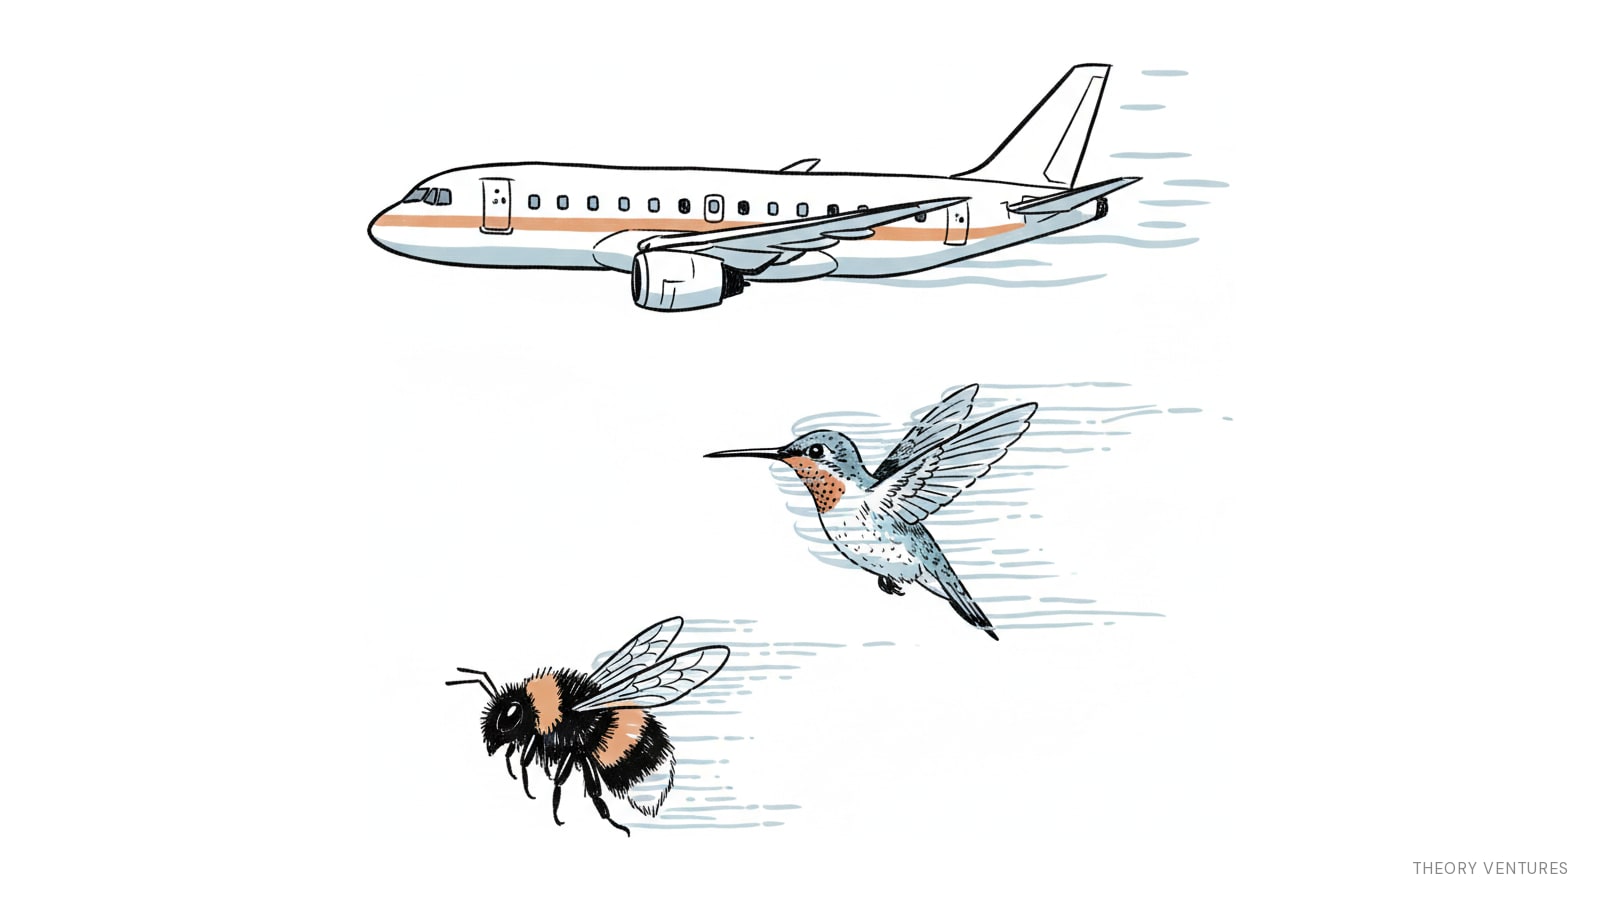
鸟不像飞机那样飞,AI 也一样
这是一个关于本地小模型与云端大模型能力对比的一线观察。作者将跑在笔记本上的 Qwen3.8-27B 与云端旗舰模型进行对比测试,发现前者在 Artificial Analysis 的 Intelligence Index 上得分 52,在 135 个模型中排名第一,甚至超过 Z.ai 的 GLM-5.2(参数量约 753B)。文章借此提出了一个核心观察:小模型与云端大模型在能力上可以平起平坐,但实现路径截然不同。
作者的类比是鸟和飞机——都能飞,但飞行原理不同。大模型靠海量参数存储知识,回答问题像调取记忆;小模型因为存储空间有限,必须依靠更充分的推理来弥补知识储备的不足,从第一性原理出发一步步推导出答案。
文章通过具体的性能测试数据支撑这一观点。在 25 个风险投资类任务(研究创业公司、总结文章、转写播客)中,作者对比了 DeepSeek-V4-Flash 和两个本地小模型:Qwen3.8-27B 与 Qwen3.6-35B。三者在最终答案质量上得分几乎相同(8.0、8.0、7.9分),但在推理过程和速度上差异明显:DeepSeek 仅需 159 个 token 就给出答案,延迟仅 1.1 秒;Qwen3.8-27B 需要 369 个 token 和 7.2 秒;而 Qwen3.6-35B 虽然输出速度极快,但需要思考 1,143 个 token 才能作答,延迟高达 10 秒。
一个引人注目的细节是,在某个任务中,本地小模型花费了 993 个 token 只输出了六个词的回答,这种反复权衡、内部自省的推理方式,与云端大模型的快速反应形成了鲜明对比。
文章的核心洞察在于:AI 推理的路径选择远比想象中多样。性能评测需要从准确率和推理效率两个维度综合考量,AI 开发者在选择模型时,也需要根据自身硬件条件和响应速度要求做出权衡。作者在核心性能保持一贯水准的前提下,通过具体的数据对比,为本地 AI 推理的效率与能力提供了有价值的一手参考。