面向边缘的多模态开源 d1 决策模型
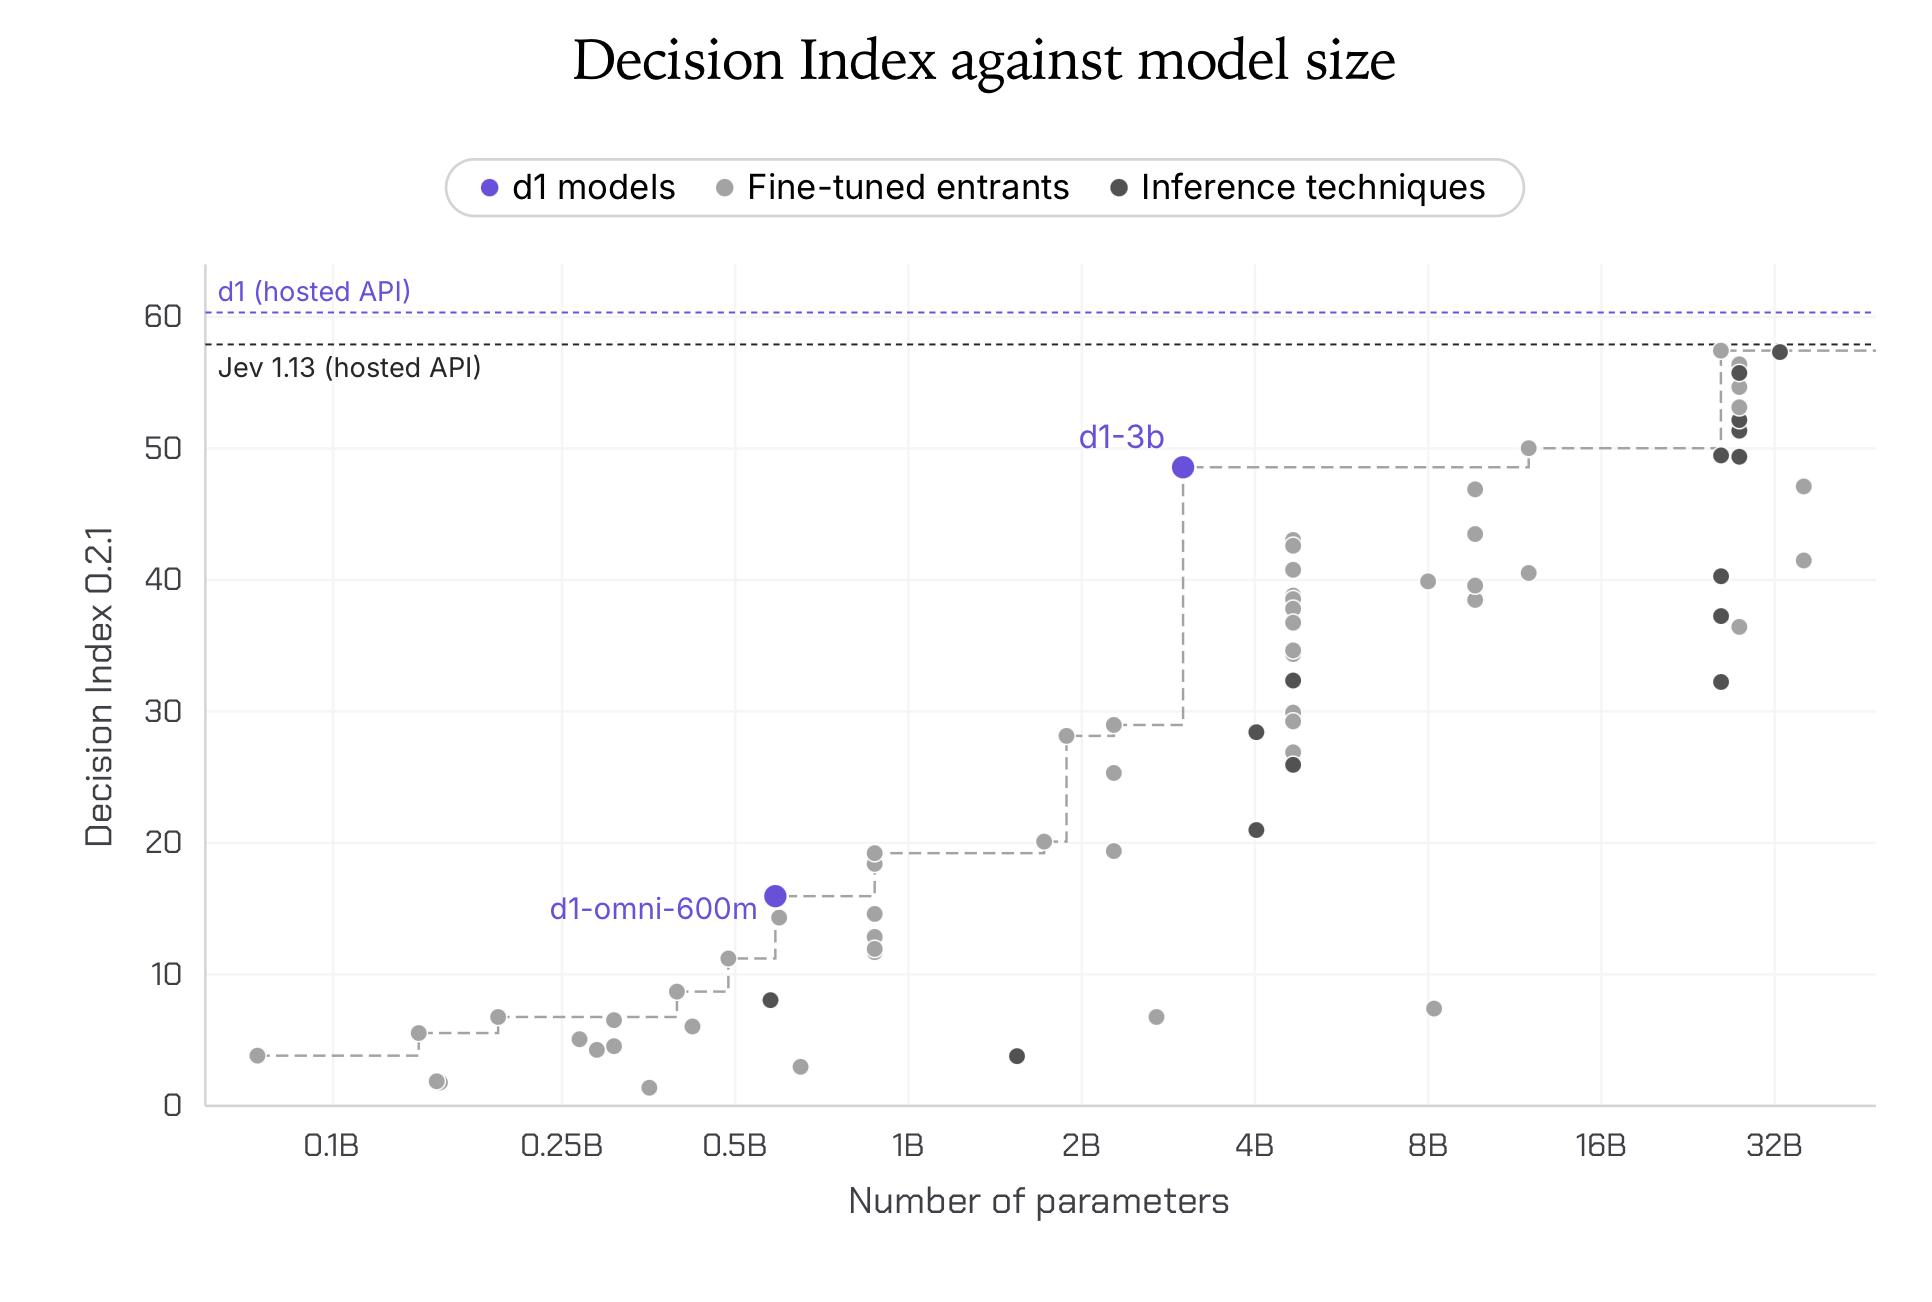
今天 Liquid AI 发布了两款开放决策模型:d1-3B 和 d1-omni-600M(实验性)。在 Decision Index 0.2.1 上,d1-3B 得分 48.57,是 10B 以下最佳决策模型,超过所有 4B、9B 模型,也超过 Decider 35B-A3B 的 47.11。d1-3B 支持文本和图像输入,d1-omni-600M 支持文本+图像或文本+音频。
这两款模型基于 Liquid Foundation Models(LFM)构建。与生成式模型不同,决策模型不产生 token,而是在单次前向传播中直接给出答案。d1-3B 从 LFM2.5-VL-3B(最新 VLM,decoder-only)训练而来,d1-omni-600M 则基于双向编码器 LFM2.5-Encoder-350M,并添加视觉与音频编码器。后者目前是早期研究版本,仍在持续开发中。
基准测试覆盖七个公开数据集,包括阅读理解、毒性检测、意图分类、医学问答和跨语言理解。d1-3B 平均分 82.9,高于 Decider 4B 的 81.1;d1-omni-600M 平均分 78.4,超过 Decider 2B 的 77.1,且参数仅为其四分之一。例如在 SQuAD 2.0 上,d1-3B 得分 83.3,Decider 4B 为 76.0;在 Civil Comments 上,d1-omni-600M 得分 95.8,优于其他对比模型。官方验证 d1-3B 保留其骨干模型 LFM2.5-VL-3B 的视觉能力,d1-omni-600M 可处理三种模态。但未报告视觉和音频基准,因为 Decision Index v0.3 仅包含私有视觉分割,音频决策基准目前是开放问题。
速度方面,与 NVIDIA 合作评测。d1-3B 在 Jetson AGX Thor 上回答单个问题仅需 16 ms,Jetson AGX Orin 64 GB 上 26 ms,Jetson Orin Nano 上 50 ms。三个问题耗时约为单个问题的 1.3 倍,AGX Thor 从 16 ms 增至 20 ms。在 GPU 上,RTX 4090 单问题 8 ms,AMD MI325X 9 ms;处理 384px 图像分别需要 17 ms 和 18 ms。由于 d1-omni-600M 是早期研究版本,本次未报告其速度数据。
使用方式上,需要 transformers>=5.14,通过 trust_remote_code=True 加载模型。模型支持 system_one 接口,可在一个文本状态上同时提出多个命名问题,也支持将整张图片作为状态输入,以及用 system_one_batch 打包多个请求、无填充推理。官方提供了 d1-3B 的示例代码,d1-omni-600M 的运行说明见其模型卡。
两款模型均为开放权重,已在 Hugging Face 上发布。官方还提供了 System One Arcade 演示空间。Liquid AI 建议在需要快速结构化决策、且输入可能包含多模态内容时使用这些模型:d1-3B 在同等尺寸下决策质量最高,d1-omni-600M 适合对体积敏感的场景。


