芯片货架上的价格战
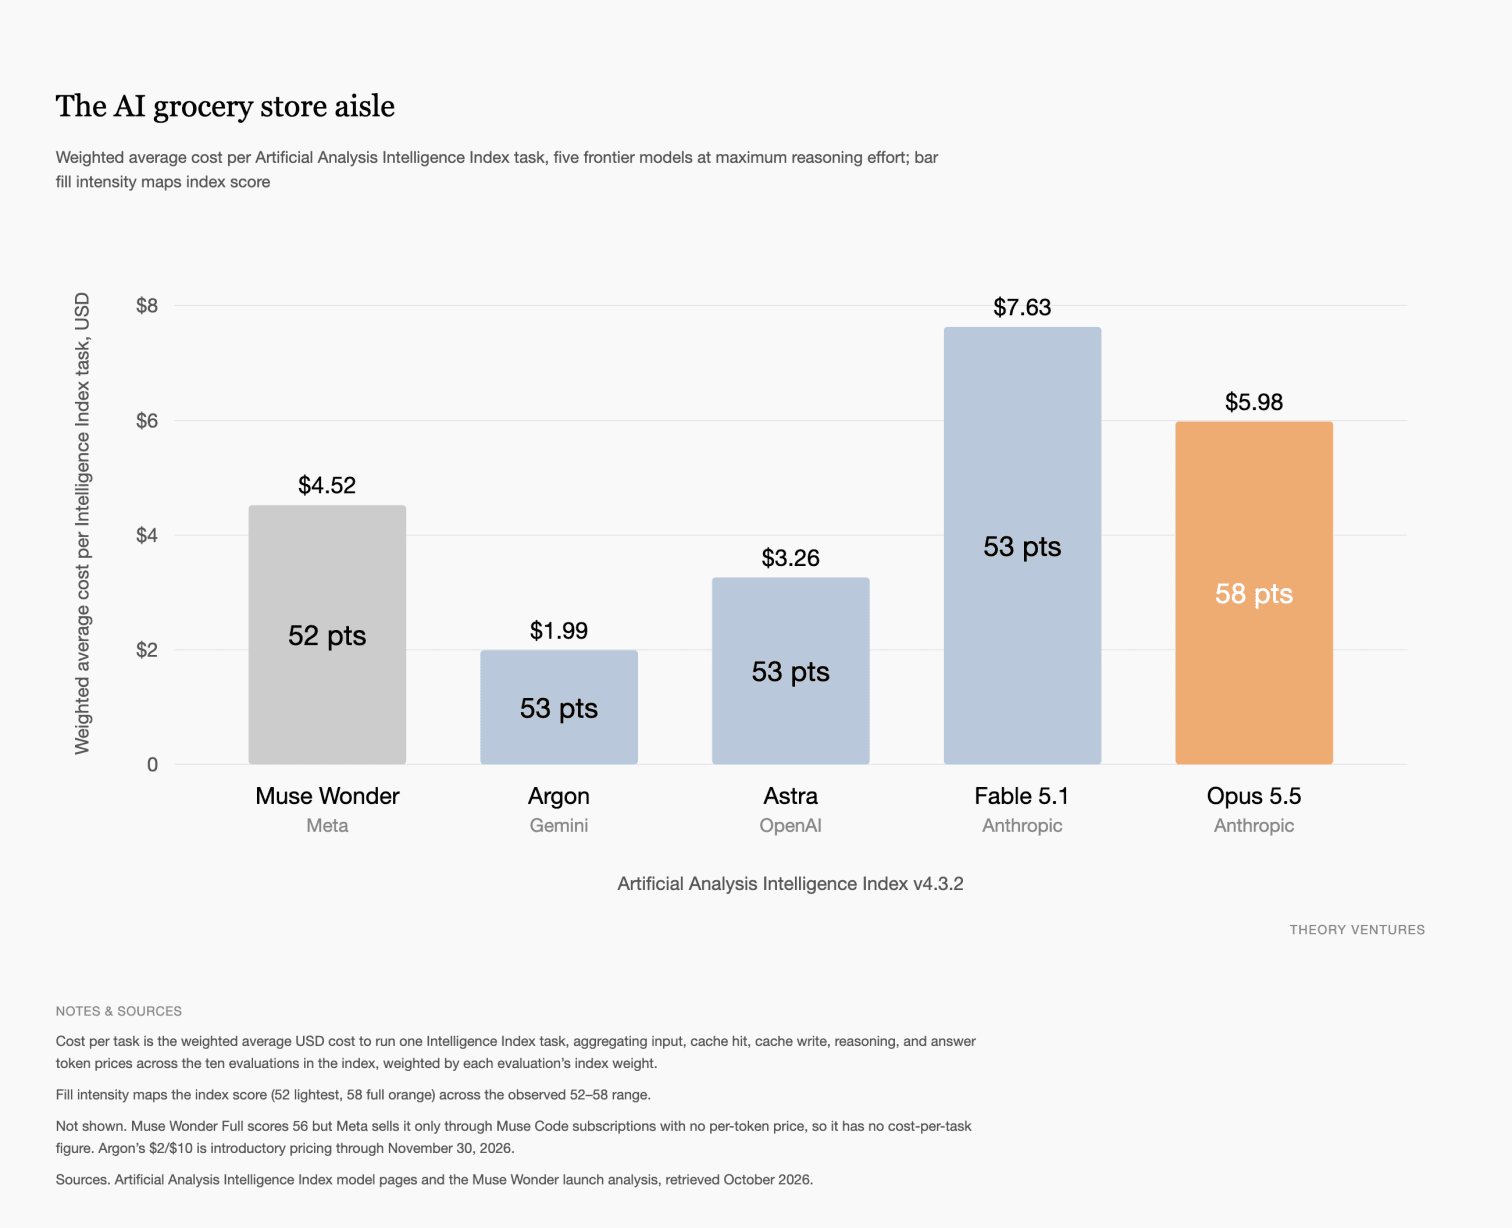
前沿模型的智能差距正在收窄:五个模型彼此只差5分以内,单位成本却差出 3.8倍。Google 的 Argon 位于价格底部,每个任务定价1.99美元,比最贵的 Fable 5.1 低74%,比 Opus 5.5 低67%,比 Muse Wonder 低56%,比 Astra 低39%。
作者借用 Mauboussin 的说法:价格本身包含信息。这组价差不是营销打折,而是模型、架构和 GPU 成本差异的直接体现。Google 比榜单上任何一家都更早把模型和芯片放在一起做,时间超过15年。佐证来自其同行评审的 TPU 论文:第四代 TPU(2023年发布)跑出 A100 的1.2到1.7倍速度,功耗低1.3到1.9倍;按吞吐区间低端、功耗区间中值估算,同等服务成本可以多产出约80%的token。如果这一优势延续到现在,Google 服务 token 的成本可能比同行低 44%,同时利润率并不更差。这也能解释为什么 Google 的数据中心建设规模,和它相对较小的云业务不成比例。
Google 不是唯一一家。凡是买得起定制芯片的实验室,现在都在自己做硅。微软 2026年10月发布 Maia 300,计划下一年开始把 Maia 系列扩到多吉瓦级部署,用于自家产品和服务,并称每瓦token产出比主流GPU系统高40%。OpenAI的第一颗推理芯片 Jalapeño,在 SemiAnalysis 的 InferenceX 测试中,相对 Nvidia GB200/GB300,每瓦吞吐量高1.5到1.9倍,端到端延迟低1.7到3.6倍。SemiAnalysis 的评价是:比吞吐、能效和延迟的组合更优,而且真正该看的标准是每单位功率的性能,不是单芯片性能。
文章据此判断:每瓦智能每六个月翻一倍,token 价格还会继续下降,前沿模型的利润率可以保持在 40%到70%。这场价格战的主战场,已经从模型能力转移到芯片、能效和推理成本。