我们能信任 LLM 判断研究想法的新颖性吗?
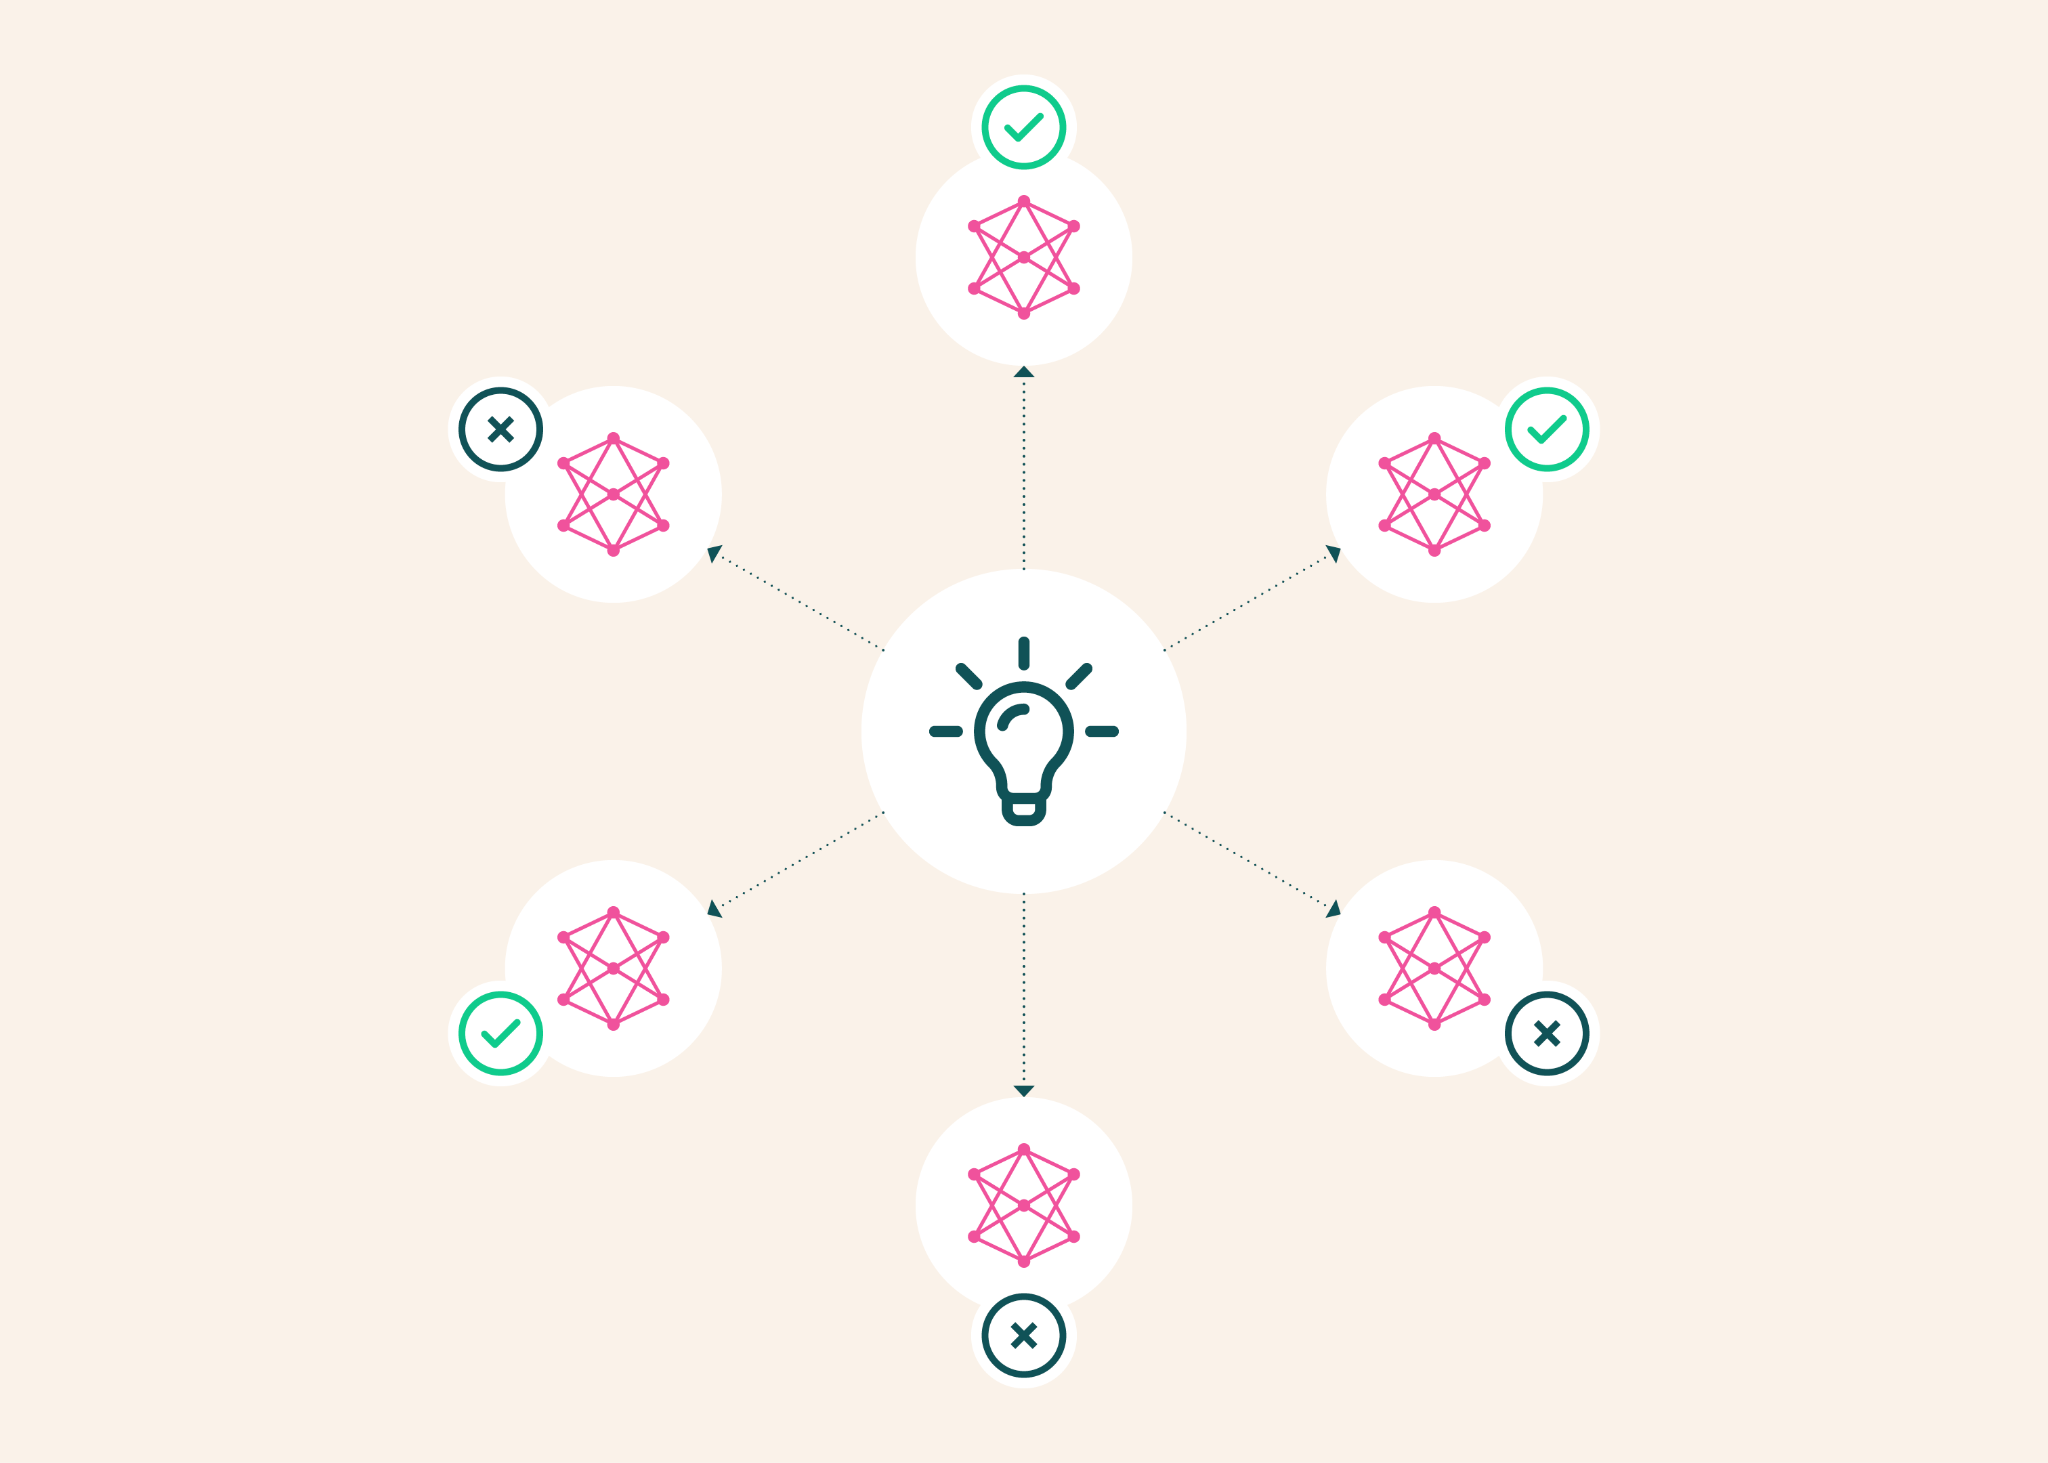
Ai2 发布了一项关于 LLM 能否可靠评估科研想法新颖性的新研究,同时公开了配套基准、数据、代码和自动化构建管道。研究背景是:Ai2 正在开发 DataVoyager、AutoDiscovery、Theorizer 等辅助科学发现的系统,这些系统能生成研究想法,但还需要判断这些想法是否真正新颖。实际中这种判断常交给另一个 LLM(称为 novelty judge),而现有做法没有统一标准,且多在人工撰写的论文上验证,未必适用于评估 AI 生成的想法。
为了系统测试,作者构建了基于 ICLR 2026 同行评审意见的自动化管道。他们没有用论文录用与否作为新颖性代理,而是从评审文本中挖掘明确讨论原创性的段落。高新颖性池包含 154 个人工撰写的想法,来自各自研究领域评分前 10% 且评审明确认可其新颖性的录用论文;低新颖性池包含 145 个来自评分后 10%、评审提出原创性担忧且无人认可新颖性的被拒论文。在对评审挖掘过程的抽查中,标注者在 50 个案例里有 47 个与提取的新颖性信号方向一致,且没有一例分歧会改变评审者是否被计入赞扬或质疑。这两个池构成 Human-Only 设置。
另一个设置 Human+Generated 将同样的 154 个人工想法与 154 个简单 LLM 生成的想法配对。生成器只收到研究领域和提出新颖想法的指令,没有文献检索、工具或迭代,因此假设生成想法新颖性较低。为排除写作风格干扰,作者将人工和 AI 想法重写成统一结构;专家独立审查了 30 对(侧重最强判断器出错的案例),全部 30 对中专家都更偏好人工想法,且不认为任何生成想法新颖。
六个 LLM 判断器(GPT-5.1、GPT-5.2、GPT-5.4、Claude Sonnet 4.5、Claude Opus 4.5、Claude Opus 4.6)被用来做逐点和成对新颖性比较。最大波动来自提示词设置:同一组 Human+Generated 对,GPT-5.4 在一种提示下准确率 93.5%,换成更简单提示后掉到 40.9%,低于随机水平,且超过一半的判定发生改变。同样的提示变化在 Human-Only 上只让准确率移动约 7 个百分点,但人工想法也不是完全稳定——Claude Opus 4.6 在同一变化下准确率移动 21 个点。不存在普遍更优的提示词:某些指令对有的模型有帮助,对另一些反而有害。
检索和更多推理也没有稳定改善判断。带高推理预算和实时 arXiv 搜索的 agentic judge 在 Human+Generated 上 macro-F1 为 0.78,比 Claude Opus 4.6 的 0.89 低 11 个点,成本却高出约 10 倍。两个专用评估系统同样不占优:简单的 Claude Opus 4.6 低推理 + 三次调用多数投票获得 0.854 macro-F1,总成本 $2.59;而 ICLR 2026 命名之外的 Idea Novelty Checker(文献检索重排管道)得 0.642、成本 $30.66;Sakana AI 的 AI Scientist (基于 Semantic Scholar 迭代检索)得 0.772、成本 $82.05。也就是说,简单提示基线在准确率和成本两方面都胜出。
研究结论是:LLM 新颖性评估仍是重大开放问题。在人工研究上看似可靠的判断器,面对 AI 生成想法可能表现完全不同;同一个提示对不同模型效果不一;更多搜索和计算未必带来更一致的判断。作者提出未来应在其实际使用的想法类型上测试判断器、测量跨提示和模型的敏感性、改进对已有文献的利用,并构建能随文献增长演进的基准。本次发布的管道可供其他科研社区和后续判断器复用。