嵌入式AI评估不是简单解法,Hugging Face政策官这样说
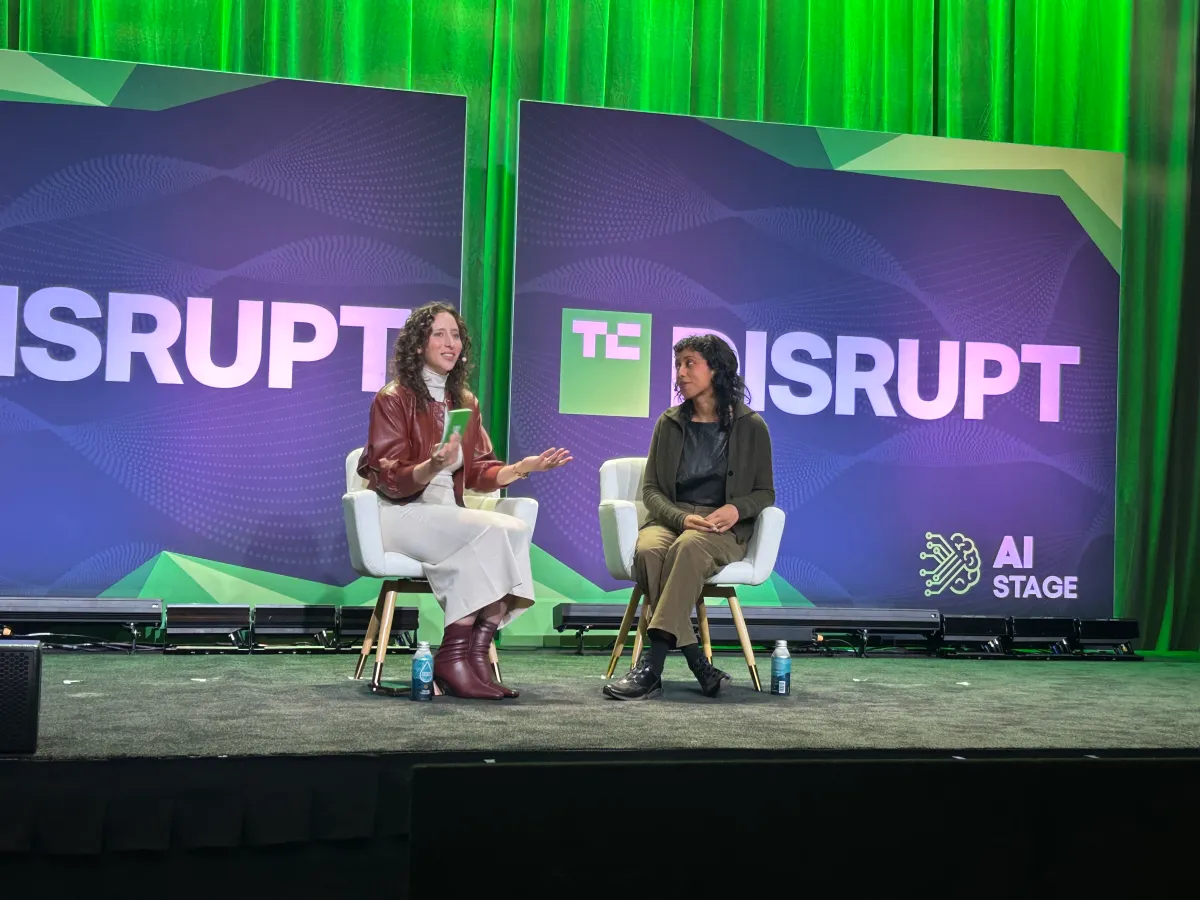
AI 实验室把声誉押在模型基准测试上,指望它是中立、准确的衡量工具。但 Hugging Face 首席政策官 Irene Solaiman 在 TechCrunch Disrupt 上表示,这些评估背后的方法仍然复杂且不成熟,行业需要把它们整合成一门更一致的科学,才有资格被依赖。
她首先回应了“能否信任当前测试”的问题:“信任是个很重的词。”在她看来,关键之一是评估结果是否可复现,以及你是否拥有接触模型本身所需的权限——这正是开放权重(open weights)发挥作用的地方。模型评估的可复现性一直是基准测试中最棘手的问题,业内至今争论不休。
除了单个测试本身的有效性,另一个问题是测试之间如何比较。Solaiman 说,评估是一门仍在演变的科学,目前还不知道如何有意义地互相比较。它们会在相对较短的时间内失效,而行业也没有足够健康的生态系统来支撑。这直接引出了当下流行的“嵌入式评估者”(embedded evaluators)——把所谓中立的第三方观察者放进 AI 机构内部。她指出,业界对嵌入式评估者生态系统有强烈需求,但决定谁在哪些任务上能成为有效评估者的资质,还需要大量标准化。
嵌入式评估者在过去几个月逐渐流行,背景是 AI 实验室接连出现安全事故,引发了对技术潜在危害的担忧。Anthropic 聘请 Accenture 作为其首个评估者,招致不少批评,一些人嘲笑这家咨询公司是否真有资格胜任。
Solaiman 还提到,评估正从单纯测试模型本身,转向测试模型周围的整个系统,包括 harness(访问模型的工具)和 agent。一个较弱的模型配上更好的 harness,很可能超过前沿模型的表现。Agentic 评估“很难,而且非常贵”。目前行业对模型的评估相对较多,但对 harness 的评估很少,而针对整体 agent 的评估也正在开发中——因为这才是许多人实际获得价值的地方。
归根结底,评估领域眼下有点“各自为战”。如果基准测试要继续被视为有用的工具,行业需要一种更统一的方法,让所有人站在同一页上。


