将知识蒸馏成本降至可规模化运行
知识蒸馏是从大教师模型训练小学生的常见做法。开源大模型变大后,部署很贵,例如 Kimi-K3 有 2.8 万亿参数,仅加载就需要约 3TB VRAM,因此把大模型压成小模型再蒸馏恢复能力,成了 Nvidia(Nemotron 3 Puzzle 75B)和 Multiverse Computing(Hypernova 60B)等公司都在用的路线。蒸馏环节几乎决定最终质量,但它通常是全流程最贵的一步:同时在线加载师生两个模型,并为每个 token 生成覆盖整个词表的概率分布,需要几百张 GPU 和精细的并行策略。
Multiverse Computing 在最新论文《Efficient Knowledge Distillation for LLMs: Offline Top-K Logits and a Fused Chunked KL Loss》里提出两个系统级改动。第一,离线蒸馏:教师模型只跑一次,每位置缓存 top-100 最可能 token 的 logits,训练学生时不再加载教师,缓存还可以被多次消融实验复用。第二,融合分块 KL 损失:默认 KL 实现会先构建一个“词表长度 × 序列长度”的巨大稠密网格,再计算标量损失;新实现逐块计算,把模型输出投影直接融进损失里,前向和反向都只保留一个 chunk,因此峰值显存随序列长度近似线性增长,而不是被全词表矩阵推高。代价是输出投影要算两次,但显存收益远大于这点额外计算。
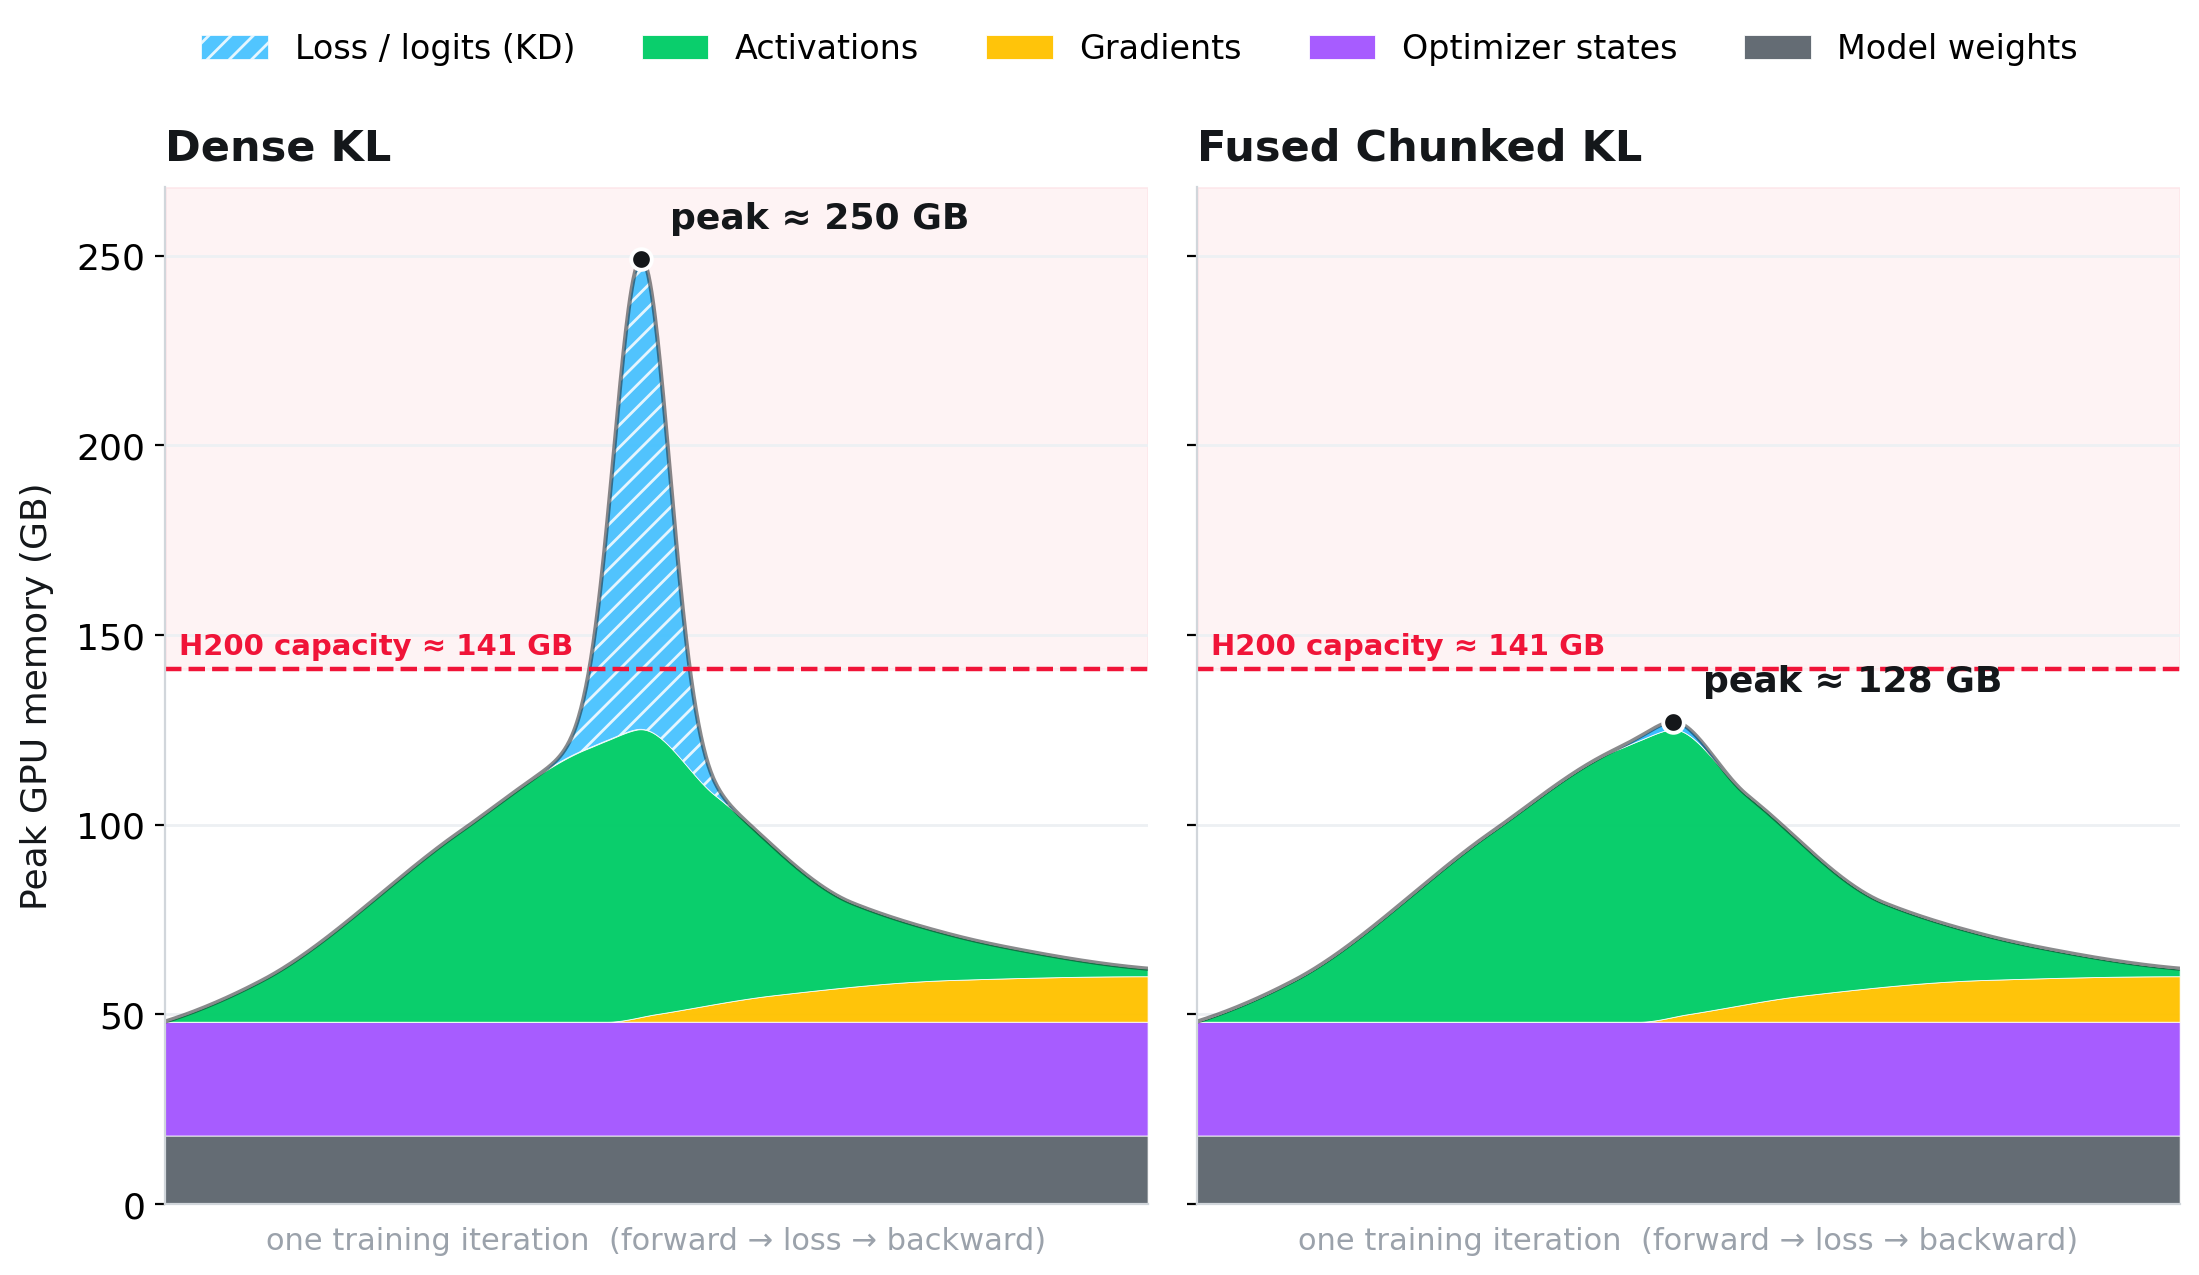
直观来说,标准在线蒸馏在 gpt-oss-120b 场景下(词表 201,088,序列长 32K,batch 4)单个教师概率张量就约 50GB,一次迭代峰值约 250GB,超过单张 H200 的 141GB;新方法的 fused chunked loss 不形成这个尖峰,峰值约 128GB。在单张 H200、Llama 3.1 8B 教师蒸馏 3.2B 学生、8K 上下文的实测中,四种设置(在线、dense、forward-chunked、fused)的训练损失曲线几乎重合,说明只缓存 top-100 logits 的离线蒸馏相对在线蒸馏基本无损;峰值显存从在线蒸馏的 102.8GB 降到 fused 的 58.3GB,单步时间从 25.9 秒降到 20.2 秒。不过在 8K 下 fused 还不是最快的,forward-chunked 更快一些,这正是因为 fused 多做了一次反向投影。
融合分块损失的优势在长上下文下更明显。在玩具输出投影网络的隔离基准里,32K 长度下峰值显存从 dense 的 85.2GiB 降到全分块版的 5.45GiB,降幅 15.6×;dense 在 64K 后直接失败,256K 时全分块版只用 11.6GiB,而次优变体要 134.2GiB,每步还快约 3.3×。用 GPT-OSS 20B 在 32,768 token 上下文做蒸馏时,fused 损失释放的显存把整个训练从 4 个 GPU 节点缩到 1 个,单步时间从 57.0 秒降到 12.23 秒(约 5×),每 GPU 吞吐从 74.2 升到 345.7 TFLOP/s。
这套离线方案最终让一次大规模蒸馏实验变便宜了。作者用 Llama 3.1 8B Instruct 蒸馏出约 3.2B 参数的学生,BoolQ 和 HellaSwag 上保留教师大部分准确率,MMLU 差约 9 分,参数不到教师一半。相关工作已开源:github.com/CompactifAI/Full-Chunked-KL-Loss。论文还包含更多消融实验,比如损失函数选择和序列打包对恢复质量的影响。