存储桶加代理,无需NCCL:HF Jobs上的异步GRPO与LoRA
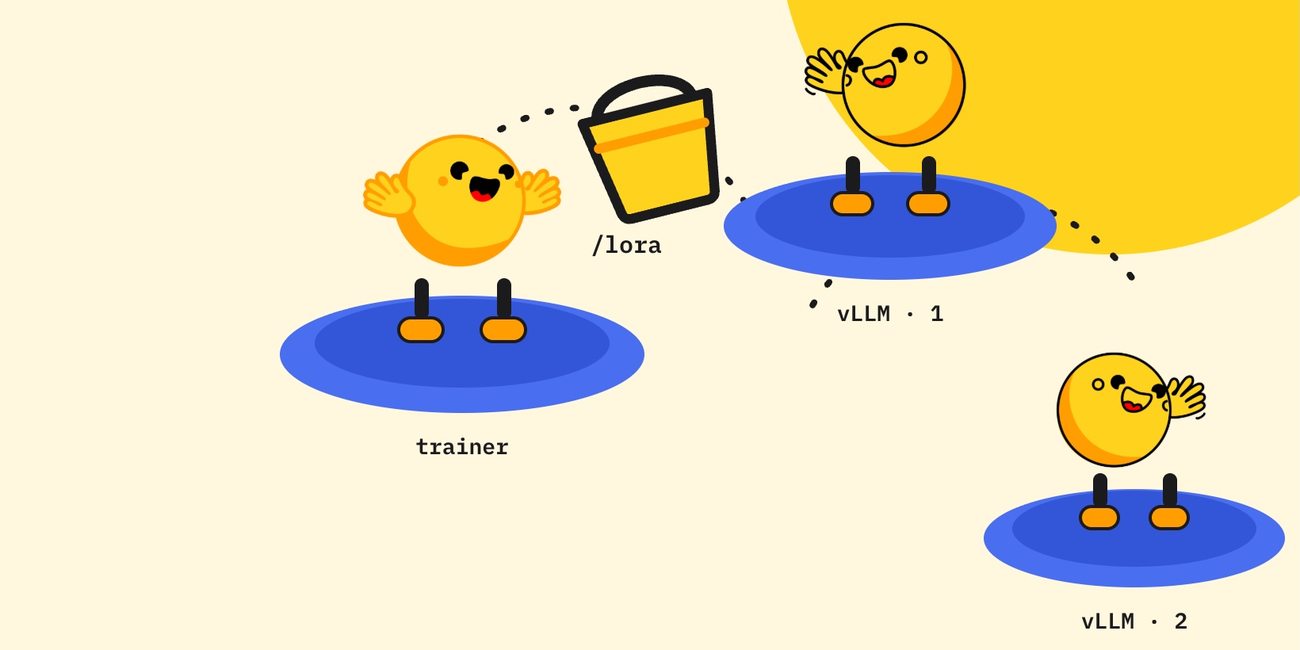
这篇文章记录了 AsyncGRPOTrainer 的一个真实部署:训练用 LoRA 适配器,同步时只传适配器,不传全量模型。rank-1 适配器只有几 MB,通过 Storage Bucket 挂载到每个 HF Job 就能传递,完全不需要 NCCL。训练器和 vLLM 副本跑在不同的 Hugging Face Jobs 上,不再共享机器。
核心架构是三份 Job 加一个代理:一个训练器 Job 用 AsyncGRPOTrainer 训练 LoRA,两个 vLLM Job 各自服务基础模型和最新适配器,一个 Storage Bucket 挂载到三个 Job 的同一路径,充当共享文件系统。训练器每几个优化步保存一次适配器到目录,原子重命名后向 vLLM 发 /v1/load_lora_adapter 请求,vLLM 直接从磁盘加载,训练器不传张量。代理放在训练器本地,负责两件事:加上认证头,以及把每个 rollout 路由到最可能持有其 KV 前缀缓存的副本。路由用 16-token 块的链式哈希,哈希种子包含适配器名,确保不同策略版本的缓存不会复用。公共前缀(例如 chat 模板)通过扇出检测排除,不参与亲和性判断。适配器加载采用全副本 all-or-nothing 广播,失败时只重试桶挂载未跟上的一路,其他错误则回滚已加载的副本。
作者用 sail/Sanity-Test-R1D-1.5B 数据集验证。配方是 Qwen2.5-Math-1.5B、LoRA rank 1 alpha 2、lr 4e-5、每步 128 个 completions、跑 500 步。初始配置的问题很清楚:训练器是瓶颈,前向+反向占 step 时间的 96%,MFU 只有 3.9%,两个 vLLM 副本大部分时间闲置。随后四轮调整:用 token_budget 打包把 samples_per_row 从 1 提到约 12.7,step 时间从 22.9s 降到 5.9s;关闭 gradient_checkpointing 让前向+反向从 5.6s 降到 4.6s;加第三个副本后没效果,原因是客户端 max_inflight_tasks=128 卡住了并发;最后把 in-flight 提到 384,队列上限提到 768。最终 500 步从 3 小时 27 分钟缩短到 53 分钟,端到端 3.9 倍加速,训练样本数从 64,000 增至 84,078,reward 曲线基本重合(首 20 步均值 0.145,末 20 步均值 0.416–0.438),ratio 全程贴近 1.000。252 次适配器加载全部成功。
文章强调一个工程要点:优化流水线不能只看单段,慢的下游会掩盖上游的真实能力。每一步都用带时序的 dashboard 指标定位瓶颈(rollout_wait 和 backpressure 此消彼长)。还给出了可复现命令和完整参数。需要注意 vLLM 必须固定 v0.27.1,因为相关标志和运行时 LoRA 端点由该版本提供;代理在当前规模下用 Python asyncio 没问题,更大流量时需要考虑更快的实现。