两个月后:如何像产品一样发布 Google Agent Skills
Google Agent Skills 仓库在两个月后从 15,000 GitHub stars 涨到 21,000,现在容纳 170 多个来自 Google 各团队的技能。作者延续上一篇的幕后话题,公开了当前仓库的自动化质量门禁、AI 审查代理,以及从提交历史里总结出的四条可直接迁移的教训。
核心思路是:技能是活产品,不是一次性文档。技能会直接影响 Agent 的推理循环、工具选择和执行路径,一句措辞可能让 Agent 传入非法参数、陷入死循环或浪费 token,所以任何指令编辑都算行为变更。这驱动了三个硬要求:严格语义化版本、确定性自动校验、强制评估证据。
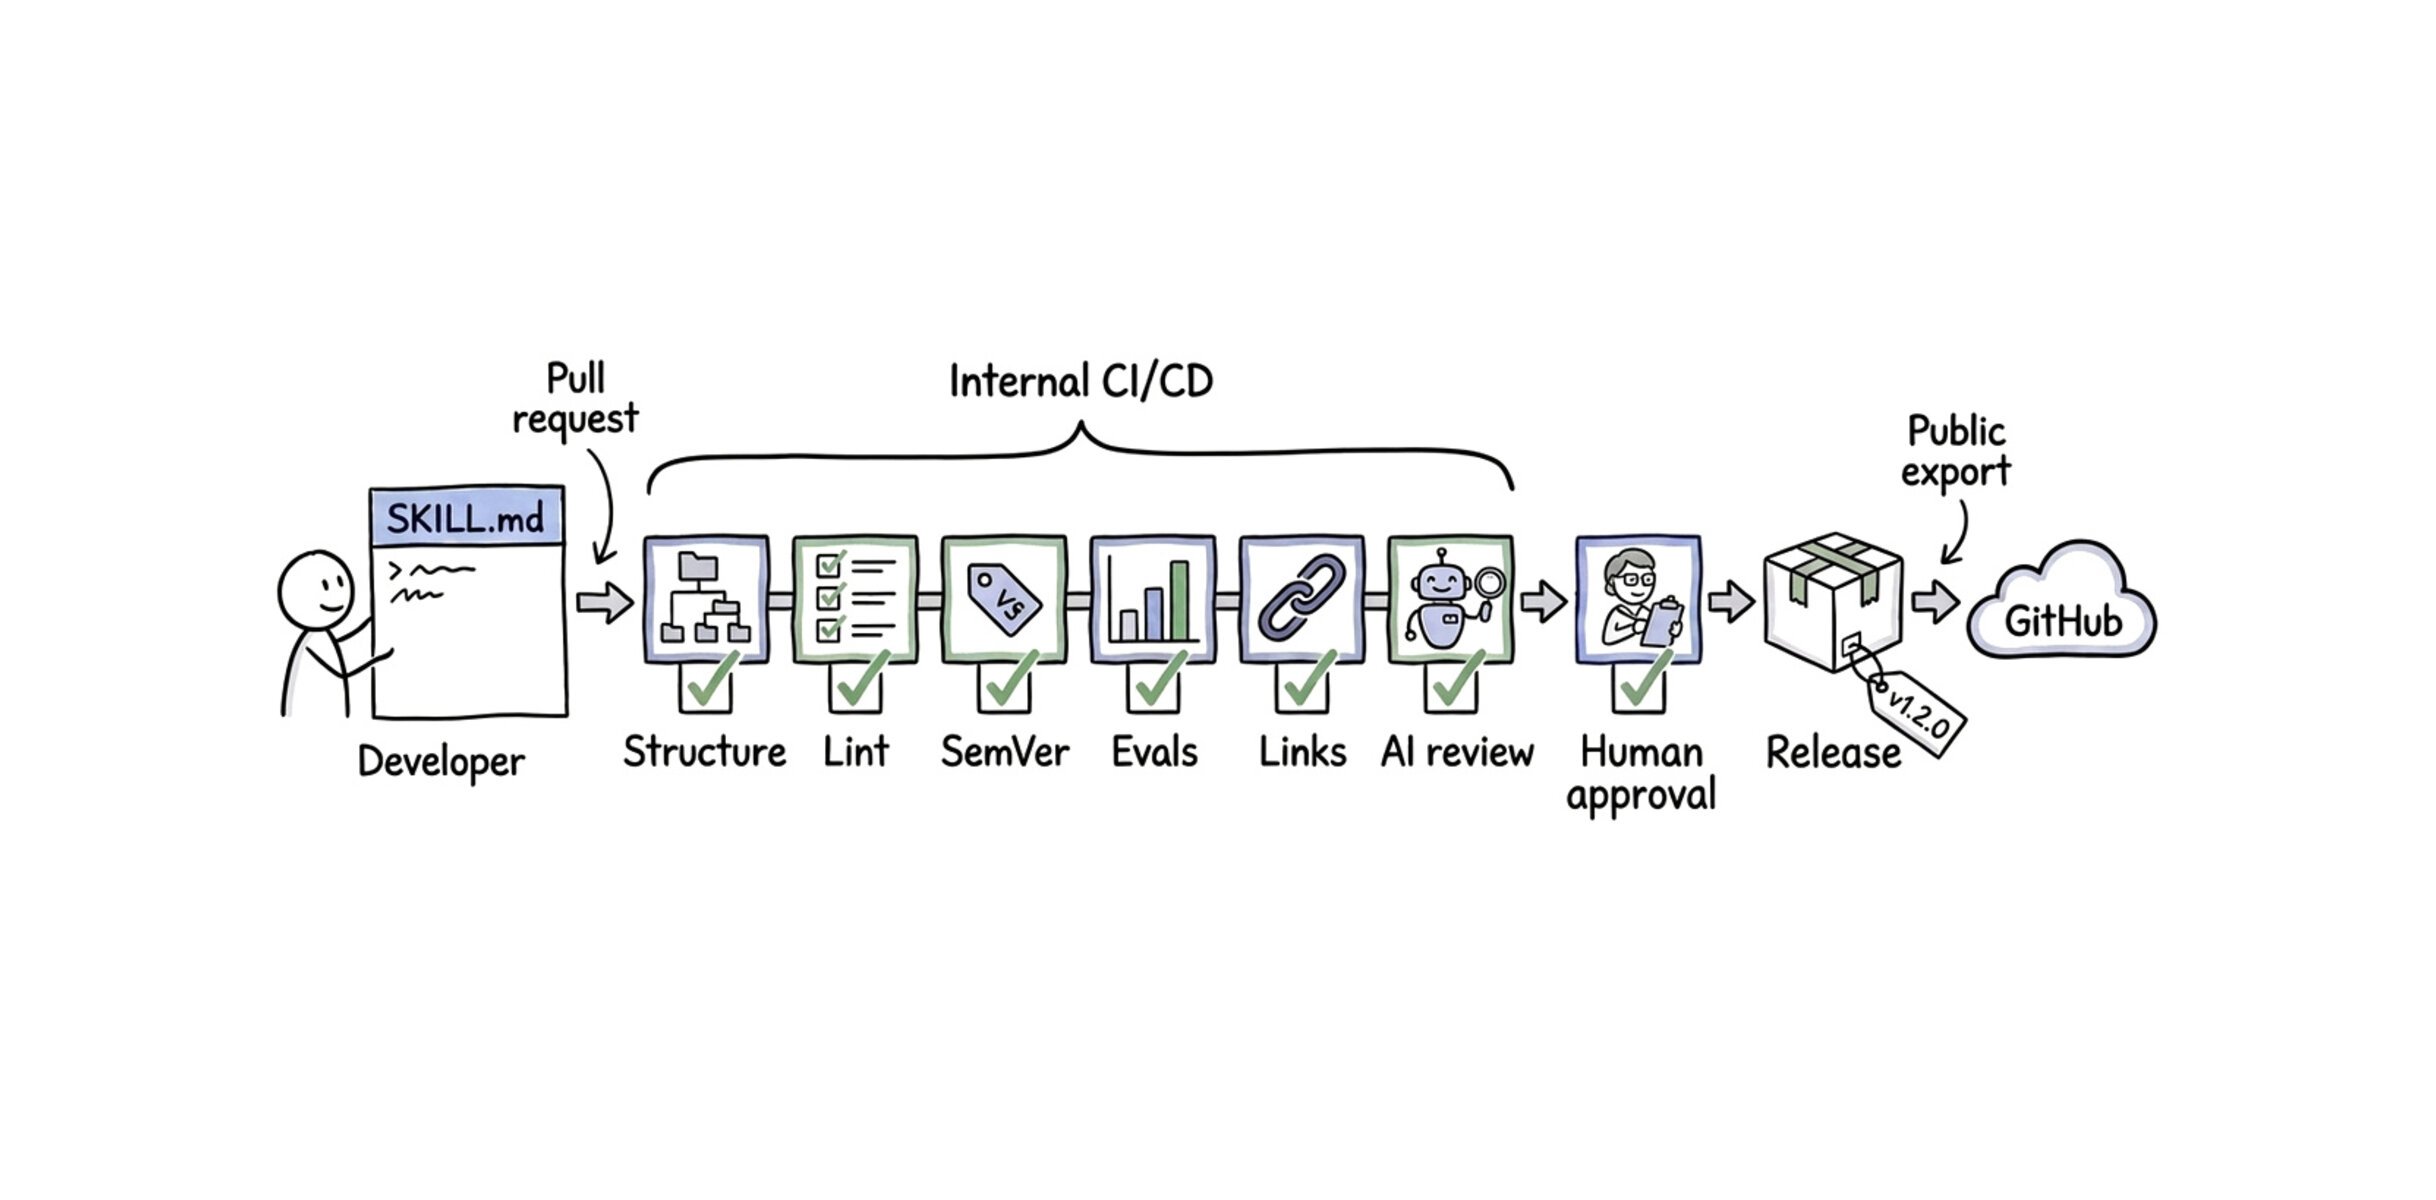
具体落地是六个自动化门禁加一道人工审批。结构合规检查目录布局、允许文件和分类法;linter 检查 frontmatter、文件夹命名和 Markdown 规则;语义化版本阻断未升版本的变更;评估套件校验 eval 配置和报告;链接校验保证引用可用;AI 审查代理评估技能质量和设计标准。最后,领域专家必须人工批准。
语义化版本被重点强调。系统要求版本号是带引号的字符串,因为 YAML 会把 2.0 解析成数字。新技能从 1.0.0 起步,任何行为变更必须升版本,并按 MAJOR/MINOR/PATCH 标准重置低位。版本号不是给运行时模型看的,而是给开发者和包工具用的;技能不会后台自动拉更新,因此不会产生网络检查和延迟。开发者可以用 npx skills update 对比本地与远端,也可以把关键技能锁到已知良好版本,保证 Agent 行为可复现。
评估套件验证器解析 eval 套件和 PR 描述,强制几类不变量:@file 引用的目标文件必须存在且非空;每条期望只检查一个标准,复合期望会被拦截;重复测试提示和冲突期望会被标记;每个改动 PR 必须附评估报告,且报告必须针对最新提交。
AI 审查代理用一套专门的 review skill 检查技能,重点防三个反模式。第一是确定性陷阱:严格的 CLI 命令序列、JSON 解析、部署步骤必须放进 scripts/ 下的可执行脚本,而不是写进 Markdown,因为 LLM 是概率引擎,逐字命令会诱发幻觉。这与之前的 MCP 建议一致:优先远程 MCP 工具,回退时用脚本包装。第二是 L1/L2/L3 分层结构:L1 元数据(frontmatter)用于发现和路由,L2 主 SKILL.md 控制在 500 行以内,L3 参考文献放在 references/,且必须扁平、禁止链式引用,因为每次跳转都增加工具调用,评估显示 Agent 常在第二层链式引用前停止。第三是脚本必须非交互:通过命令行标志或环境变量接收输入,提供 –help,破坏性操作需要 –dry-run,结构化数据输出到 stdout,错误信息到 stderr。
人工审批是最后一道关。审查者通常是技能领域专家;新技能还要由中央技能团队参与。
从半年提交历史里提炼出四条教训。一是 CI 检查的范围要精确:早期检查模式过宽,一行 typo 修复被错误要求绑定跟踪单,而更深目录的新技能反而漏检,应按文件操作类型和路径深度定制规则。二是评估期望必须原子化:复合期望会让 LLM-as-judge 打分不稳定,拆成单条标准后结果稳定可调试。三是文档漂移很快:多贡献者仓库里手动维护目录表几天就过期,所以 README 和 index.json 用生成脚本产出,并在 CI 里强制检查。四是把昂贵的 LLM 检查放在快速确定性检查之后:结构、lint、版本检查先挡掉明显错误,再触发 AI 审查和评估,避免频繁小提交烧 token 和运行时间。
结论很明确:可扩展的技能仓库依赖扎实的开发者基础设施,而不是更好的 prompt 技巧。版本、校验、评估每个变更;用 CI 强制语义化版本和原子化期望;用 AI 审查代理抓设计反模式;链接在合并前验证,之后每周再扫一遍。这些规则和门禁都可以直接复制到自己的技能仓库里。