TorchNeuron 剖析(一):Trainium 系统级
很多 ML 工程师对’怎么跑得快’有直觉,但很少系统分析’为什么慢’。这篇文章从零开始,用 AWS Trainium 和 TorchNeuron 讲一套 inference profiling 流程,核心目标就是找到时间到底花在哪。
TorchNeuron 是 Trainium 的原生 PyTorch 后端,通过 PyTorch 的 PrivateUse1 扩展点注册,不需要像 CUDA 那样加专用 dispatch key。分析时用两个对象:NeuronConfig 控制采集哪些数据流和 NeuronCore,NeuronProfiler 负责导出 trace。NeuronConfig 要作为 experimental_config 传给 torch.profiler.profile,另外必须把 ProfilerActivity.PrivateUse1 加入 activities。关键参数:modes 选 DEVICE 和 RUNTIME,correlate_device_time=True 才能把设备时间写进 key_averages() 表里对比 CPU 和 Neuron 耗时。还有一个容易踩的坑:profiler 循环里要调用 torch.neuron.synchronize(),否则设备时间列可能为空。
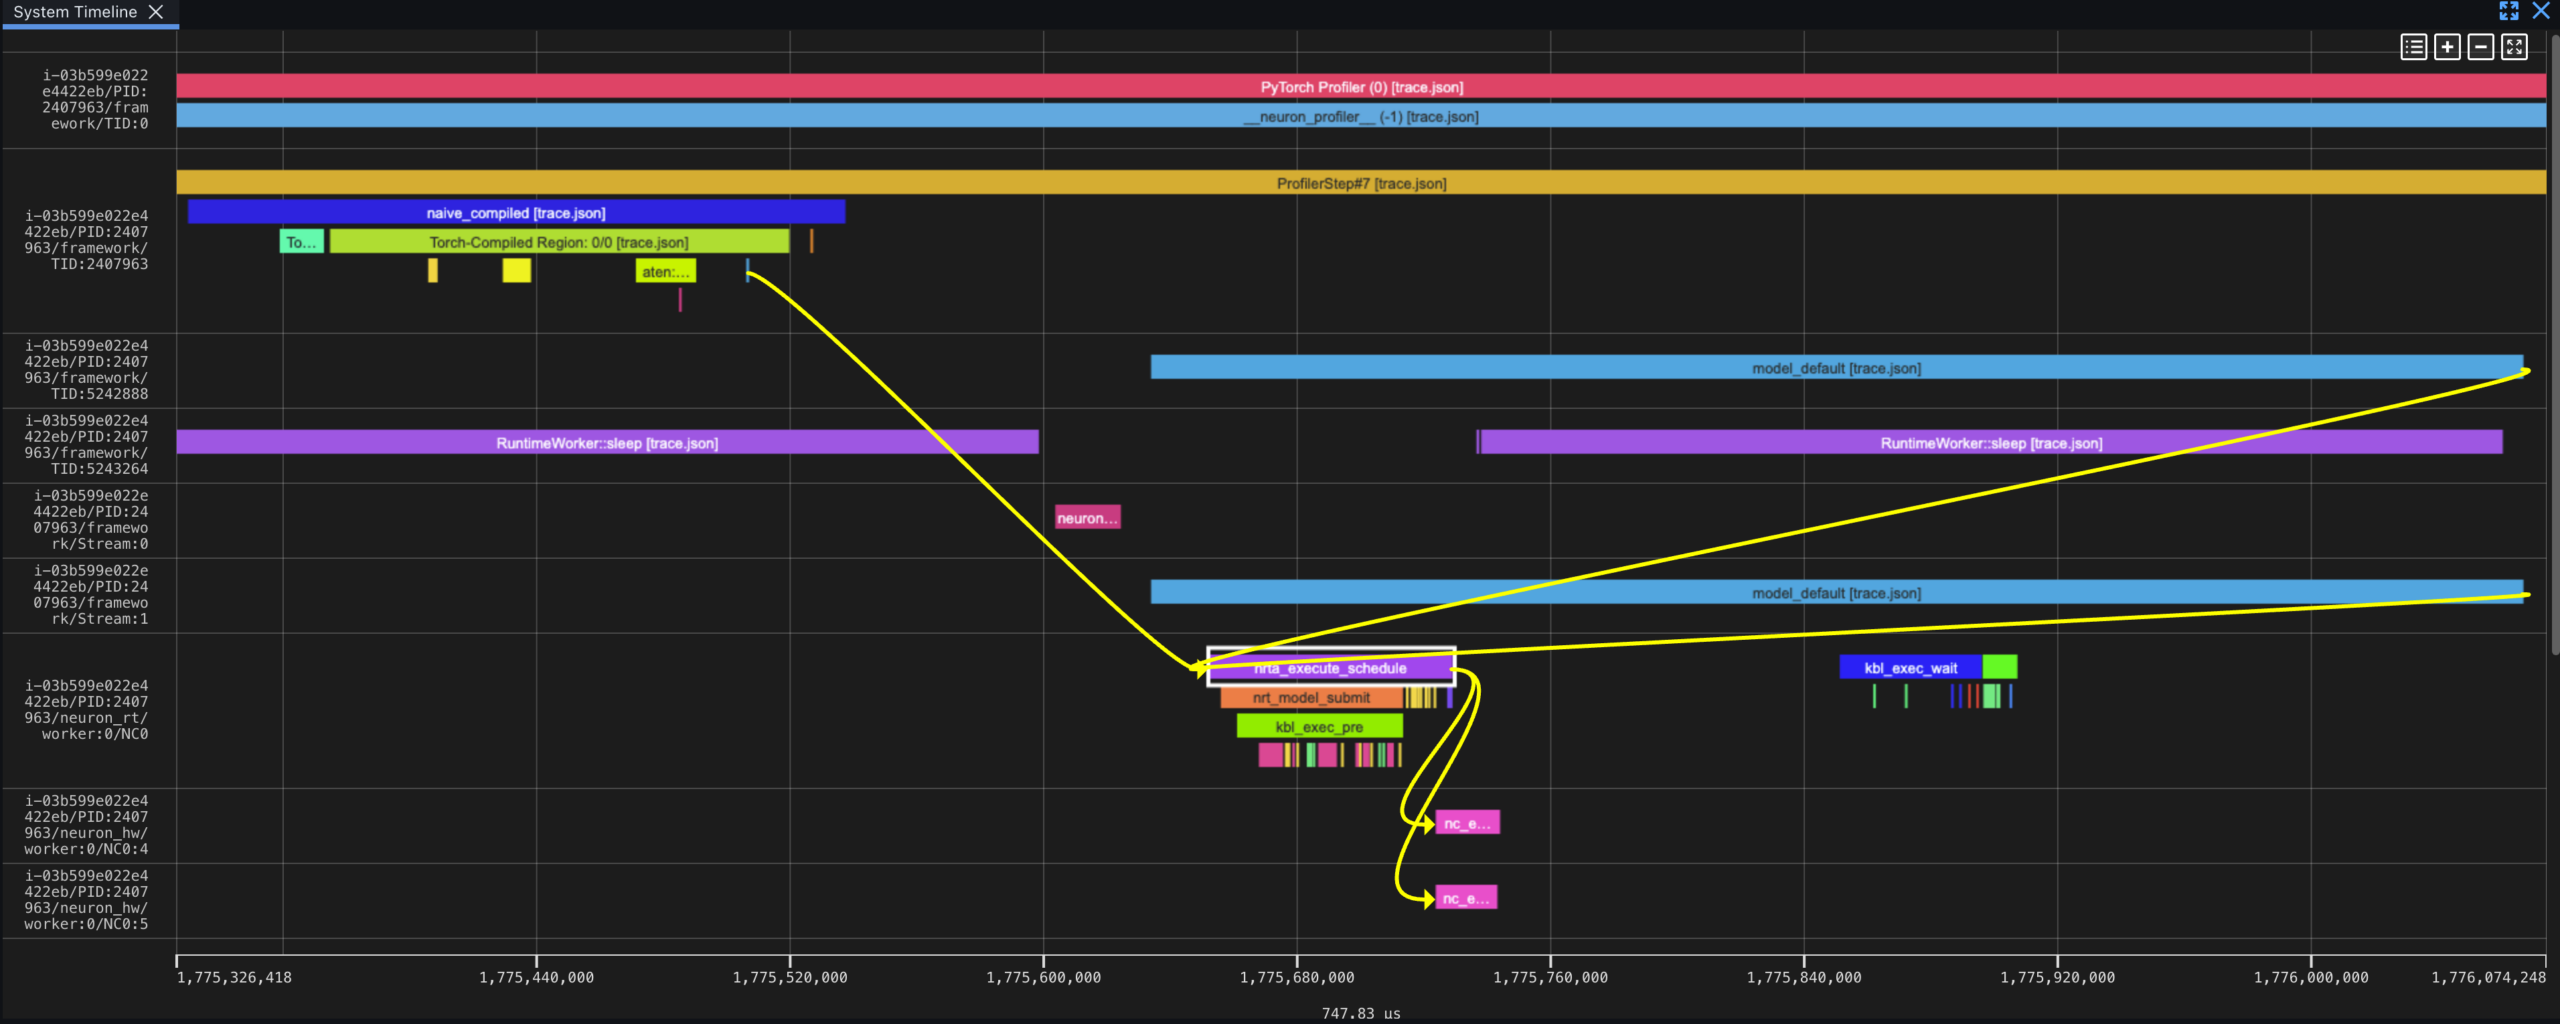
Neuron Explorer 是浏览器里的可视化工具,用来查看系统 trace、设备时间线和 engine 分解。profile 输出里,.neff 是编译后的 Neuron 可执行文件,.ntff 是对应的硬件指令 trace,两者靠数字 hash 配对。上传整个目录就能打开;只看 device 时需要单独上传 .neff 和 .ntff。
文章用 RMSNorm 做了三个实现对照。第一个是朴素 PyTorch 算子:6 个算子调用,NEURON 总时间 2.355 ms,其中 aten::mul 三次占 1,164.5 μs(49.5%),aten::add 434.6 μs,aten::rsqrt 415.0 μs,aten::mean 340.8 μs。在 Neuron Explorer 里,每个算子都遵循 framework dispatch → runtime scheduling → hardware execution 的路径,能看到算子之间因为独立 dispatch 产生的空隙。第二个是 torch.rms_norm 内置函数,Neuron 把它 lower 成单个融合 kernel,在表里只出现一次 aten::_fused_rms_norm,NEURON 时间降到 403.3 μs,Self CPU 约 48 μs。第三个是用 torch.compile(backend=’neuron’) 编译同一个朴素函数,TorchDynamo 把 Python bytecode 抓成 FX graph,Neuron backend 拿到完整图后融合编译成单个 NEFF,一次硬件 dispatch 执行完,NEURON 时间 375.5 μs,Self CPU 约 98 μs。
两个融合版本都消除了一次次 dispatch 之间的空隙,也避免中间张量 x_sq、mean_sq 落盘,在这组测试里设备时间约为朴素实现的 1/6。作者建议把同样的工作流用到大模型上:先在 key_averages() 里找热点,再到 trace 里验证,然后判断用 fused op 或 torch.compile 能不能压掉开销。下一篇会进入 device-level profile,打开 NEFF 检查 TensorEngine、VectorEngine 和 DMA 分解,再把 kernel 放到 roofline 上判断是 compute-bound 还是 memory-bound。