Hugging Face 如何用三类云服务为 Papers with Code 构建混合搜索
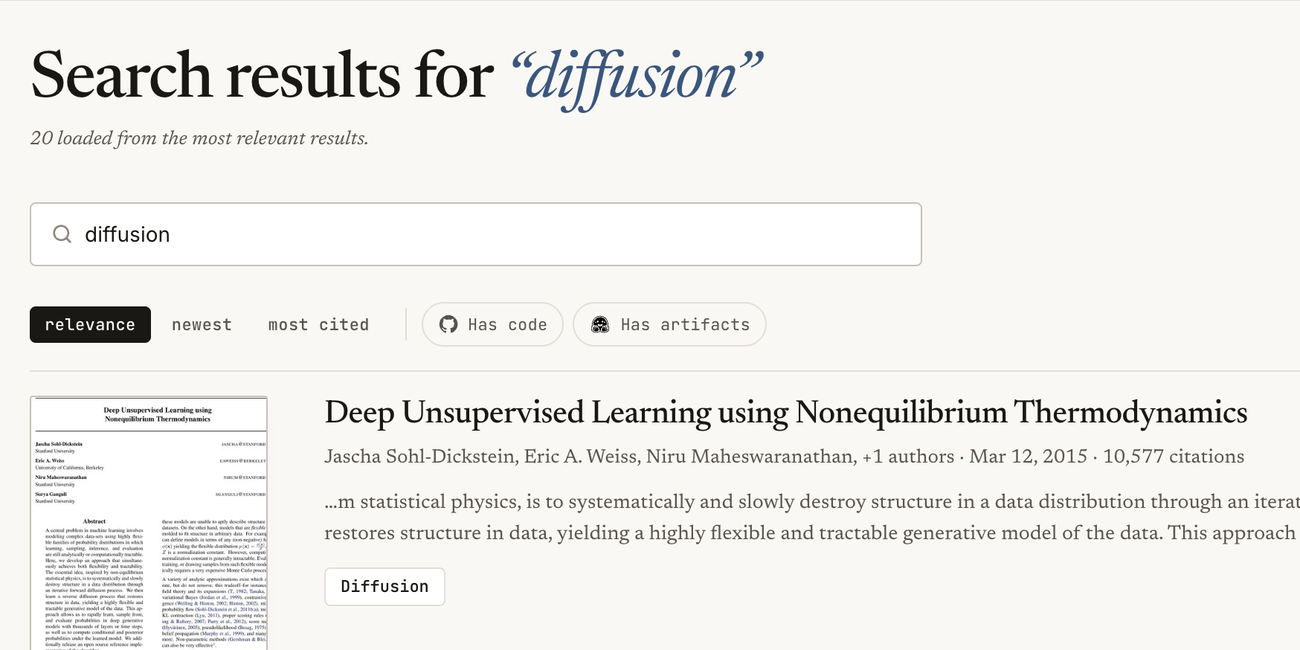
Hugging Face 团队重启了 Papers with Code,目标是让开放 AI 研究更容易被检索和理解。整个系统的搜索能力由一个混合检索架构支撑:关键词搜索负责精确匹配,向量搜索负责语义召回,两者通过 RRF 融合。这个架构不是一次性搭建的,而是把离线构建和在线服务明确分离,每个环节都有专门的 Hugging Face 服务参与。
## 离线构建与在线查询的拆分
核心设计决策是:把昂贵的、吞吐量导向的工作放到 Job 里跑,结果存进 Storage Bucket,只有查询端的向量化步骤放在请求路径上,由一个带鉴权的 Inference Endpoint 提供。endpoint 如果冷启动、忙碌或不健康,搜索会立刻降级为纯全文检索。这种拆分让系统既强大又快速。
## 用严格的嵌入契约避免隐性失败
嵌入管线经常在细微处出错:模型版本变了、查询和文档的 prompt 混用、向量截断方式不同、摘要更新了但存储的向量没变。团队把这些全部视为版本化 API 来对待。每篇论文编码为「标准化标题 +
+ 标准化摘要」,每次生成向量都记录模型仓库和精确 revision、输出维度、输入格式版本、是查询还是文档、归一化方法、以及标题和摘要的内容哈希。生产环境使用 Qwen/Qwen3-Embedding-0.6B,固定 revision,输出 256 维 L2 归一化向量。Qwen3 支持 Matryoshka Representation Learning(MRL),可以动态指定 embedding 大小,团队选了 256 维来换取速度。
## Jobs 把数据库快照变成向量语料库
全量嵌入是典型的批处理负载:需要短时间 GPU、高吞吐、不运行时不占资源。Hugging Face Jobs 正好匹配。流程是:从 PostgreSQL 的可重复读快照导出所有论文,流式写入 JSONL shard,生成包含行数和 SHA-256 校验和的 manifest,同步到私有 Storage Bucket,然后在 l4x1 Job(NVIDIA L4,24GB VRAM)里用 hf-mount 直接挂载 Bucket。worker 会校验输入 manifest 和每个 shard 的校验和,加载固定模型,按长度排序减少 padding,调用 encode_document 批处理,OOM 时自动缩小 batch size,截断到 256 维并归一化,原子写入 float16 Parquet。每个完成的 shard 有独立 marker,重试可以跳过已完成的工作。在 5000 篇论文的试点中,Qwen Job 在一张 L4 GPU 上以 1024 维编码约 75 篇/秒,同时还能确定性地生成 512 和 256 维结果,从而比较存储和检索的取舍。
## Bucket 作为系统间的显式契约
Storage Bucket 是可变的、类 S3 的对象存储,通过 hf://buckets/ 路径访问,Job 中可读写挂载。对团队来说,Bucket 是三套生命周期不同系统之间的边界:数据库导出源记录、临时 Job 消费记录并产出向量、importer 验证结果后才触碰搜索索引。所有工件按 immutable run 前缀组织,run ID 从不覆盖,每个工件都有 manifest 和校验。这样带来了可复现性、安全重试、低成本实验、受控上线和简单回滚。只有 importer 重新检查 schema、校验和、维度、归一化、唯一论文 ID 和当前内容哈希后,向量才会载入 PostgreSQL,然后构建独立的 HNSW 索引,并只在所有当前论文都覆盖时原子地标记为 active。
## Inference Endpoints 处理查询向量化
文档侧由批处理解决,但用户查询必须在请求时用同一个模型契约嵌入。团队把固定模型部署为 Text Embeddings Inference(TEI)后端,使用查询 prompt 返回归一化 256 维向量。API 通过 pgvector 做余弦距离搜索,HNSW 索引保持查询快速。在 5000 篇论文试点中,256 维 Qwen 索引达到 0.9955 Recall@20(相对精确搜索),HNSW 查找 p50 为 1.31ms,p95 为 2.21ms。表加索引的存储约为 1024 维版本的 27%,同时保持几乎相同的 ANN 召回。endpoint 配置最多一个副本,空闲时缩到零,这节省成本,但冷启动必须作为应用设计的一部分。查询客户端因此有严格行为:1 秒生产超时、非阻塞并发限制、响应维度/有限性/范数校验、以查询和嵌入代际为 key 的短缓存、失败后的断路器、日志中不记录原始查询文本。endpoint 扩展中、超时或返回畸形向量,就立即跳过语义分支,用户仍能获得词法结果。
## 混合检索比任何单分支都强
每条查询,词法分支用 PostgreSQL 全文搜索取 50 个候选,语义分支从 pgvector 取 50 个候选,再用加权 RRF(k=60,当前等权重)融合排名。RRF 简单稳健,因为它混合的是排名而非不同量纲的分数。密集检索提升概念性查询的召回,全文检索擅长精确术语、ID 和罕见名字。系统还保留确定性身份行为:精确标题和 arXiv ID 始终置顶,方法分类识别导航性查询(如「the original BERT paper」),不完整标题和有限拼写错误使用保守 trigram 候选,模糊匹配宁可放弃也不强行给坏结果。作者建议先做关键词搜索作为基线,只有确认语义搜索能带来合理增益再添加。
## 一个 Endpoint,两条更新路径
初始大语料用 Jobs 嵌入,但 Papers with Code 持续变化:新论文、摘要修正、新 arXiv 版本。每小时增量进程选择缺失或内容变化的论文,把有界的 delta 发送到同一个 TEI Endpoint(这次用文档 prompt)。每轮最多处理 500 篇论文,batch size 16。写入前锁定源行并再次检查内容哈希,如果推理期间论文变了就丢弃向量,下一轮再处理。于是 Jobs 处理全量重建、新模型代际和大规模回填;Inference Endpoints 处理交互式查询嵌入和小增量更新;Bucket 保存大构建产物并支持可恢复和可审计。相关论文推荐几乎免费:源论文已有存储向量,只需一次近邻查询,无需在请求时调用模型。
## 六条经验
1. 把吞吐工作和延迟敏感工作分开,两者是不同基础设施问题。2. 让存储成为计算与生产之间的显式契约,带校验和的工件形成可审查边界。3. 不止锁定模型名,revision、维度、prompt、归一化、格式化都要固定并处处校验。4. 为冷启动设计,scale-to-zero 只在有快速降级路径时才有价值。5. 更小的向量是系统特性,Matryoshka embeddings 让质量、内存、索引大小和延迟成为统一取舍。6. 激活应该平淡无奇,新代际导入后独立建索引,检查完整覆盖后原子激活,回滚就是配置变更而非紧急重算。
这个架构已经在 paperswithcode.co 上线,用户可以直接体验。