DynaPORT 借助 AlloyDB 实现现代化
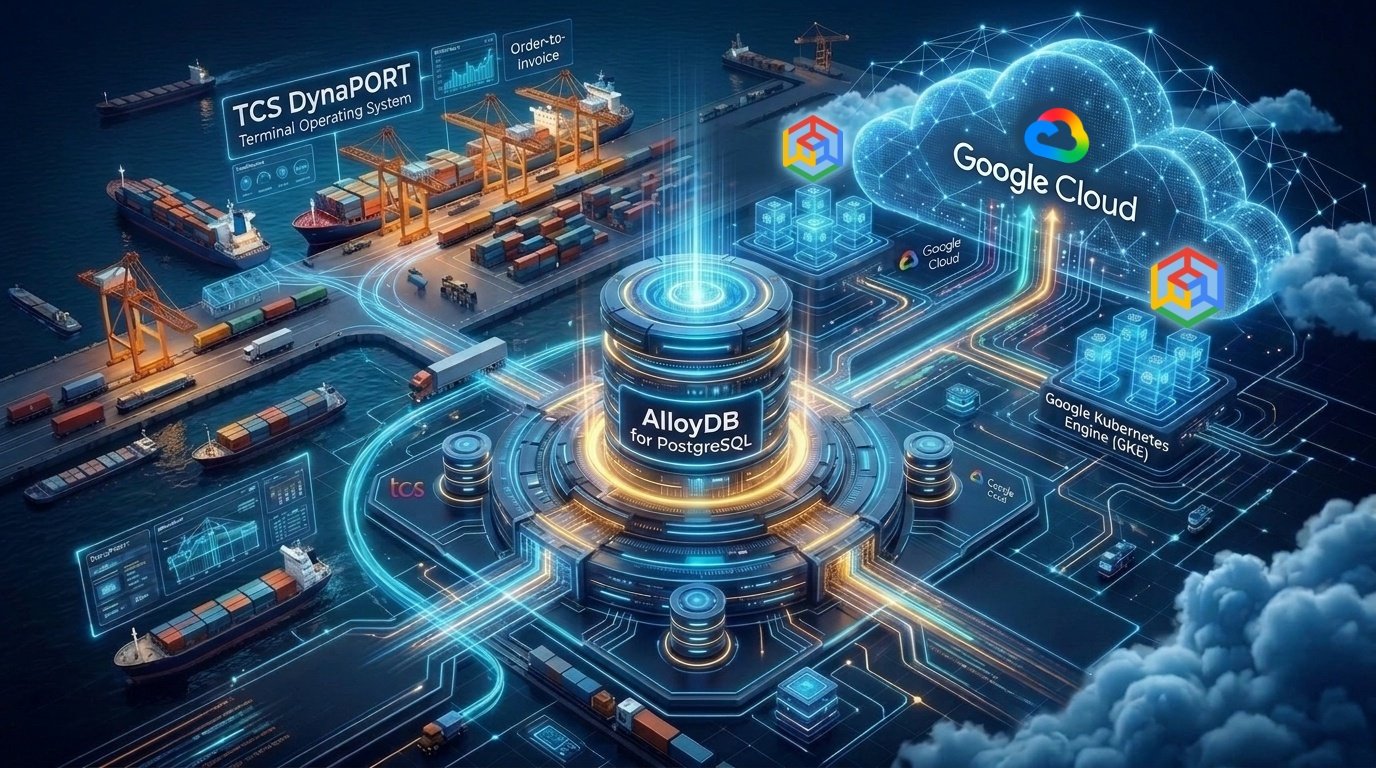
DynaPORT 是 TCS 开发的一套经过现场验证的下一代码头运营系统(TOS),面向多式联运与多用途码头。它编排船舶、铁路、卡车、驳船作业的完整订单到发票生命周期,支持集装箱、普通货物、干散货与液体散货、件杂货、滚装货物等。印度最大的商业港口开发商之一已用 DynaPORT 管理散货、件杂货与液体货物超过二十年。为了改造平台架构,TCS 与港口运营商联合 Google Cloud 启动云迁移,核心目标是把 DynaPORT 从遗留单体迁移到基于 AlloyDB 与 GKE 的云原生架构。
迁移前,DynaPORT Cargo 模块已经积累了大量技术债。核心 schema 包含 2760 张表、555 个序列、262 个包(内含超过 120 万行 代码)、54 个存储过程、53 个函数、63 个数据库触发器。长期为了追求本地数据库亚毫秒往返,业务逻辑被大量下沉到数据库引擎,多层级海运发票计费、动态分段费率、泊位分配、堆场卡车分配、自动错误日志全部由数千行 PL/SQL 过程控制。数据库不再只是存储层,而是企业的主执行引擎。应用层则运行在静态本地虚拟机上的单体 WebLogic/WildFly 服务器中,依赖 EJB 和自定义 ORM,各模块共享 JVM 堆,批量发票生成的性能尖峰可能挤占岸桥操作员手持终端的实时内存。发布需要多小时维护窗口,手动执行 SQL 脚本、重新编译包、重启服务器;修改单个包规格常会使数十个依赖函数、视图和同义词失效,触发级联运行时故障;开发、测试、生产环境配置漂移,切换前需要长时间手动对齐。许可费按物理 CPU 核数线性增长,高可用设置依赖复杂共享存储阵列、专用互连和专职 DBA 管理。
架构选型时,团队评估了两条路线。路线 A 是把业务逻辑全部从数据库抽取到 Java 应用层重写,这需要彻底改写大量数据访问对象与事务边界,预计耗时多年,被否决。路线 B 是保留数据库内过程逻辑,在 AlloyDB for PostgreSQL 上转换为 PL/pgSQL。这条路线影响面集中在语法与方言差异,应用层保持稳定,能在敏捷迭代中交付。最终选择 AlloyDB。
目标架构按 Google Cloud Architecture Framework 设计:单体 JEE 中间件拆成容器化微服务,跑在 GKE 上,数据层使用 AlloyDB 集群。迁移核心是把超过 120 万行深度交织的 Oracle PL/SQL 转为 PostgreSQL PL/pgSQL,使用 Cloud Database Migration Service(DMS)的 Conversion Workspaces 和 Gemini 辅助 AI 代码重构。DMS 自动转换了大部分标准 DDL、函数与查询,剩余约 15% 涉及复杂 Oracle 专有写法,需要针对性人工修复。比如嵌套表上的 .EXTEND 方法被替换为原生 PostgreSQL 数组拼接与动态索引扩展;ROWNUM 加物理假表 PTY_IM 的写法改为 generate_series 内存生成序列,消除了磁盘 I/O。
2026 年 4 月,现代化后的 DynaPORT 在印度最新港口之一上线,实现无缝、低停机切换;到 2026 年 8 月,另外 3 个码头也完成上线。新架构相比旧本地栈,数据库事务吞吐量最高提升 2 倍,读查询亚秒级返回,并引入自动化的 ML vacuum 与内存优化;高可用从复杂 SAN 故障转移转为亚秒级自动故障转移,提供包含维护在内的 99.99% 可用性 SLA 与零事务丢失;部署从多周发布周期和风险较高的手动数据库补丁,转为 GKE 容器滚动更新与 AlloyDB 非阻塞事务性 DDL;数据库 TCO 约下降 50%;资源扩展从垂直硬件限制变为 GKE Pod 与 AlloyDB 读池的瞬时水平扩展。
案例在末尾给出了三条可复用的迁移原则:不要在应用层重写关键过程逻辑,把 Oracle PL/SQL 迁移到开放 PL/pgSQL 能保留数十年经过测试的业务规则,同时完成基础设施现代化;普通开源关系型引擎在极端吞吐场景往往需要大量调优,AlloyDB 的分离式存储、列式加速与内置 ML 能力适合替代传统商业数据库;应用层在 GKE 上容器化,可以获得独立扩缩容的弹性,不影响数据库稳定性。