Block 新语音模型 Dessa 听起来异常像真人
Block 的研究实验室发布了一款名为 Dessa 的语音模型,定位为“有史以来最真实的全双工语音模型”。据 Block 称,Dessa 完全基于人类语音训练,并使用单个 NVIDIA GPU。它是 全双工 模型,能同时说话和听,类似 OpenAI 早前发布的 GPT-Live。传统语音模型通常要搭配大语言模型获取知识,而 Dessa 的知识直接来自其对话数据。
Block 对现有语音 AI 的批评相当直接:把语音转成文本会丢掉大量信息,最强大的 AI 也听不到说话者的情绪,这种设计既让体验变差,还可能带来危险。作为对比,ElevenLabs v4、Fish Audio Drama 3 等模型依赖 voice tags 来驱动情感,Dessa 则声称情感已经内置在模型里;但文章没有确认它是否也用了某种标签机制。研究人员放出的对话示例中,模型会在说“累了”时听起来疲惫,会在谈论暖心话题时几乎哽咽,还能和团队成员一起玩游戏。
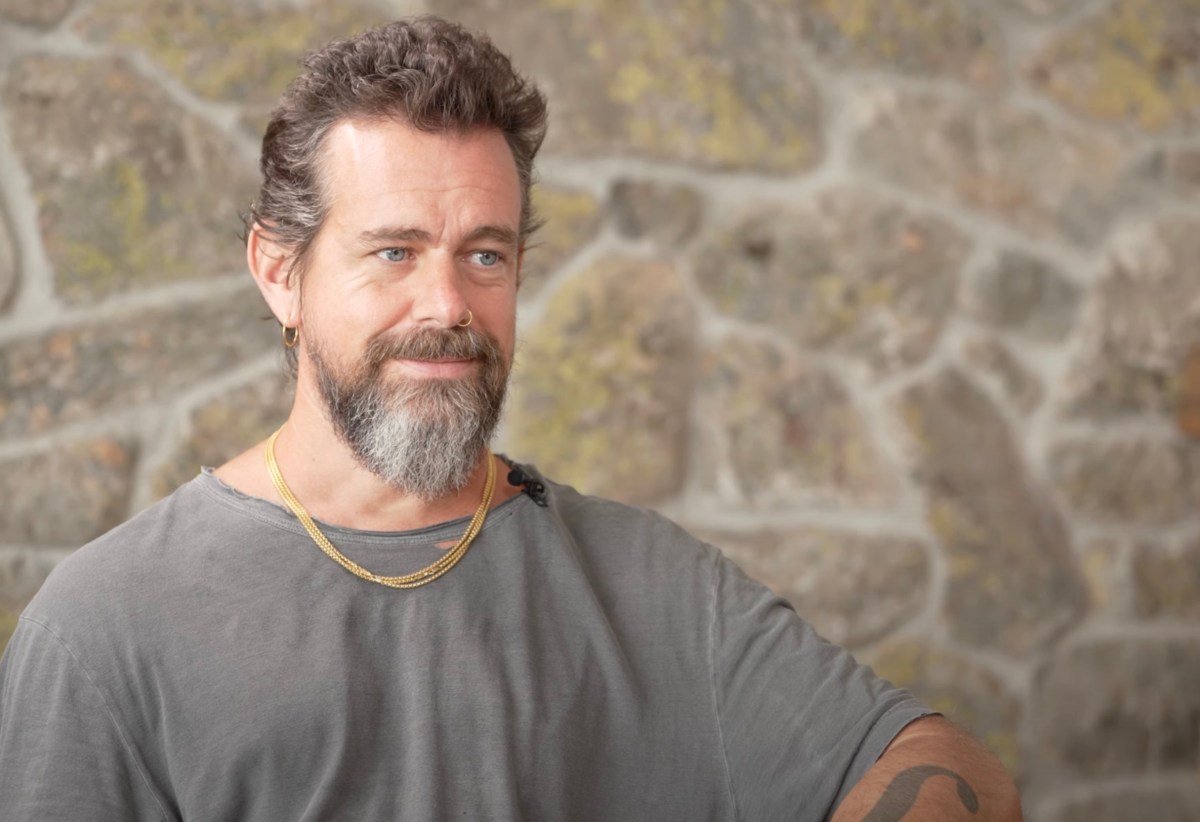
Block 首席执行官 Jack Dorsey 在 X 上写道:“我们相信语音是与智能互动最自然的方式,因此创造了 Dessa……与它交谈就像与人交谈,充满情绪、细微差别、停顿和自然的节奏。”另一条来自研究人员的推文称,这是“语音领域的 GPT-3 时刻”。
运行方面,Dessa 可在消费级电脑上本地运行,要求大约是 MacBook M4 Max 或更高配置。目前模型没有公开开放,Block 正向安全研究人员发出测试邀请,预计会重点考察语音代理欺骗人类的场景。考虑到 Block 的业务是金融和小企业解决方案,Square 的语音点单早已在落地,自研且能上设备的语音模型意味着更低的运行成本,以及更多面向商家和消费者的产品可能。