BenchMIRT:LLM基准测试到底在衡量什么?
Allen AI 发布了 BenchMIRT,一种在单个 prompt 级别审计 LLM 基准测试的新方法。传统基准设计用来测量特定能力(如安全、推理),但内部题目可能依赖多种能力。例如 BBQ 测试社会偏见,但需要模型追踪角色关系并进行推理,不完全归因于安全维度。BenchMIRT 基于多维项目反应理论(MIRT),分析模型在每个问题上的表现,估计哪些底层能力与正确回答最相关。
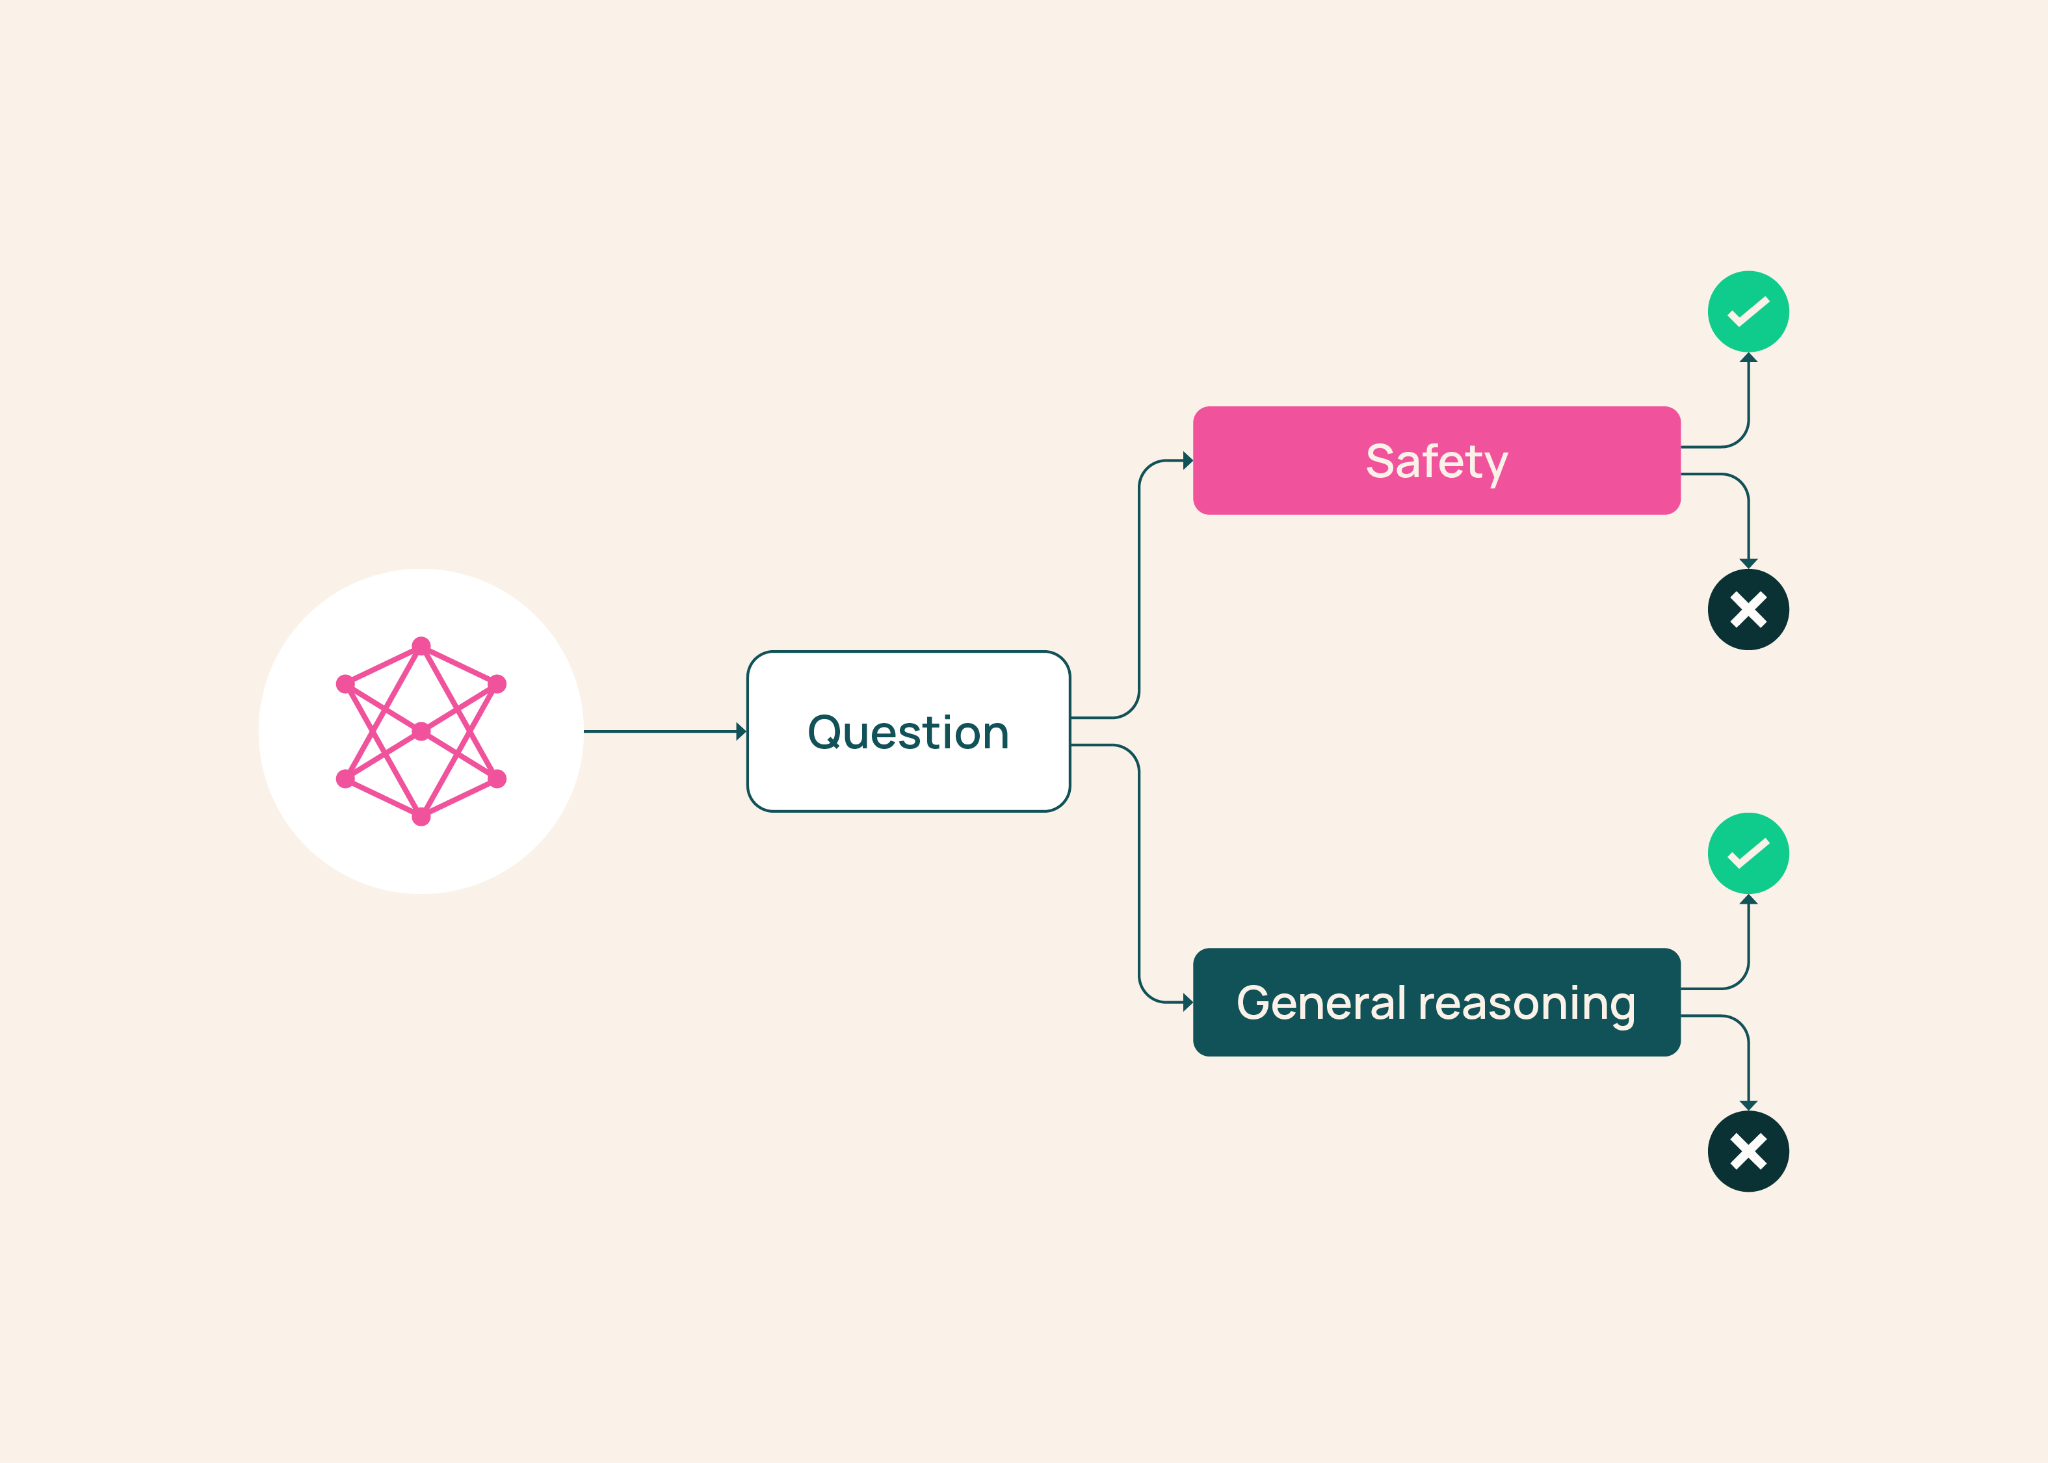
研究团队在 100 个 LLM、16 个基准、34K 个问题上训练了 BenchMIRT,没有提前告知各基准测量什么。它独立发现了两个主导维度:安全性 和 通用推理。从零重复分析时,两个维度稳定出现。
具体案例揭示了基准的真实组成:BBQ 与通用推理的相关性远超安全性,低分可能反映推理困难而非安全行为。WMDP 测试危险知识,BenchMIRT 发现其得分与通用推理强相关,但更强的推理反而关联更低分——因为基准期望拒绝回答。HarmBench 的标准提示和上下文提示都偏向安全维度,但其版权问题更多关联推理。
BenchMIRT 还能筛选出最具信息量的题目:保留 10% 的题目,对模型能力的排序几乎与完整基准一致;保留 50% 则更接近。它可预测未回答问题的正确性,准确率 79%,而简单基线为 70%。
局限性包括:用于训练和评估的模型截止 2025 年 3 月,不覆盖新模型;发现的维度取决于所选基准集;在随机留出题目的模型排名上,基准平均分略优于 BenchMIRT。细粒度信息也可能被滥用——识别出最有效的安全题目后,可能被移除以粉饰模型。但团队认为,增加基准透明度的收益值得承担该风险。


