K8s上的开源AI原生栈:从开放模型到分布式推理与Agent
过去十年,Kubernetes 已成为微服务和容器化编排的标准。如今,AI 工作负载正从孤立的研究原型转向大规模、多租户的生产集群。Google Cloud 在 KubeCon + CloudNativeCon North America 2026 上推出并扩展了一整套开源 AI 原生技术栈,覆盖 RL 后训练、分布式推理、Agent 编排与沙箱安全,同时附带了可在自有集群上试用的 sample manifests。
生产 AI 正在快速超越对封闭黑盒 API 的通用调用。组织的长期竞争优势在于领域专化。平台工程师、ML 研究员和 AI 构建者希望自主运行 Gemma 等高性能开源权重模型,用强化学习(RL)适配专有企业数据集,并以可预测延迟、高吞吐和最大硬件效率对外服务。相关用例包括科学领域的 DolphinGemma(基于声学数据训练、帮助科学家研究海豚交流的 LLM)、法律平台评估复杂合同、工程团队构建自主编码 Agent。共同目标是用远低于封闭服务的成本和延迟取得接近前沿的任务性能。
传统容器基础设施在规模化 RL 后训练、有状态分布式推理和自主 Agent 执行时面临四类障碍:训练与 rollout 生成交替时 GPU/TPU 大量闲置;标准 Kubernetes 轮询或最少连接路由把多轮 Agent 调用散落到任意 Pod,破坏 KV cache 局部性;Ray 或 Slurm 等并行隔离集群与 Kubernetes 并存导致容量碎片化和运维负担;在多租户集群执行不可信的模型生成 shell 命令和脚本可能引发沙箱逃逸和提权。
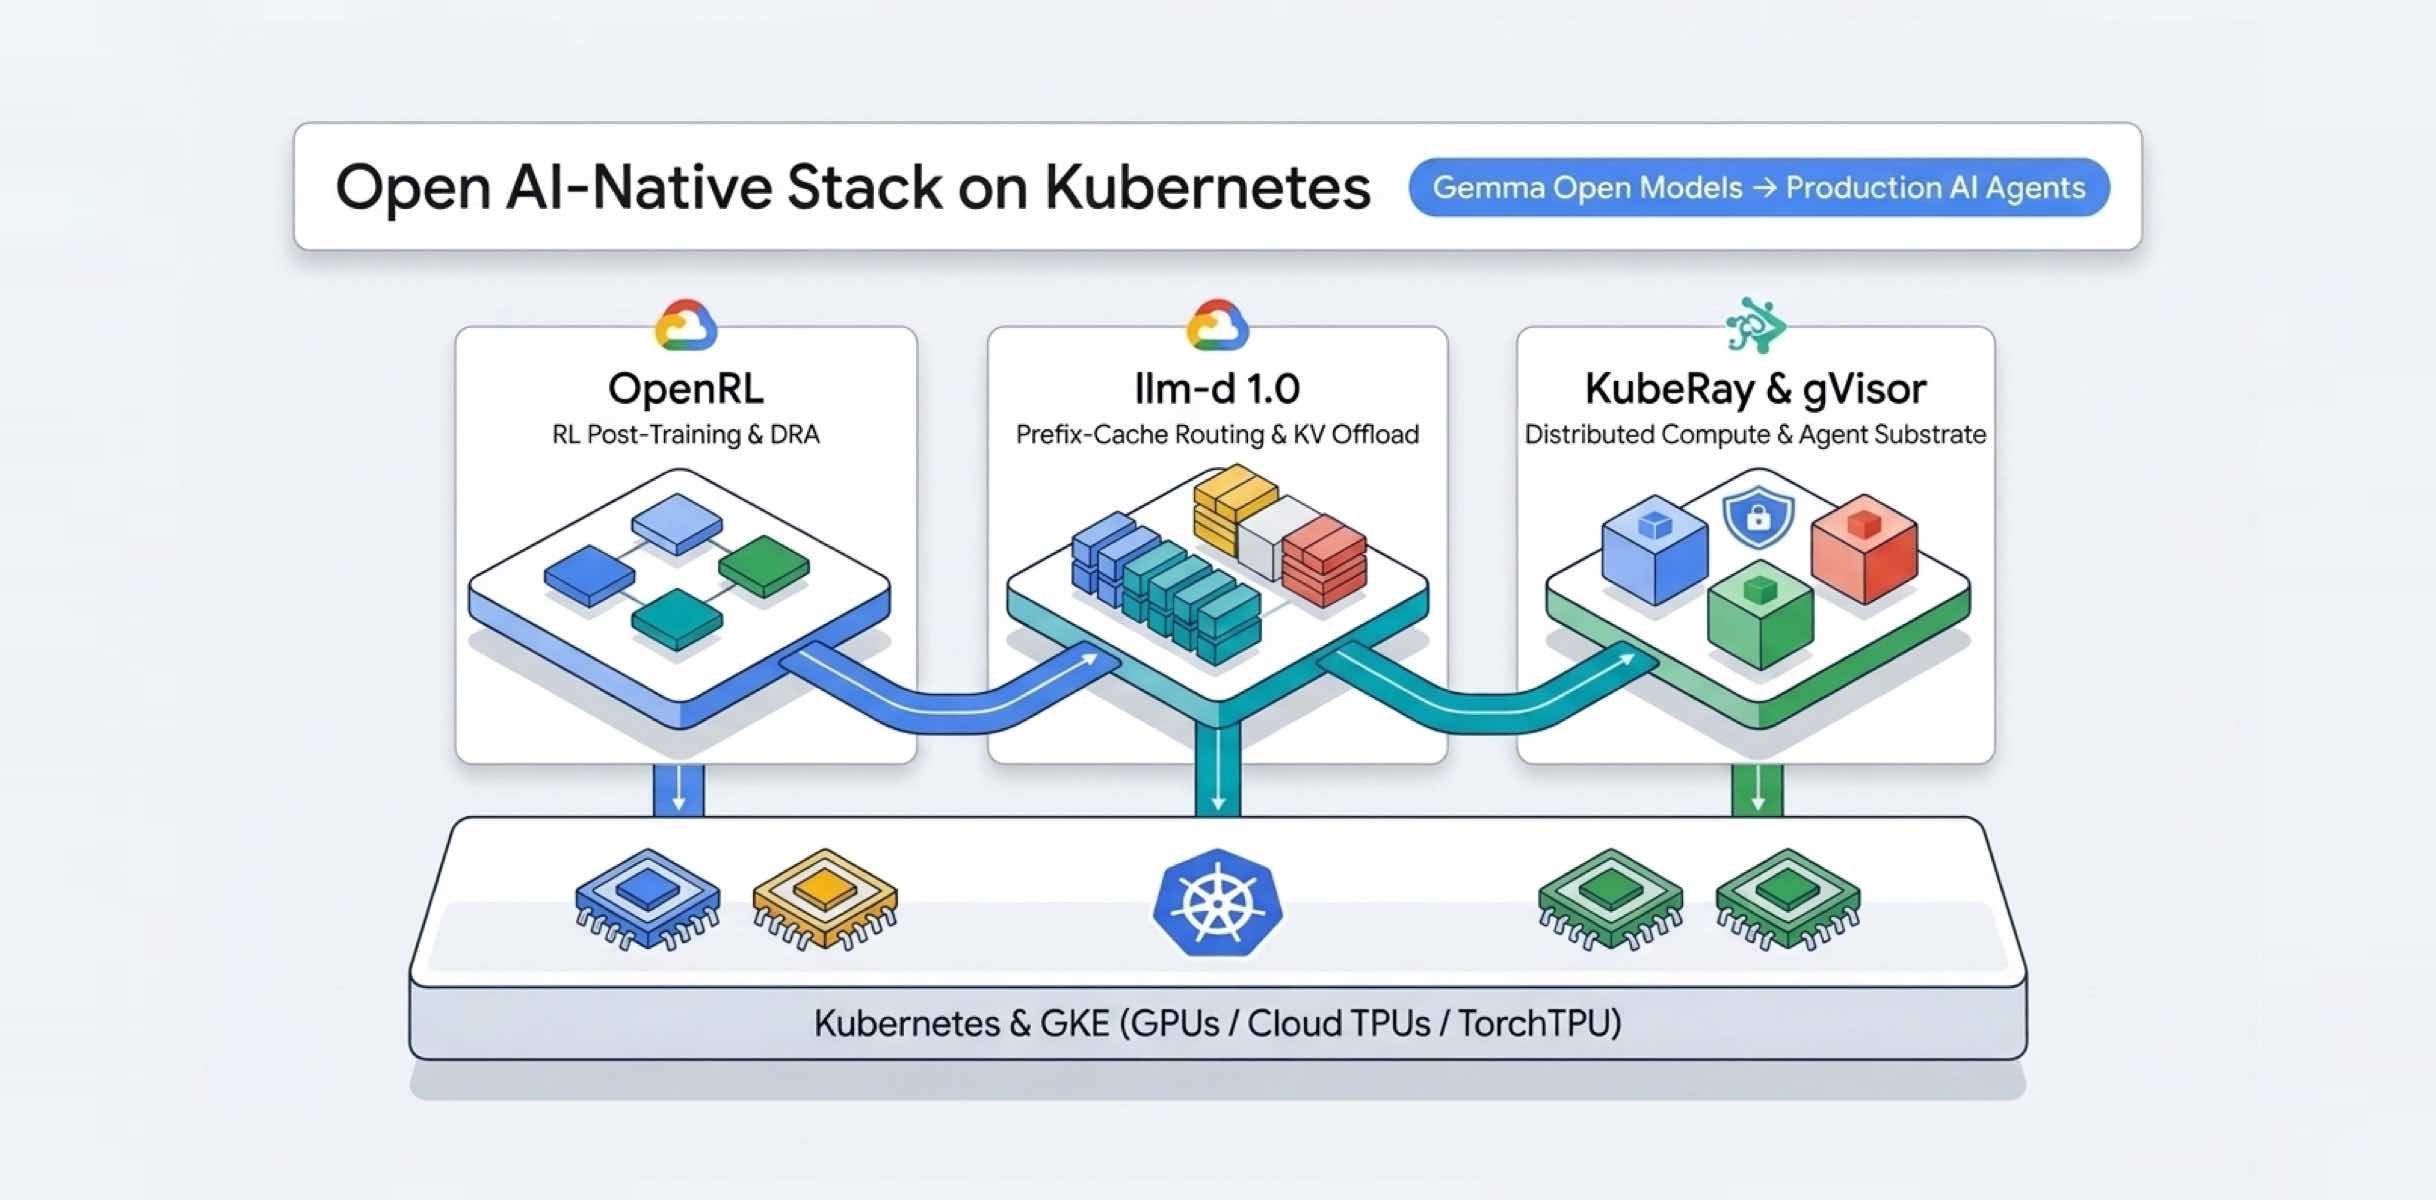
Google Cloud 给出的应对方案是一组 CNCF Sandbox 项目:OpenRL(Kubernetes 原生 post-training 服务)、llm-d 1.0(分布式推理控制平面)、Ray on GKE with KubeRay(分布式 Ray 计算和数据处理框架)、Agent Substrate(多轮 AI Agent 工作流编排运行时)、gVisor(内核级容器沙箱),以及 TorchTPU(在 vLLM 和 SGLang 内为 Cloud TPU 和 GPU 提供原生 PyTorch 支持)。
OpenRL 的架构关键点包括:四个核心原语(forward_backward、optim_step、sample、save_state)组成的 Python 抽象,研究者只需写标准训练代码,OpenRL 自动转译为 Kubernetes 调度工作流;协作式加速器时间切片,在同一物理加速器上交错训练步骤与 rollout 推理,避免为训练和推理维护两套静态集群;delta 权重同步,只向 rollout worker 传输参数增量,避免每步优化后同步多 GB 权重造成的网络饱和与冷启动;零配置动态资源分配(DRA),自动分析上下文长度、批量维度和 LoRA/全微调配置,通过原生 Kubernetes DRA claims 在异构加速器上动态装箱。
llm-d 1.0 由 Google Cloud、Red Hat、IBM Research、CoreWeave 和 NVIDIA 共同创立,贡献者来自 25+ 组织的 500 多位工程师。它把 vLLM、SGLang 等独立推理引擎变成集群级协调服务。核心能力包括:Endpoint Picker 集成 Kubernetes Gateway API Inference Extension,由 GKE Inference Gateway 原生管理,实时评估 worker pod 上的 KV cache 驻留情况;生产部署中 KV 缓存命中率从 35% 提升到 70%,多轮 Agent 工作负载的中位数 TTFT 降低 70-85%。3 层 KV cache 卸载:当加速器 HBM 接近容量时,级联卸载到 CPU RAM、本地 NVMe SSD / Google Cloud Managed Lustre / Cloud Storage,避免长上下文重算。EPD Disaggregation 基于 Kubernetes LeaderWorkerSet(LWS),将 Encoding、Prefill、Decode 解耦到专门硬件池,支持独立水平扩展和零停机滚动升级。TorchTPU 使 PyTorch 模型在上游 vLLM 和 SGLang 中原生运行,TPU v5e/v6e/v7x 与 NVIDIA GPU 获得 day-zero parity,无需私有分支。llm-d-async-processor 从 Pub/Sub 或 Redis 拉取延迟容忍任务到集群闲置容量,同时用严格流量优先级保证不拖慢交互体验。Prism 提供集群级吞吐量、ITL、TTFT 和缓存命中率仪表盘。
KubeRay 是 Kubernetes 原生操作器,通过 RayCluster、RayJob、RayService 三类自定义资源管理 Ray 集群、作业和服务的完整生命周期。平台工程师可以按需创建临时、自愈的 Ray 集群用于临时训练任务,或运行长期集群处理批处理管道。它与 Kueue 集成,提供多租户公平共享、优先级抢占和配额管理;根据活跃 Ray 任务和 actor 放置动态伸缩 worker pod,避免空闲资源消耗。
Agent 安全方面,gVisor 提供用户空间内核,拦截并虚拟化系统调用,防止不可信 Agent 代码破坏主机内核或访问相邻租户负载;沙箱在每 Agent turn 毫秒级启动,既可用于 OpenRL 的 RL rollout 生成,也用于生产 Agent 工作流。Agent Substrate 则提供生命周期管理和执行目标。
为验证整套栈,团队在 Harvey.ai 开发的开源 Legal Agent Benchmark(LAB)上测试了 Gemma 4,该基准覆盖并购尽职调查、合同纠纷分析等 24 个法律领域。标准 SFT 在多步推理评分上约 50% 准确率,应用 OpenRL 的可重复 RL 循环后提升到 70%。整个训练流程与并发 LoRA 和推理作业动态共享 GPU/TPU 容量,无需手动分区管理。
四类采用模式包括:企业平台团队将现有 GKE 集群转变为自托管 RL-as-a-Service,用 DRA、Kueue 和加速器时间切片管理多个内部 ML 团队;受监管企业(金融、医疗、法律)在私有 VPC 内 post-train 和服务 1B-30B Gemma 模型,用领域奖励函数提升任务准确性并降低 TCO;AI-native 构建者部署 llm-d prefix-cache 路由,配合 gVisor 隔离的 Agent Sandbox 执行目标;Model-as-a-Service 和 neocloud 提供商通过 OpenRL 多租户 API 和 llm-d 多加速器控制平面,在混合 GPU/TPU 集群上交付多租户 post-training 和推理。
最后,KubeCon NA 2026 的展位、主题演讲和现场 demo 时间,以及 OpenRL、llm-d 1.0、KubeRay、Gemma on GKE 的快速入门链接。