用 AlphaEvolve 和 Harbor 优化代理技能
每天有越来越多的人用 Google Antigravity、OpenCode 这类编码代理完成软件工程任务。但这些工具依赖指令,输出质量与输入直接相关。agent skills 可以把代理引导到构建、测试、部署代码的流程上,从而自动化工作流。问题是,大多数技能靠手写,不评估输出就很难知道哪些指令真正有效。作者先做了测试:在 Terminal-Bench 2.0 上运行 OpenCode 和 Gemini 3.8 Flash,带基线技能时,代理约三分之二的尝试可以通过;但不带技能,结果也差不多。基线技能没有带来可测量的收益。
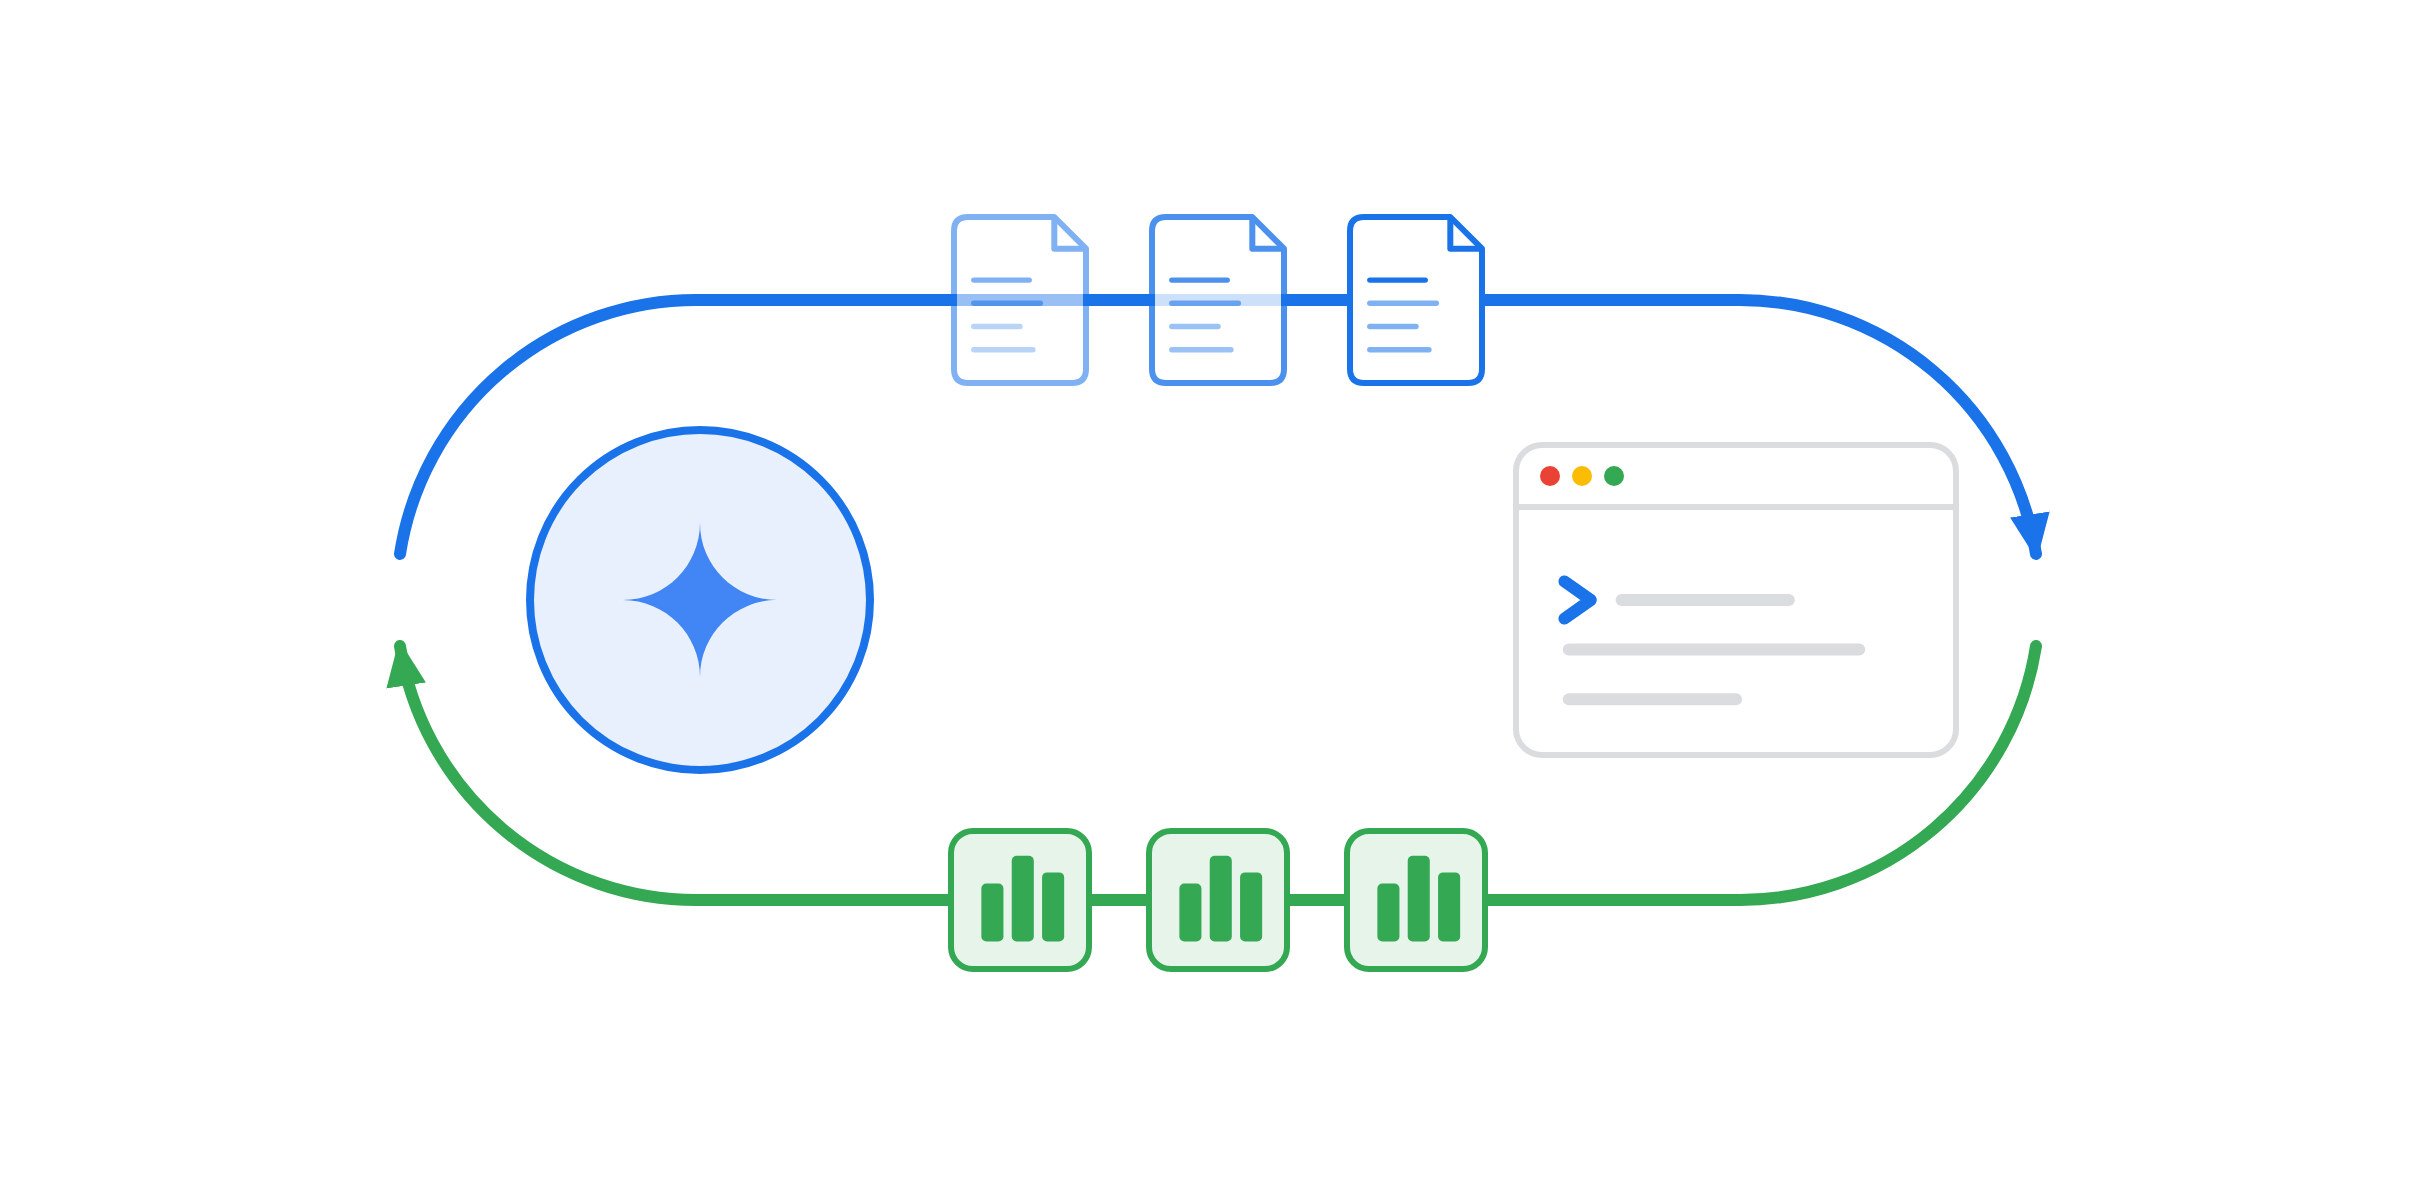
为了更好的结果,作者把 AlphaEvolve 和 Harbor 组合成优化闭环。AlphaEvolve 优化技能的方式与它优化代码一致:Gemini 提出新版本,评估器打分,搜索保留高分的版本。Harbor 充当评估器,让真实编码代理在真实任务上运行技能。仅几次迭代,结果就提升 5%。
这个闭环按四步搭建。第一步,把技能当作程序:AlphaEvolve 推进种子程序两个标记之间的代码,而技能本身是带名称、描述和 markdown 指令的 SKILL.md 文件,所以把技能文本放进标记之间,让 Gemini 重写。AlphaEvolve 运行在 Google Cloud,但不执行你的代码,它只接收评估器回传的分数与备注,这些备注表达什么是“更好”。第二步,让代理评判:Harbor 在基准任务上运行代理,每个试验在独立容器中。作者用 Google Kubernetes Engine(GKE),每个试验一个 pod,单次搜索跑了数千次代理试验。评估器为每个候选返回通过/失败得分,以及失败或超时任务的简短备注;AlphaEvolve 随后把备注发给 Gemini,用于生成下一版。
第三步,让分数可信:代理得分噪声很大。早前一次运行中,模型延迟解释了候选分数的大部分方差。作者让每个候选与基线技能在同一批任务、同一时间并行运行,用两者得分之差作为评价。第四步,在未见过的任务上检查胜者:预留一些搜索从未见过的任务做最终检查,避免结果只在评估任务上成立。
关键发现集中在三处。AlphaEvolve 自动聚焦最常见的失败——超时。搜索中约三分之一的试验触发时间限制,最佳技能因此变成围绕时间限制构建的协议。运行搜索比搭建循环更难:约 10 小时后,搜索不再产生新候选,原因是模型响应慢导致延迟检查拖住每一次评估,完整代理日志又填满了控制器的磁盘。长搜索前必须为慢模型窗口和日志存储做规划。另外,技能只有补充代理真正缺乏的东西时才有价值:基线技能没有可测量差异,而包含答案的技能在开发任务上增加 33 分。
作者据此推测:现如今的模型和编码代理已经针对编码工作充分调优,通用建议能贡献的增量很少,真正的空间在具体细节,而搜索恰好能发现这些细节。下一步,他们正在企业级代理框架上测试 AlphaEvolve,覆盖系统提示、策略指令和工具,补足代理缺少的业务规则。在一项虚构银行的客服测试小研究中,AlphaEvolve 发现并修复了被植入的错误策略规则,且修复效果迁移到了未见过的案例。其他小研究结果好坏参半,完整研究完成后会公布最终结果。相关资源可从 GitHub(AlphaEvolve)、Terminal-Bench 2.0、Harbor、agentskills.io 及 opencode skills 文档获取。