用 NVIDIA Nemotron 造一座会说话的鬼屋
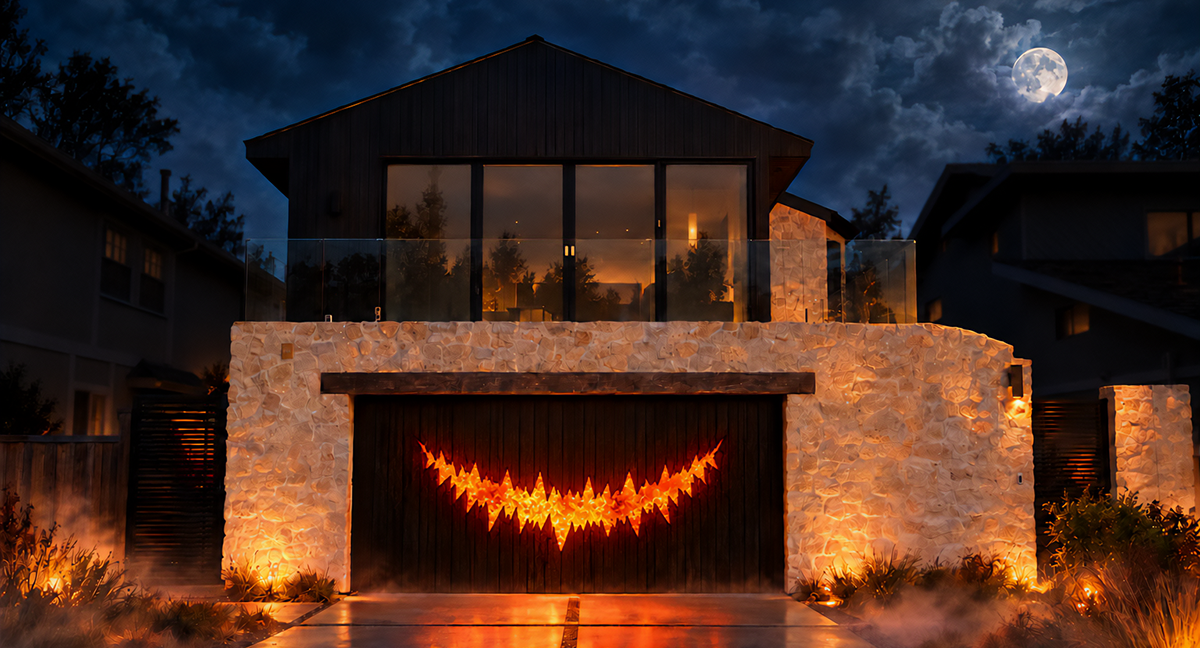
MonsterHouse 是作者在万圣节搭建的互动投影项目:车库门被改造成一张会说话的嘴,以暴躁老海盗船的口吻接待讨糖的孩子。访客一旦说“请”,它会更快松口;“谢谢”则能换来一个温和的告别。整套系统跑在一台工作站上。
核心管线由 NVIDIA Nemotron Voice Agent 串联:Nemotron Speech ASR 把访客语音转成文本(原文确认使用 nemotron-speech-streaming-en-0.6b.q8_0.gguf);NVIDIA Nemotron 3.5 Bolt E4B 4GB 负责生成回复,并用 LoRA 注入角色性格;Magpie TTS Zeroshot 根据短参考样本合成语音;Audio2Face-3D 在 Unreal Engine 5 里驱动木嘴动画。视觉模块是可选项:Nemotron 3 Nano Omni 描述服装,YOLO 和 ByteTrack 负责计数与跟踪。
为了不让鬼屋看起来迟钝,管线会在整句回复完成前先放出可朗读的文本,并用预制文本库和缓存录音覆盖常见对话。原作者给出的两条实测中位数:Bolt Q4 + TTS 从语音结束到音频输出为 1.70 秒;使用缓存回复时为 0.72 秒。语音结束检测目前等待 300 毫秒静音,Audio2Face-3D 则额外做了 100 毫秒缓冲补偿。
性格部分来自数据。作者构建了超过 5000 轮多轮对话的数据集来训练 LoRA;本地 Agent 和一个很大的 LLM 负责生成并评判这批数据,每个 LoRA 的训练时间约一到两小时。作者测试了不止一打模型,最终选择 Bolt E4B 的 4-bit 量化版作为默认回复模型,并保留 BF16 checkpoint 用于对比;他认为它比 Qwen3 30B-A3B 和 Qwen 3.6 35B-A3B 占用更小。
双 GPU 分工明确:语言与语音模型管线跑在 NVIDIA RTX PRO 6000 Blackwell Max-Q 上,Unreal Engine 图形与 Audio2Face-3D 跑在 NVIDIA RTX PRO 4000 Blackwell 上。作者说瓶颈不在显存而在计算,这样分拆是为了保持动画帧率稳定。角色模型在 Autodesk Maya 中制作,导入 UE 后加上火焰与效果;控制台提供对话、模型选择、录音、提示词、性能监控、摄像头画面等标签页,还有音板和自定义台词输入。系统有三种模式:Live 模式正常接待,Demo 模式让房子解释自己,Microphone 模式绕过识别、对话生成和语音合成,让作者直接通过房子说话,观众听到的是加过效果的声音。
作者没有回避限制。Omni 对五只绵羊的合成测试识别出海盗、吸血鬼、女巫、南瓜和幽灵,但这是合成测试,不代表真实万圣夜表现;真实门廊人群、服装和夜间光照仍需测试。检测能触发自动问候,但流行服装的识别以及对应的俏皮话可能还需要后训练。MonsterHouse 的代码没有打包发布,但所用 NVIDIA 模型都已可用。
复刻的大致路径是:克隆 NVIDIA Nemotron Voice Agent 并跑通 Generic Assistant 示例;把 Bolt E4B 作为大脑;用系统提示词和示例对话塑造人格,把“谁已经说过请”这类状态放在应用层,而不是让模型记住;提示词不够时再用 NeMo AutoModel 的 LoRA recipe 微调。语音端,Magpie TTS Multilingual 是默认项,自定义角色用 Zeroshot,需要在 UI 里为每种情绪录制参考样本。最后用 Audio2Face-3D 做口型动画,给它干净的语音流,把混响等效果放在后续。如果算力有限,可以退化为只跑 ASR、Python 对话路由器和全缓存音频的现场版:用 Bolt/Magpie 离线生成几百条回复,现场只播缓存。作者说接下来会给互动南瓜用这个做法。