LFM3:六类 2B 级多模态模型共享一个骨干
Liquid AI 发布了新一代 Liquid Foundation Models 家族 LFM3,定位是“专用智能”的起点。它把文本、视觉、音频、全模态(omni)和决策模型放在同一个 2B 级骨干上:按输入模态选模型,在单张 GPU 上用自己的数据微调,再部署到应用运行的环境。
相比 LFM2,LFM3 有四个主要变化。一是单位参数能力更强:新的 tri-hybrid 架构和训练配方让 LFM3-1.7B 比 LFM2.5-2.6B 少用 35% 参数,表现却更好。二是六类模型从一个骨干分出:LFM3-1.7B-Base 是基础,衍生出文本、视觉、音频、omni 和两个 d1 决策模型,其中 omni 是 Liquid AI 第一个,视觉模型首次支持视频。三是面向边缘:文本模型 4-bit 量化后约 1GB,256K 上下文可支撑端侧 agent。四是为专用化而设计:每个模型都能在单 GPU 微调。
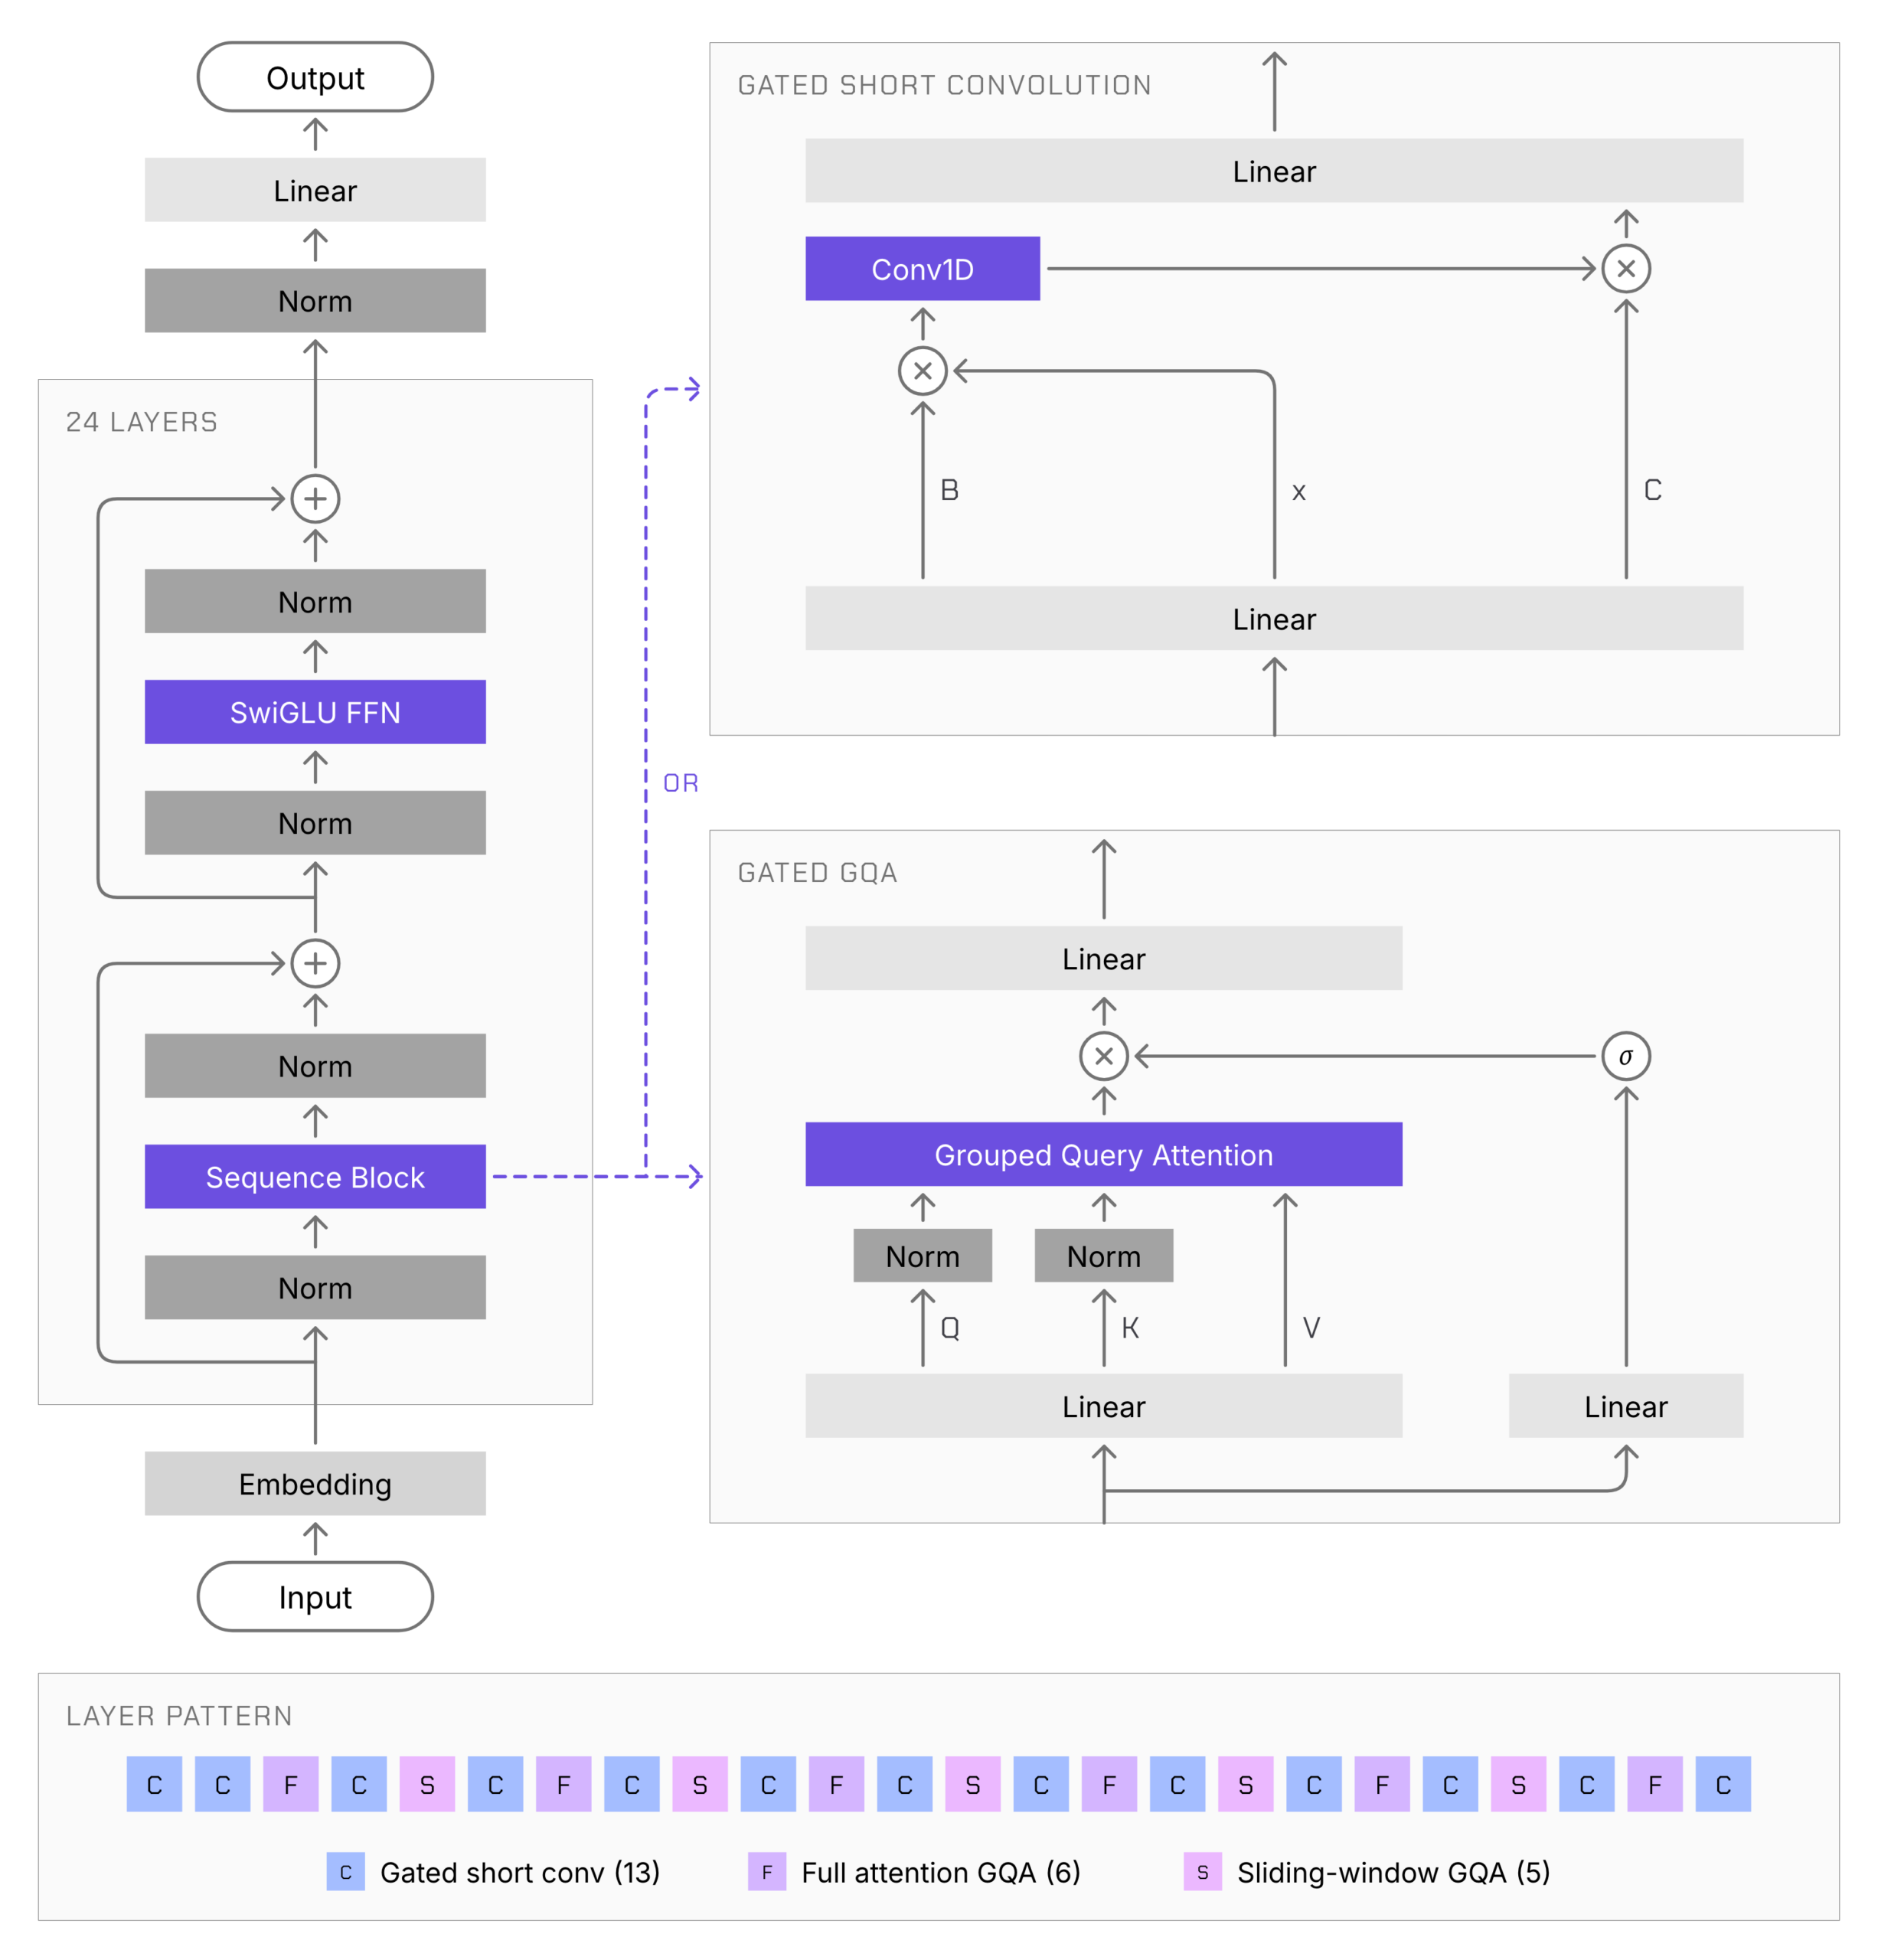
骨干架构的具体改动包括:24 层中混合 13 层 gated short convolutions、5 层 256-token sliding-window attention 和 6 层 global attention;卷积核从 3 扩大到 7;global attention 使用 head-wise gated attention 和 partial RoPE,SWA 层保留完整 RoPE;每层 sandwich norm 稳定激活。架构搜索覆盖 14 种设备/后端组合,从手机、Raspberry Pi 5 到云 CPU、GPU 和 Qualcomm Hexagon NPU。在边缘设备短提示词上,LFM3-1.7B 的单位参数表现与 LFM2-1.2B 相当;上下文带到 8K tokens 时,速度约快 25%。模型在 22T tokens 上预训练,词汇表与 LFM2.5-8B-A1B 相同(128K)。最后 3.5T tokens 是面向 agentic 的 mid-training,加入更多 agent trace 和 tool calls,并把上下文窗口扩展到 256K。
视觉编码器是卷积加注意力,比上一代 SigLIP2 少用 3 倍算力。164M 参数的视觉编码器在准确率上匹配 Qwen3.5-2B 的视觉编码器,FLOPs 少 2.2 倍(两者都接同样的 LFM2.5-230M 语言骨干)。视频输入把每两帧嵌入一个时间片,时序长度减半。音频编码器完全因果,配合 LiquidCodec 音频分词器,在 Apple M4 Max 单 CPU 线程上约 87 倍实时合成语音,支持流式解码。
各模型的基准数字:LFM3-1.7B 在 WebArena-Verified 拿 38.42,前代 LFM2.5-2.6B 只有 3.02,长任务上还超过 Qwen3.5-9B。LFM3-VL-2B 参数从 3.1B 降到 1.9B,62 个视觉基准平均分从 57.6 升到 71.4,与 12B 的 Gemma 4 12B 持平。LFM3-Audio-2B 支持 18 种语言,语音质量 UTMOSv2 从 3.22 升到 3.83。LFM3-Omni-2B 在 Daily-Omni、WorldSense、AV-SpeakerBench 上超过最高 10.7B 参数的模型,如 Qwen2.5-Omni-7B。d1-2B 比 d1-3B 少三分之一参数,ImajevBench 分数 75.5 对 64.0。所有模型都跑在 transformers 上,开放权重,Hugging Face 可下载。
Liquid AI 还展示了专用化路径:文本、视觉、音频、omni 模型都有从数据准备到评估的微调 notebook,覆盖 SFT、DPO、GRPO、CPT。机器人示例把 LFM3-VL-2B 改造成编排器、导航器和操作 VLA 三个模型。编排器通过 tool calls 操作机械臂;导航器用五个 token 预测空间目标和路径;操作 VLA 在单次前向里输出八步连续动作。联合 15 个本体训练后,VLA 在四套 LIBERO 任务上平均成功率 96.2%,RoboCasa-GR1 桌面任务 45.7%,在 Jetson AGX Orin 上用 TensorRT FP16 生成动作块不到 50ms。这是 2B 级模型从高层规划到低层控制的一个完整示例。