IBM Granite时间序列模型的集成预测
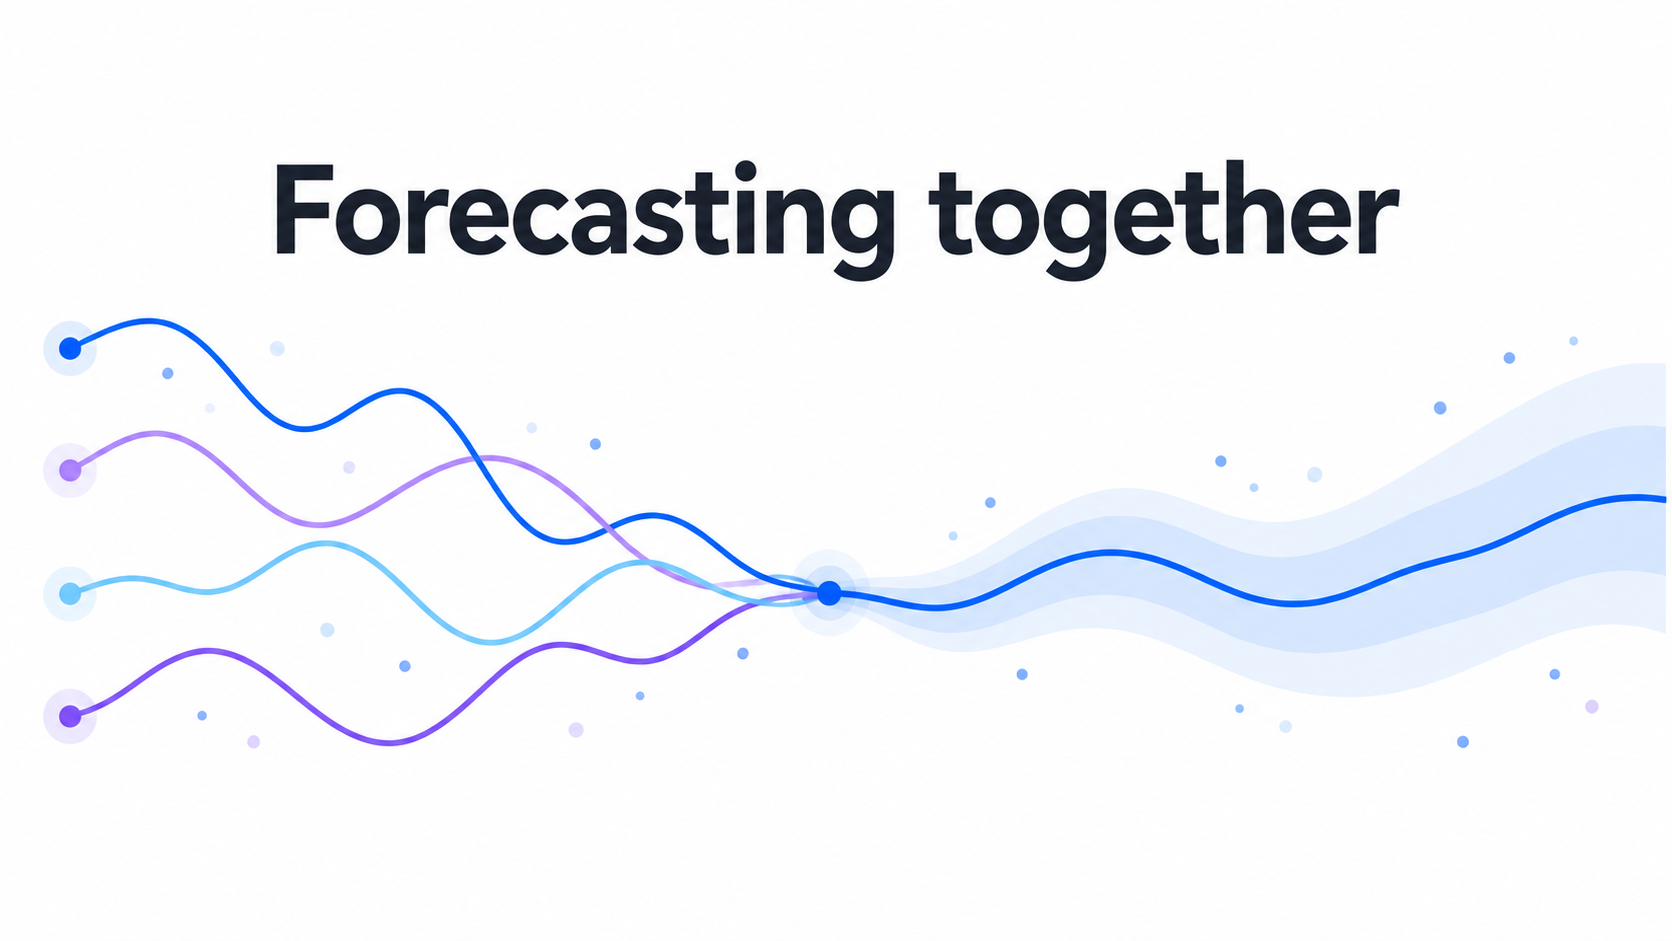
时间序列预测中,预训练模型可以在不微调的情况下使用,但仍要先选模型。不同的架构在平滑工业信号、有噪声的零售需求或长周期季节数据上表现各异。IBM 的 Granite Timeseries Ensemble 把这件事简化成一个默认配方:四个互补的开源 Granite 模型通过统一接口合并输出,返回中位数和分位数预测,不需要重新训练,也不需要拟合集成权重。默认成员采用宽松许可证。
它提供两种组合方式。Probabilistic Ensemble(均匀概率池化)让每个成员权重相等,没有可调超参数,是默认推荐入口。IQR Ensemble 则根据每个成员预测分布的离散程度加权:区间越窄、影响越大,权重会随样本、目标和预测步长变化,并用保序回归避免分位数交叉。它的风险是可能偏向于过度自信的成员,因此配方提供温度参数和单成员权重上限。
评测在 GIFT-Eval 的 97 个配置上进行,模型均未微调,测试目标也没有参与聚合方法的选择。结果中,Probabilistic Ensemble 的整体 MASE 为 0.683,是这个六项预测中最优值,略低于最强单模型 PatchTST-FM-r2 的 0.685;两个集成在平均 MASE 排名上都优于所有四个单模型。在概率误差方面,PatchTST-FM-r2 的 CRPS/MWQL 最低(0.467),而 IQR Ensemble 的平均 CRPS 排名最好。文章也明确说,集成不是为了登顶排行榜,而是让一个默认配置在众多序列上稳定给出接近最优的结果,避免事先选错架构。
同一个接口可以接受外部兼容模型,调整成员组合或聚合方式,不需要合并权重或重新训练。扩展配方中有部分 IBM Research 检查点带有非商业或研究限制,需要逐个查看模型卡。
实际使用有两个限制:当前配方对多元通道独立预测,不利用通道间信息;加载四个检查点会增加推理时间和内存。不同成员的上下文长度、预测长度、预处理和缺失值处理也不一样,两种聚合方法都不保证校准或应对分布漂移。官方建议先用自己的数据做回测:在相同历史窗口上对比 Probabilistic Ensemble、IQR Ensemble 和一个强单模型(如 PatchTST-FM-r2),同时检查分位数损失、0.1–0.9 区间的经验覆盖率,以及运行时和内存成本。