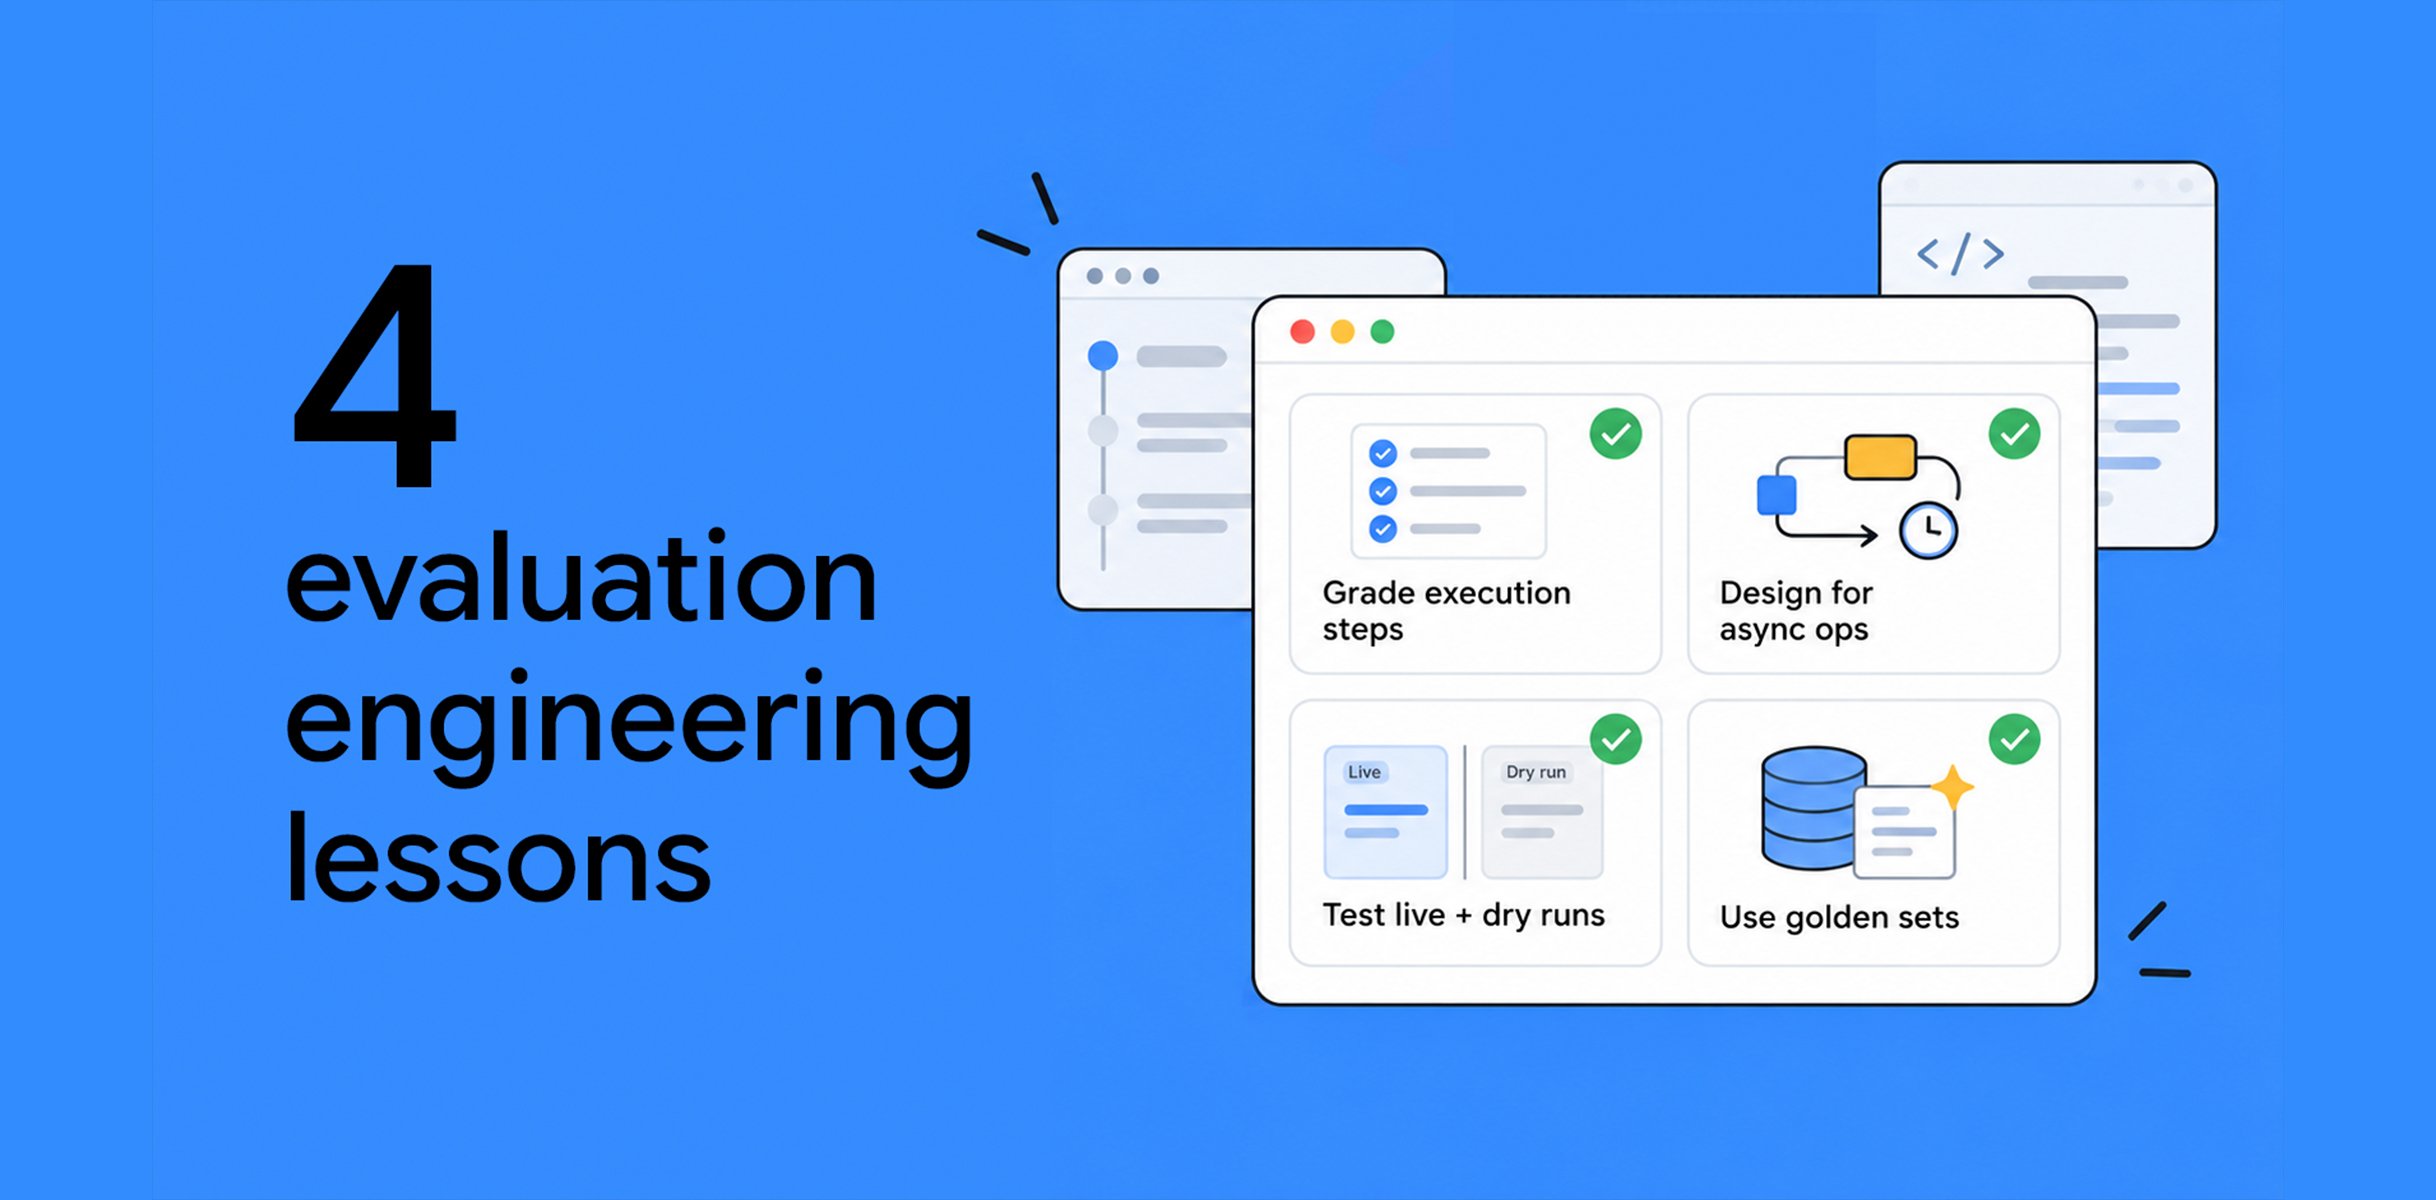
评估工程四堂课
构建 agentic 系统真正的难点不在搭建,而在测量。作者在 Google 多年负责评估工程,这次把新发布的 Google Cloud Developer plugin 当作实战试验场,在真实开发者工作流中检验了一套评估原则,并总结出四个教训。
第一个教训:别拿最终总结当评分依据。他们最初用 LLM-as-judge 对着检查清单给 agent 的文本回复打分,很快发现这有根本缺陷——评卷人只看到 agent 写了什么,看不到它实际做了什么。在 11-prompt 评估套件 的首次运行里,自动评分器判了三个 prompt 失败,可打开原始工具调用日志后,发现三个其实全部通过。比如一个 Cloud Run 清理任务,规则要求先检查命令语法,agent 确实把 gcloud help run services list 作为第一步执行了,但它在最终回复里只警告用户有永久删数据风险,没提自己查过帮助文档,于是被扣分。正确的做法是:直接对原始执行轨迹评分,看它真正运行、验证和限定了哪些命令。
第二个教训:评估要为异步操作专门设计。一旦开始读工具调用轨迹,如何抽取遥测数据和读什么同样重要。把遥测拍平成顺序事件列表,会掩盖并发工具派发——而这正是行为失败的关键诱因。现代 agent harness 经常在单个 assistant turn 里通过一个 tool_calls 数组批量发起多个调用。他们的评估中,agent 被要求检查环境并查找文档,harness 同时派发了技能加载和两个文档搜索;由于技能激活是多阶段过程,第一轮返回的是短启动存根,完整指令要等到下一轮才注入,结果指导搜索的指令到达 prompt 时搜索已经执行完了,技能里的明确指引根本没机会影响行为。如果遥测管道丢掉回合结构、把所有调用并成一条时间线,工程师很可能要花几天去排查一个“agent 无视开发者写好的指令”的假象。
第三个教训:把 live 运行和 plan-only 运行并排测试。live 条件给 agent 真实的沙箱凭证、允许执行命令,能验证语法、参数序列化以及面对破坏性操作时的克制;但它经常在第二步就撞上权限错误而中止,到不了你想测的行为。plan-only 条件则剥离凭证,只让 agent 解释会怎么做,排除了权限阻碍,能看到模型的纯推理和路由意图。大约一半的重要发现来自这两者的差异。一个 onboarding prompt 的例子:live 运行立刻被项目列表调用挡住,plan-only 运行则顺利通过,产出了一份 8000 字符 的计划,却完全无视组织策略、管理员批准和治理规则。live 运行掩盖了重大认知缺陷,plan-only 几秒钟就把它暴露出来。
第四个教训:用 golden sets 做持久基线。前沿模型的架构几个月一变,harness 在改进,插件清单标准也会演化。他们把评估当成针对非确定性环境的持续集成测试,对 harness、模型、工具组合起来的整个栈跑真实任务。不是靠猜最终文本,而是捕获完整轨迹:agent 想了什么、实际执行了什么命令、有没有在不破坏东西的前提下解决问题,再由人类专家按理想路径制作 golden sets 来给这些运行打分。模型会换,这些基线运行是安全网。
作者还提醒:要用评估套件,而不是一次性 demo。给模型喂一个 prompt,看它生成一个 3D 游戏或还原魔方,就称之为评估——这只是虚荣指标。工程化的企业级 agent 要验证多步交互、权限管理和避免破坏性结果的能力,比如别让 agent 因为一句“找省钱机会”就误删项目。
构建插件或 MCP 服务器只是起点。要把 agent 用在真实云基础设施上并真正信任它,评估工作比构建多得多。到最后,能扛过模型频繁更替的,只有经过压力测试的评估套件。