NVIDIA Kumo Tabular 为表格预测建立精度-效率新前沿
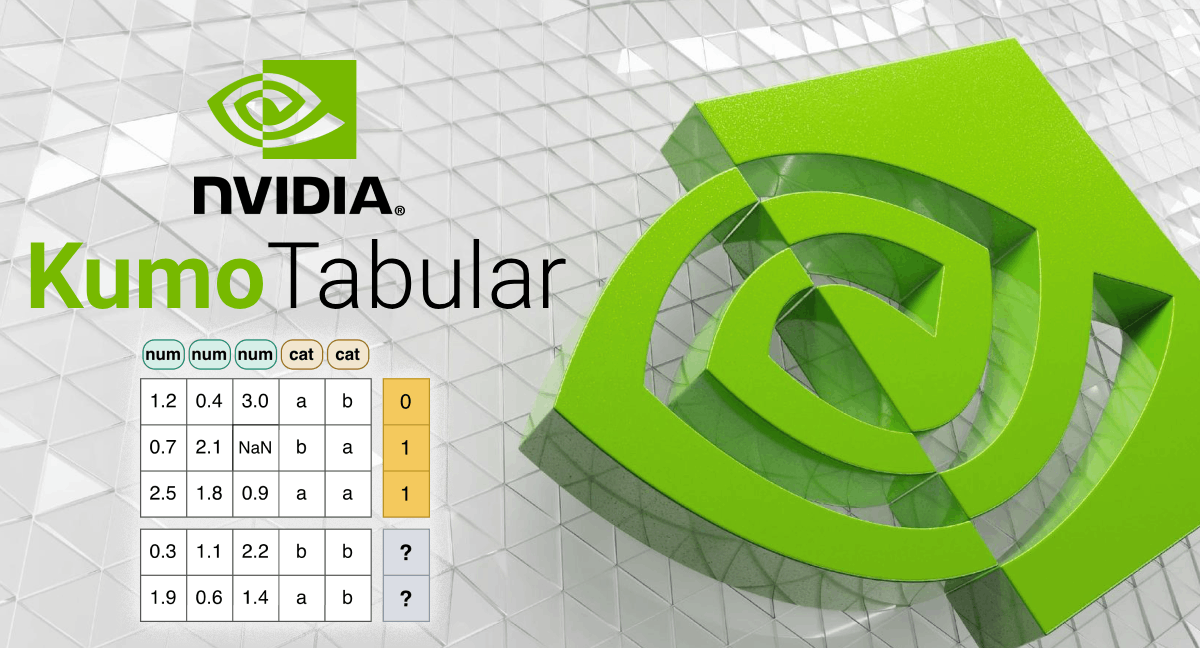
NVIDIA 发布了 Kumo Tabular,一个面向表格数据的开源基础模型,隶属 Kumo Structured 模型系列,权重已上架 Hugging Face。给定一张带标签的行表,它能在一次前向传播中预测新行的标签,无需训练、微调或特征工程,同时支持分类与回归。模型只使用人工数据预训练,提供 28M、215M 等三种规模,代码经开源库 structured-data-models 运行,采用 OpenMDW-1.1 许可,可商用。官方称它在 TabArena、BeyondArena、TALENT、ScoringBench 四个基准上排名第一。
与梯度提升树相比,它的工作方式更像大语言模型的上下文学习:预训练见过的数百万张表,让模型把带标签的表直接当作上下文,对新行输出预测。结构上,Kumo Tabular 是围绕表结构设计的 Transformer,融合了 TabICL 与 TabPFN 中提出的列注意力、行注意力与上下文注意力。单元格先被切成 token,数值与类别特征经傅里叶特征编码,缺失值无需插补,单独处理;上下文中的每个 token 还会拼上标签嵌入。随后通过交替的列注意力与行注意力将每行压缩成行嵌入:列注意力沿单列看值的分布,行注意力看列间交互,四个可学习的 [CLS] token 作为行读出。最后的 Transformer 只处理行嵌入,上下文行相互关注,查询行只关注上下文,因此预测不依赖同批的其他查询行,上下文键值可复用。查询侧用 Test-GQA 缩小缓存。分类头输出类别概率,回归头输出 999 个分位数,从而得到点预测与不确定性。
训练阶段全部在人工生成的表上进行。每张表从结构因果模型(SCM)中采样:先抽表配置,再随机生成因果图和每个节点的函数,部分节点成为数值或类别列,一个节点成为目标,其余保持隐藏;后处理加入列相关性、离群点裁剪和缺失值注入,最后用树集成快速检查表是否包含可学习信号。生成器是过程式采样器,因此可以无限产生新表。为了逼近真实脏数据,生成器还加入了多种缺失模式、粗化特征(导致重复行标签不一致)、多水平类别列和重尾回归目标。分类与回归作为两个独立模型分开训练,分三阶段:第一阶段用 1024 行、最多 100 列的表;第二阶段把上下文长度变到 400 至 10240 行;第三阶段扩展到 60000 行。三种规模分别见过约 3500 万、7100 万、1.37 亿张人工表。
性能方面,官方用默认设置跑满 TabArena 榜单,对比对象包括调过参的梯度提升树、AutoGluon 和最新表格基础模型。Kumo Tabular 以 ELO 1950 排名第一,并在统一单卡 RTX 6000 Pro 评估下比 LimiX-2 快 17 倍,在精度-效率帕累托前沿上全面占优。BeyondArena 上它拿到 ELO 1418,Improvability 分数 7.78%,同样排第一。TALENT 榜单上,它在分类准确率、分类对数损失、回归 RMSE 三项的平均排名分别为 6.67、3.98、4.22,整体第一。ScoringBench 上,Large 和 Medium 分列平均排名第一、第二。
使用上,Kumo Tabular 只直接处理数值和类别列,文本、图像、时间戳需通过内置预处理转为特征;单次前向传播最多覆盖 10 个类别,库用纠错输出码扩展到任意类别。官方也承认,当表远超训练分布范围、或查询行与上下文行分布不一致时,精度可能下降,并建议用户在自有留出数据上验证后再部署。代码在 GitHub,权重在 Hugging Face,训练配方与人工数据生成器后续也会放出。