GKE 新增原生缩容至零能力
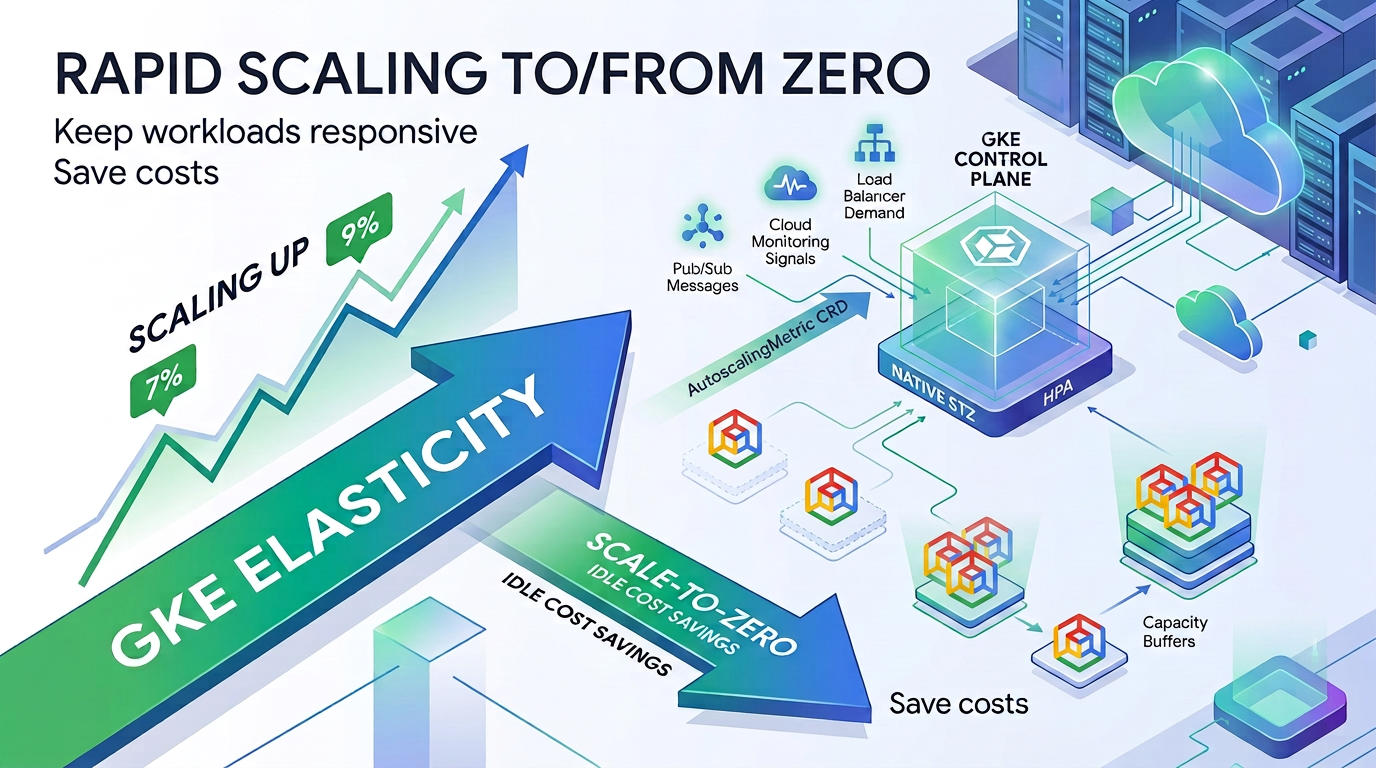
Google 在 GKE 1.37 中引入了原生的 scale-to-zero(缩容至零)能力,让间歇性运行的工作负载(如批处理、事件驱动任务、开发环境)在空闲时完全停止消耗计算资源,需要时再快速恢复。过去这类场景通常依赖 KEDA 这类额外组件,但 KEDA 需要管理 ScaledObject CRD 和 operator,大规模部署时 YAML 配置可超过一万行,且轮询机制会带来冷启动延迟。GKE 将 scale-to-zero 直接内置到控制平面,消除了附加组件和大量配置,把逻辑从“旁车管理”变成工作负载的原生属性。
核心实现基于两个组件:一是 HPA 的 AutoscalingMetric,它是一条托管指标信号管道,可直接读取 Google Cloud Managed Service for Prometheus、Pub/Sub、Cloud Monitoring 或 Load Balancer 的指标,无需第三方 adapter;二是 KEP-2021 标准,它让 HPA 支持 minReplicas: 0,当指标低于阈值时停止所有 Pod,当指标显示有任务时又能自动“唤醒”工作负载。配置过程只需两个对象:一个 AutoscalingMetric CRD 定义指标来源,一个设置 minReplicas: 0 的 HPA。
冷启动是 scale-from-zero 的最大挑战——以往新节点启动需要 60-90 秒。GKE 用容量缓冲区(capacity buffers)解决:维护一小部分预热计算资源,供多个缩容至零的工作负载共享。当 HPA 从 0 跳到 1 时,Pod 可以立即申请到资源,把启动延迟从分钟级降到瞬间。容量缓冲分 active 和 standby 两种:active 缓冲区可服务数百个缩容到零的工作负载,充当整个集群的通配容量;standby 缓冲区成本远低于 active,在持续负载时快速补充 active。两者结合实现即时扩缩容同时保持低成本。
Google 表示后续还会扩展弹性能力,例如让开发环境在晚上 8 点缩到零、早上 7 点自动恢复,提供对周期性扩缩容窗口的更精细控制。对于事件驱动和间歇性工作负载,原生 scale-to-zero 能显著降低闲置资源费用,同时不牺牲启动性能。