PrismML 用极小模型挑战大模型范式
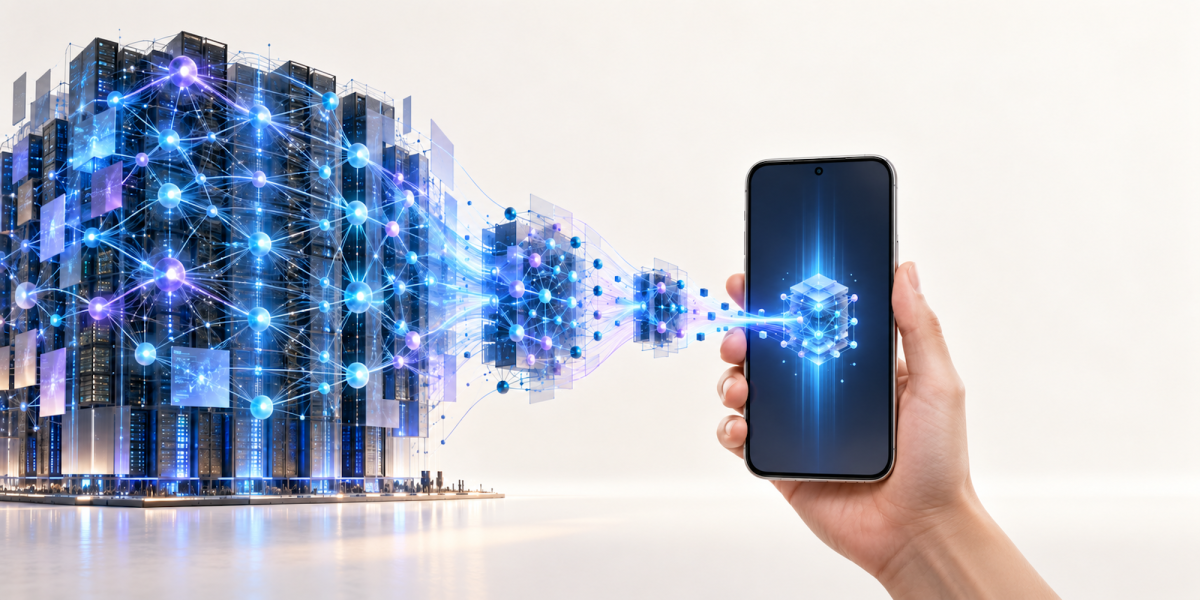
AI 实验室 PrismML 日前发布 Bonsai 2 27B,这是其模型家族的最新成员。该模型把阿里开源模型 Qwen3.8 27B 压缩到 5.9 GB,体积约为原来的 1/9 到 1/10,小到可以装进 PC,甚至可能运行在高端智能手机上。PrismML 由加州理工学院(Caltech)的研究人员创立,CEO Babak Hassibi 是 Caltech 教授,长期研究压缩技术。公司目前只完成了一轮 2250 万美元的种子融资,投资方包括 Khosla Ventures、Cerberus Capital 和 Caltech。Databricks 联合创始人、伯克利 Sky Computing Lab 主任 Ion Stoica 担任顾问。
PrismML 的核心思路是:高性能推理模型不一定非得很大。它通过压缩模型权重来缩小体积。通常每个权重需要 16 位存储,PrismML 采用所谓“三元权重”(ternary weights)方法,把每个权重的取值简化为 +1、-1 或 0 三种状态,从而大幅减少存储空间。项目细节在其 GitHub 页面公开。
关键在于压缩后的性能损失。PrismML 称 Bonsai 2 在综合基准测试中能达到 Qwen 原始模型 98% 的分数,高于 3 月发布的初代 Bonsai 的 95%。初代模型已被下载超过 1100 万次,PrismML 更小尺寸的模型另有 260 万次下载。Hassibi 承认压缩总会带来一些影响,但他认为基准测试的完美对齐意义有限——未压缩的 LLM 本身并非绝对准确,基准测试也不能完全反映真实任务,2% 的差距未必会在实际使用中造成明显差异。
PrismML 的下一步是把压缩技术应用到更大的模型上。Hassibi 表示,未来几个月内计划发布数千亿参数规模的模型,而且模型越大,压缩时保留智能的余地越大,越容易接近 100% 的性能对齐。Stoica 看好这项技术的终端价值:先进模型跑在用户自己的设备上,无需上传云端,既免费又私密。
LLM 压缩并非 PrismML 独家方向,Multiverse Computing 等公司也在做类似工作。PrismML 的差异化主张在于压缩后性能几乎不损失。目前尚不清楚 Bonsai 2 是否能达到 100% 的基准对齐,Hassibi 对此也持保留态度。