LFM2.5-VL-3B:为边缘端提供更强更快的视觉能力
LFM2.5-VL-3B 是 Liquid AI 最新发布的视觉语言模型,参数规模 3.1B,可在自有硬件上运行。它直接给出答案而不进行逐步推理,以换取实时场景下的低延迟。相比前代 LFM2-VL-3B,主要改进有四项:屏幕与 UI 理解、自然语言查询的目标定位与检测、多图像输入、以及文本与视觉条件下的函数调用。
模型采用 SigLIP2 400M NaFlex 视觉编码器,搭配 LFM2.5-2.6B 文本模型同款骨干。预训练数据约 34T tokens,其中视觉数据量为此前 4 倍,涵盖精选与合成的图像-字幕、OCR、定位、指令跟随数据集。为支持非拉丁文字,词表翻倍至 128K,采用原地扩展而非从头训练。后训练分两阶段:先做监督微调,包括从更大教师模型进行知识蒸馏和 Antidoom 训练;再做多奖励强化学习。
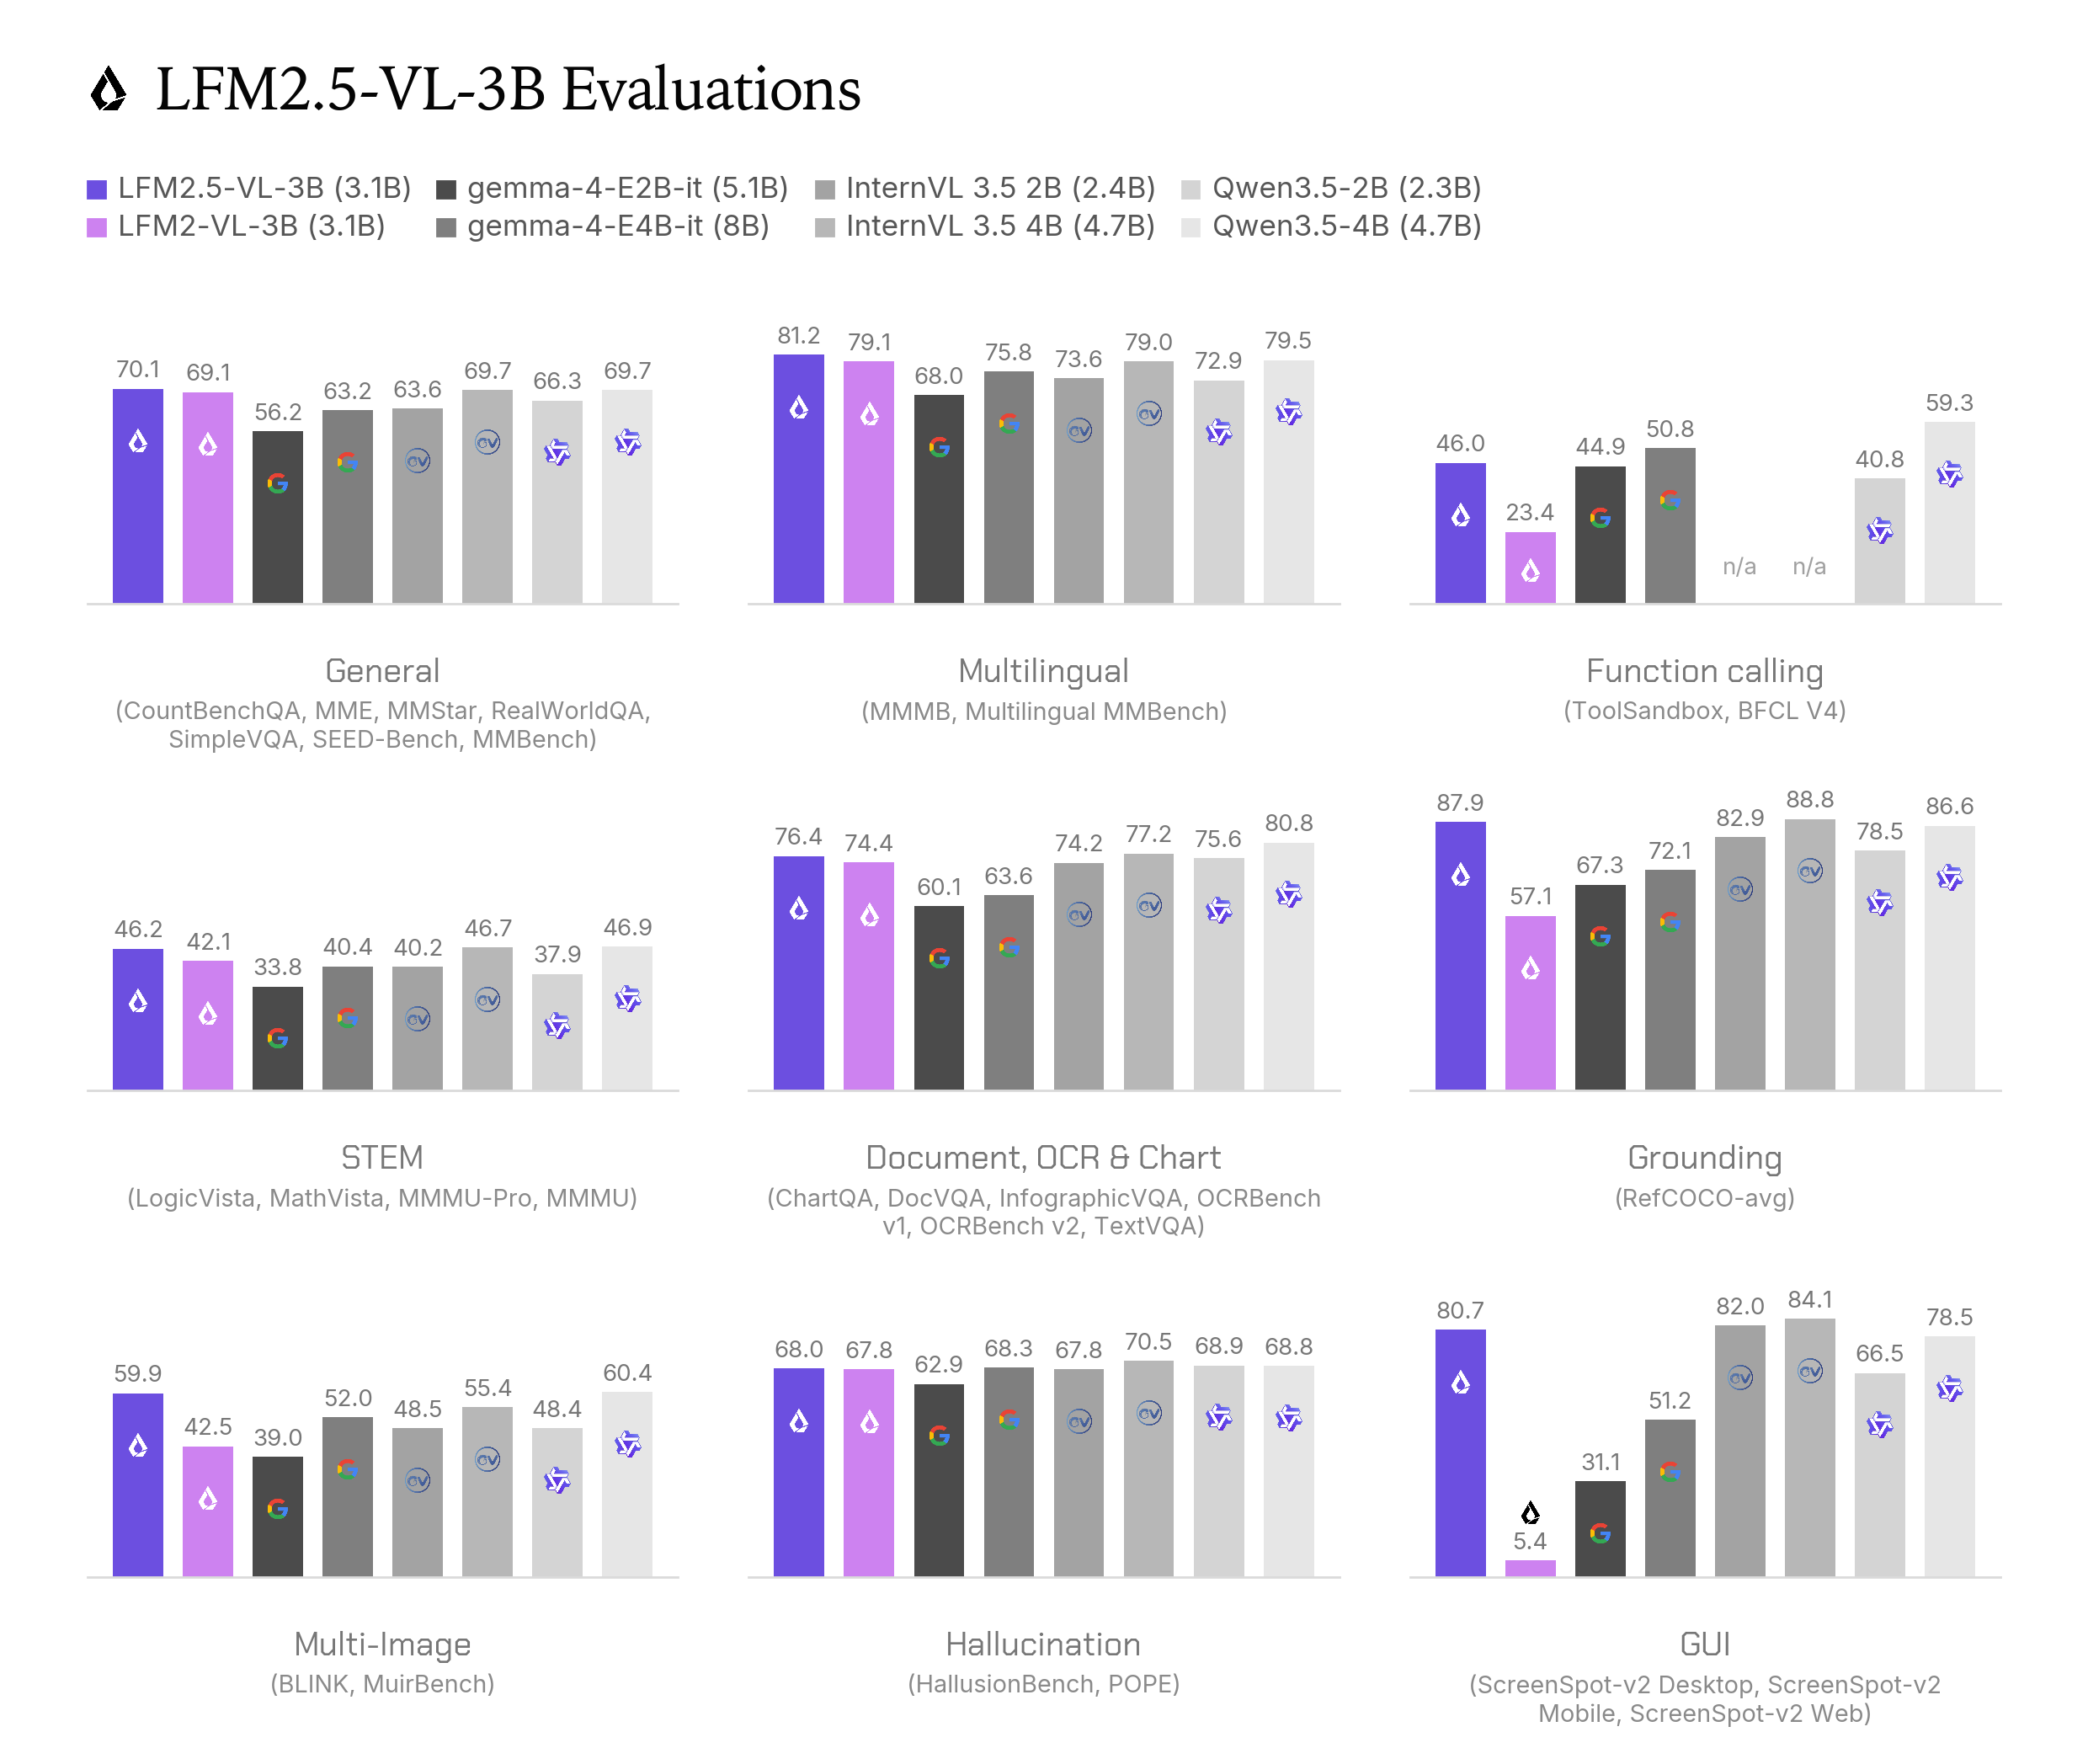
在视觉基准上,LFM2.5-VL-3B 在多项任务中领先同尺寸级别:MMStar 63.3、RealWorldQA 73.1、ChartQA 81.3、DocVQA 91.1。相比前代,目标定位提升显著,RefCOCO-avg 从 57.1 升至 87.9;屏幕理解进步更大,ScreenSpot-v2 Desktop 从 6.0 升至 78.7,Mobile 从 7.6 升至 81.2,Web 从 2.5 升至 82.2。多图像理解 BLINK 61.5、MuirBench 58.3。文本-only 测试中,IFEval 82.3,工具使用 ToolSandbox 从 26.4 升至 59.5、BFCL V4 32.5,与 Gemma-4-E2B 和 Qwen3.5-2B 相当。评估统一用 vLLM 0.26.0,采用非推理模式。
推理速度是另一大亮点。端侧解码速度在 M5 Max 上达到 228 tokens/s,在 Ryzen AI Max+ 395 上为 116 tokens/s,内存占约 3GB;Galaxy S26 Ultra 上也能跑到 20 tokens/s。GPU 高并发下输出吞吐约 11K tokens/s,约为 4B 级模型的 2 倍,也超过 2B 级模型,单块 H100 一天可产出近 1B tokens。
发布当日即支持 llama.cpp、MLX、vLLM、SGLang、ONNX 等推理生态。官方提供 transformers 示例(需 transformers>=5.10.1),也有浏览器 WebGPU demo。Hugging Face 已开放下载。
该模型定位高吞吐、端侧场景,适合文档解析、屏幕理解、目标检测和工具调用等应用。由于采用直接回答而非推理模式,复杂多步推理并非其长项,但原文未展开局限讨论。